Willkommen in der dsyr.DataBridge-Dokumentation. Hier findest du alles,
was du für Einrichtung, Konfiguration und Betrieb einer DataBridge-Instanz benötigst.
Überblick
Neu hier? Starte mit dem konzeptuellen Einstieg.
Wie es funktioniert
Der Datenfluss in fünf Schritten — verständlich ohne technischen Ballast.
Die Versionsangaben sind getestete Mindestversionen; im Code findet keine Versionsprüfung statt.
⚠️ = nur ungefiltertes Vollauslesen — Details auf der jeweiligen Konnektorseite.
MCP-Server
Eingebauter, read-only MCP-Server für KI-Assistenten wie
Claude Code: Jobs, Mappings, Service-Bus-Queues und echte Connector-Schemas (D365BC/NAV/CE,
OpenAPI und die SQL-Connectoren) zum Validieren von Mappings.
Änderungen, neue Features und Breaking Changes je Release:
→ Versionshistorie
1 - Überblick
Was die dsyr.DataBridge ist, wie sie funktioniert und wie sie technisch aufgebaut ist.
Dieses Kapitel erklärt die dsyr.DataBridge auf zwei Ebenen: konzeptuell für alle, die
verstehen wollen wie die Synchronisation abläuft — und technisch für diejenigen, die
den genauen Aufbau der Komponenten kennen möchten.
Der Datenfluss der dsyr.DataBridge in fünf Schritten — verständlich erklärt ohne technischen Ballast.
Das Grundprinzip
Die dsyr.DataBridge arbeitet wie ein kontinuierlicher Datenstrom zwischen zwei Systemen.
Sie fragt regelmäßig: „Was hat sich seit dem letzten Mal geändert?" — und überträgt
genau diese Änderungen ins Zielsystem. Nichts mehr, nichts weniger.
Kein manueller Export. Kein Doppelpflegen. Keine Vollsynchronisation, die alles neu
schreibt. Nur die Differenz, automatisch, im Minutentakt.
Der Datenfluss in fünf Schritten
flowchart LR
    A([Quelldaten<br/>ändern sich]) -->|"alle 15 Sekunden<br/>prüfen"| B[DataBridge<br/>erkennt Änderung]
    B -->|"Datensätze<br/>puffern"| C[(Service Bus<br/>Queue)]
    C -->|"Nachricht<br/>verarbeiten"| D[Felder<br/>mappen & wandeln]
    D -->|"schreiben"| E([Zielsystem<br/>aktualisiert])
    E -->|"Stand merken"| F[(Watermark<br/>gespeichert)]
    F -.->|"nächster Lauf<br/>startet hier"| B

    style A fill:#e8f5f1,stroke:#18b28d,color:#111111
    style E fill:#e8f5f1,stroke:#18b28d,color:#111111
    style C fill:#fff3e0,stroke:#f57c00,color:#111111
    style F fill:#e3f2fd,stroke:#1565c0,color:#111111
Schritt 1 — Änderungen erkennen
Alle 15 Sekunden (konfigurierbar über GetChangesTimerExpression) startet ein Timer. Die DataBridge fragt das Quellsystem:
„Gib mir alle Datensätze, die seit meinem letzten Stand geändert wurden."
Dafür nutzt sie den gespeicherten Watermark — einen Zeitstempel oder einen
Änderungstoken, der beim letzten erfolgreichen Lauf hinterlegt wurde.
Schritt 2 — Änderungen puffern
Gefundene Datensätze landen nicht sofort im Zielsystem, sondern zunächst in einer
Azure Service Bus Queue. Das entkoppelt Erkennung und Verarbeitung: Selbst wenn das
Zielsystem kurz nicht erreichbar ist, gehen keine Daten verloren. Die Queue speichert
die Nachrichten bis zur erfolgreichen Verarbeitung.
Schritt 3 — Felder mappen und wandeln
Jede Nachricht aus der Queue wird einzeln verarbeitet. Die DataBridge liest die
konfigurierten Mappings und weiß: Quellfeld A geht in Zielfeld B, Wert X wird
zu Wert Y übersetzt, ein fehlendes Feld bekommt einen Standardwert.
Dieser Schritt ist vollständig konfigurierbar — ohne Programmierung.
Schritt 4 — Ins Zielsystem schreiben
Der gemappte Datensatz wird ins Zielsystem geschrieben. Die DataBridge prüft dabei
anhand eines konfigurierten Schlüssels, ob der Datensatz dort bereits existiert:
Existiert: Update des vorhandenen Datensatzes
Existiert nicht: Neuanlage
Schritt 5 — Watermark aktualisieren
Nach erfolgreichem Durchlauf speichert die DataBridge den neuen Stand als Watermark.
Beim nächsten Timer-Aufruf dient dieser Wert als Startpunkt — so werden Datensätze
weder doppelt übertragen noch übersprungen.
Bidirektionale Synchronisation
Die fünf Schritte gelten für eine Richtung der Synchronisation. Wenn Daten in
beide Richtungen fließen sollen (z. B. BC → Dataverse und Dataverse → BC), werden
zwei unabhängige Jobs konfiguriert — jeder mit eigenem Quell- und Zielsystem,
eigenem Mapping und eigenem Watermark.
Prioritäten und Parallelverarbeitung
Nicht alle Datensätze sind gleich wichtig. Die DataBridge kennt drei Prioritätsstufen:
Priorität
Typischer Einsatz
Hoch
Zeitkritische Stammdaten (z. B. Preise, Kundendaten)
Standard
Normale Synchronisation (Bestellungen, Kontakte)
Niedrig
Historische Daten, große Datenmengen ohne Zeitdruck
Nachrichten mit hoher Priorität werden bevorzugt verarbeitet, ohne dass niedrigere
Prioritäten blockiert werden.
Was passiert bei Fehlern?
Schlägt die Verarbeitung einer Nachricht fehl, gibt es mehrere Sicherheitsnetze:
Automatischer Wiederholungsversuch — die Nachricht wird nach kurzer Wartezeit
erneut verarbeitet (bis zu einer konfigurierten Maximalanzahl).
Transitive Queue — meldet das Zielsystem einen Konflikt (z. B. ein Duplikat),
wird die Nachricht in eine separate Queue abgelegt, damit sie den Hauptpfad nicht
blockiert. Dort wird sie nicht automatisch erneut verarbeitet, sondern bei Bedarf
manuell zurückgestellt.
Dead-Letter Queue — dauerhaft nicht verarbeitbare Nachrichten werden dort
gesammelt und können analysiert oder manuell re-queued werden.
In keinem dieser Fälle gehen Daten still verloren. Das Monitoring und die konfigurierbaren
Alerts informieren aktiv, wenn die Dead-Letter Queue Einträge enthält.
1.2 - Technische Architektur
C4-Modell (Context, Container, Component), Azure-Komponenten, Service-Schichten, Queue-Struktur und Connector-Hierarchie der dsyr.DataBridge.
Zielgruppe
Diese Seite richtet sich an Administratoren und technische Nutzer, die den internen
Aufbau der DataBridge verstehen oder Probleme diagnostizieren möchten.
Für einen konzeptuellen Einstieg siehe Wie es funktioniert.
Sequenzdiagramme, Bicep-Module, DI-Verdrahtung und Nachrichten-Schemata stehen in der
Entwickler-Dokumentation unter Architektur im Detail.
Azure-Komponenten
Die DataBridge besteht aus mehreren Azure-Diensten, die in einer gemeinsamen
Ressourcengruppe betrieben werden:
Komponente
Dienst
Rolle
Function App
Azure Functions (Isolated Worker, .NET 10)
Ausführungsumgebung für alle Funktionen
App Service Plan
Microsoft.Web/serverfarms
Compute-Plan: Y1 (Consumption, Standard) oder EP1–EP3 (Premium)
Logging, Telemetrie, Alerting; Traces und ausgehende Aufrufe werden gesampelt
Grafana-Dashboard
Microsoft.Dashboard/dashboards
Vorkonfiguriertes Betriebsdashboard im Application-Insights-Blade (seit v2.1, wird immer mitdeployt)
Metric Alerts + Action Group
Azure Monitor
Dead-Letter- und Queue-Längen-Alerts, optional über enableAlerts
Eigene Infrastruktur
Alle Komponenten laufen im **eigenen Azure-Abonnement** des Kunden. Die DataBridge nutzt
keinen geteilten Dienst im Datenpfad — Datenverkehr und Konfiguration verlassen das
Kunden-Abonnement nicht. Beim containerisierten Betrieb wird lediglich das Container-Image
aus der WYSA-Registry bezogen.
Architektur nach dem C4-Modell
Die folgenden drei Diagramme folgen dem C4-Modell (Context →
Container → Component) — von außen nach innen, jede Ebene zoomt weiter in die
DataBridge hinein.
Ebene 1 — System Context
Wer nutzt die DataBridge, und mit welchen Systemen tauscht sie Daten aus?
flowchart TB
    admin(["👤 Administrator"])
    ki(["🤖 KI-Assistent<br/><small>z. B. Claude Code</small>"])

    databridge["dsyr.DataBridge<br/><small>Synchronisiert Datensätze zwischen<br/>Quell- und Zielsystemen</small>"]

    bc["D365 Business Central<br/><small>ERP — Quelle/Ziel</small>"]
    ce["D365 CE / Dataverse<br/><small>CRM — Quelle/Ziel</small>"]
    nav["D365 NAV<br/><small>ERP — Quelle/Ziel</small>"]
    sql[("SQL-Datenbanken<br/><small>nur Quelle</small>")]
    rest["Beliebige REST-API<br/><small>über OpenAPI-Spec</small>"]

    admin -->|"konfiguriert, überwacht"| databridge
    ki -->|"MCP über HTTPS"| databridge
    databridge <-->|"OData v4, OAuth2/API-Key"| bc
    databridge <-->|"Dataverse SDK"| ce
    databridge <-->|"OData, Basic Auth"| nav
    databridge -->|"ADO.NET"| sql
    databridge <-->|"REST, aus Spec aufgelöst"| rest

    style databridge fill:#1565c0,color:#fff,stroke:#0d47a1,stroke-width:2
    style admin fill:#08427b,color:#fff,stroke:#052e56
    style ki fill:#08427b,color:#fff,stroke:#052e56
    style bc fill:#8b8b8b,color:#fff,stroke:#666
    style ce fill:#8b8b8b,color:#fff,stroke:#666
    style nav fill:#8b8b8b,color:#fff,stroke:#666
    style sql fill:#8b8b8b,color:#fff,stroke:#666
    style rest fill:#8b8b8b,color:#fff,stroke:#666
Notation
Dunkelblau = Personen, Blau = die DataBridge selbst, Grau = externe Systeme — dieselbe
Farbsprache wie im C4-Modell üblich, hier als Flowchart statt als
natives Mermaid-C4Context-Diagramm umgesetzt, weil dessen Layout-Engine bei mehr als
drei-vier Beziehungen zu überkreuzenden Linien neigt.
Ebene 2 — Container
Innerhalb des eigenen Azure-Abonnements des Kunden besteht die DataBridge aus fünf
Containern (im C4-Sinn: separat betreibbare/skalierbare Einheiten):
Das Grafana-Dashboard wird immer mitdeployt (seit v2.1). Metric Alerts + Action Group sind
zusätzlich optional über den Bicep-Parameter enableAlerts steuerbar und daher hier nicht
als eigener Container dargestellt — siehe Monitoring & Alerts.
Ebene 3 — Component
Innerhalb des Containers Function App sind die Funktionen (Trigger-Ebene) von der
Service-Schicht (Logik-Ebene) getrennt. Um das Diagramm lesbar zu halten, wird die
Service-Schicht hier als ein Component dargestellt und direkt im Anschluss
(Abschnitt Service-Schicht) sowie in der
Connector-Hierarchie weiter aufgeschlüsselt — das C4-Modell ist
für genau dieses schrittweise Hineinzoomen gedacht.
Alle Funktionen laufen in derselben Function App und teilen sich eine gemeinsame
Service-Schicht:
Funktion
Trigger
Aufgabe
GetChanges
Timer (konfigurierbar über GetChangesTimerExpression)
Fragt alle fälligen Quellsysteme nach Änderungen und schreibt Nachrichten in die Service Bus Queues
ProcessStandardQueueItems
Service Bus sbqexport
Verarbeitet Nachrichten mit Standard-Priorität
ProcessHighPriorityQueueItems
Service Bus sbqhighexport
Verarbeitet Nachrichten mit hoher Priorität
ProcessLowPriorityQueueItems
Service Bus sbqlowexport
Verarbeitet Nachrichten mit niedriger Priorität
ExecuteJob
HTTP POST
Führt einen einzelnen Job manuell und sofort aus
ExecuteHttpRequest
HTTP POST
Diagnose: führt eine ad-hoc HTTP-GET-Anfrage gegen eine beliebige URL aus, unabhängig von den konfigurierten Connectoren
GetInfo
HTTP GET
Gibt die Versionsnummer der Function App zurück
CheckList
HTTP GET
Diagnose: prüft Mappings gegen die Attribute der beteiligten Systeme
Validate
HTTP GET
Diagnose: validiert die hinterlegte Konfiguration
JobApi (GET /job, GET /job/{rowKey})
HTTP GET
Diagnose: gibt die eingelesene jobs-Konfiguration (alle bzw. ein einzelner Job) zurück
MappingApi (GET /mapping, GET /mapping/{name})
HTTP GET
Diagnose: gibt die eingelesene mappings-Konfiguration (alle bzw. ein einzelnes Mapping anhand seines Namens) zurück
McpApi (POST /mcp)
HTTP POST
Read-only MCP-Server für KI-Assistenten — bündelt Jobs/Mappings/Queues/Connector-Metadaten als Tools
Zusätzlich existiert eine optionale Durable-Orchestrierung als Alternative zum
Timer-Pfad (StartGetChangesOrchestration, GetChangesOrchestrator, GetChangesActivity
und die Durable Entity JobState). Sie wird ausschließlich per HTTP gestartet und ist im
Regelbetrieb nicht aktiv.
Alle Funktionen lassen sich einzeln per App-Setting deaktivieren
(AzureWebJobs.<Funktionsname>.Disabled), ohne die Function App neu zu deployen.
Ziel-Queues bei Konflikten im Zielsystem (HTTP 409 / Duplikat-Datensatz), damit die Nachricht den Hauptpfad nicht blockiert
sbqignored
Veraltete Nachrichten (Quelldatum < Zieldatum bei aktivem SkipOutdatedMessages)
Dead-Letter-Subqueue
Jede Queue besitzt eine eigene Dead-Letter-Subqueue (<queuename>/$deadletterqueue) für Nachrichten, die nach maxDeliveryCount Versuchen nicht verarbeitet werden konnten
Transitive- und Ignored-Queues werden nicht automatisch weiterverarbeitet
Auf sbqtransitive* und sbqignored liegt kein Trigger. Nachrichten werden dorthin
ausschließlich geschrieben und verbleiben dort bis zum Ablauf der Time-to-live (14 Tage).
Sie dienen der Isolation und der manuellen Analyse; ein Requeue erfolgt bei Bedarf über
das Werkzeug DeadLetterMover.
Schreibweise `sbqtransitivestandart`
Der Name der Standard-Transitive-Queue endet auf -standart. So wird sie vom Deployment
angelegt und so sucht die DataBridge sie — die Schreibweise darf nicht „korrigiert" werden.
Service-Schicht
Alle Funktionen teilen eine gemeinsame Service-Schicht. Die Services selbst sind
DI-Singletons; lazy und thread-sicher nachgeladen wird die Konfiguration beim ersten
Aufruf. Das folgende Diagramm zoomt gegenüber dem C4-Component-Diagramm oben gezielt auf
den InitializationService-Teilbaum und dessen Initialisierungsreihenfolge. InitializationService
(bis v2.3 CoreService) ist reduziert auf Initialisierung und Ready/Error-Zustand — er ist
kein Service-Locator: ProcessJobsForRetrievalInOrderService und ProcessQueueMessageService
werden von den Functions, die sie brauchen (GetChanges/ExecuteJob bzw. Process*QueueItems),
direkt injiziert, nicht über ihn geroutet:
flowchart TB
    IS["InitializationService<br/>Lazy Konfigurations-Laden<br/>thread-sicher"]

    IS --> STORE["StorageService<br/>Table-Storage-CRUD"]
    IS --> CONS["ConnectionService<br/>Verwaltet Connector-Instanzen<br/>je Connection-Name"]
    IS --> MS["MappingService<br/>Gruppiert FieldMappings<br/>je Mapping-Name"]
    IS --> JS["JobService<br/>Prüft Schedules<br/>validiert Job-Konfiguration"]
    IS --> CHK["CheckListService<br/>Diagnose"]

    PJRS["ProcessJobsForRetrievalInOrderService<br/>Erkennungs-Pfad"] --> WS["WatermarkService"]
    PJRS --> SBS["ServiceBusService"]
    PQS["ProcessQueueMessageService<br/>Verarbeitet einzelne<br/>Nachrichten End-to-End"] --> SBS
    PQS --> WS
    JS --> WS
    WS --> STORE

    style IS fill:#e8f5f1,stroke:#18b28d,color:#111111,stroke-width:2
Daneben stehen Querschnitts-Services, die nicht unter dem InitializationService-Teilbaum hängen:
SettingsService — liest App-Settings und Connection-Strings aus der Konfiguration
(nicht aus Table Storage)
MetricsService — sendet vorab aggregierte Custom Metrics an Application Insights
(z. B. ChangesDetected je Job)
McpToolService — bündelt die Tool-Logik hinter dem MCP-Server:
ruft JobService, MappingService, ServiceBusService und ConnectionService auf und
stößt darüber (wie JobApi/MappingApi) selbst einmalig InitializationService.EnsureInitializedAsync
an — hängt also nicht im InitializationService-Baum, sondern davor
Initialisierungsreihenfolge:
StorageService prüft die vier Tabellen und legt fehlende an
ConnectionService liest connections, deserialisiert die JSON-Verbindungsdaten und
führt je System einen Verbindungstest aus
MappingService liest mappings und gruppiert die Einträge nach Mapping-Name
JobService liest jobs und validiert sie: existieren Verbindungen und Mappings?
Ist die Cron-Expression gültig?
Schlägt ein Verbindungstest fehl, wird der Fehler protokolliert und der laufende Aufruf
mit einer Exception beendet. Die Initialisierung wird zurückgesetzt und beim nächsten
Timer-Aufruf bzw. bei der nächsten Queue-Nachricht erneut versucht (Self-Repair). Bei
Queue-Nachrichten bedeutet das: die Nachricht wird abandoned und zählt gegen
maxDeliveryCount.
Connector-Hierarchie
Detailansicht der Komponente Connector-Schicht aus dem C4-Component-Diagramm oben —
als UML-artiges Klassendiagramm, da C4 Vererbungshierarchien nicht sauber abbilden kann.
Jedes Quell- und Zielsystem wird durch einen Konnektor abstrahiert. Alle Konnektoren
implementieren dasselbe Interface und sind damit gegeneinander austauschbar:
Der Dataverse-Konnektor erbt direkt von ConnectorBase, nicht von HttpConnectorBase —
er kommuniziert über den Dataverse ServiceClient statt über einen eigenen HTTP-Client.
Für die Typumwandlung greifen zwei Bausteine ineinander:
TargetValueMapper — wählt anhand des Zielsystem-Metadatentyps (EDM bei BC/NAV,
AttributeMetadata bei Dataverse) den passenden Resolver aus. Existiert je Connector.
AttributeResolver — führt die eigentliche Typumwandlung durch (Boolean, Date,
DateTime, Decimal, Guid, Integer, String; bei Dataverse zusätzlich Picklist, Lookup,
Money, State/Status, MultiSelect). Liegt als Resolver-Familie je Systemtyp vor.
OpenApiConnector — Metadaten aus der Spezifikation statt fest verdrahtet
Anders als bei den übrigen HTTP-Konnektoren stammen Pfade, Wrapper-Schlüssel
({"clients":[...]} vs. {"client":{...}}) und Feldtypen beim OpenAPI-Konnektor nicht aus
connectorspezifischem Code, sondern werden zur Laufzeit aus einer OpenAPI-Spezifikation
(JSON oder YAML) aufgelöst und pro Prozess zwischengespeichert. Details:
Konnektoren → OpenAPI.
IConnector stellt zusätzlich GetTableMetadata(tableName, apiPath) bereit: liefert Typ,
Nullable, maximale Länge und Primary-Key-Information je Spalte direkt aus dem Zielsystem —
implementiert für alle Connector-Typen, seit v2.3 auch für die SQL-Familie. Dient vor allem dem
MCP-Server zur Validierung von Mappings gegen das echte Schema.
Änderungserkennung pro Connector-Typ
Die Methode, mit der Änderungen erkannt werden, unterscheidet sich je nach System:
Connector
Mechanismus
Watermark-Typ
D365BC
OData-$filter auf das im Job konfigurierte Feld WatermarkField (z. B. lastModifiedDateTime)
datetime
D365CE / Dataverse
Dataverse Change Tracking API (opaker Token)
string
D365NAV
OData-$filter auf das konfigurierte WatermarkField
datetime oder date
SQL-Datenbanken
SQL-WHERE-Klausel auf das konfigurierte WatermarkField
date oder datetime
OpenAPI
WatermarkField wird als JSON-Pfad auf jeden gelesenen Datensatz angewendet; Filter wird unverändert als Query-String an die API angehängt (API-abhängig)
datetime
Der Watermark-Wert wird pro Job in der Tabelle watermark gespeichert und am Ende der
Erkennungsphase fortgeschrieben. Ein manuelles Leeren des Watermarks erzwingt einen
vollständigen Neulauf des jeweiligen Jobs.
Über CRUD hinaus: Aktions-Jobs, job-eigene Pfade, eingebettete Kinder
Drei neuere Erweiterungen des Job-/Mapping-Modells betreffen nicht nur den OpenAPI-Konnektor,
sind dort aber am relevantesten:
InvokeAction — ein Job mit einem Action-Wert, der keinem bekannten JobActionType
entspricht, ruft statt eines CRUD-Vorgangs einen benannten, nicht-CRUD-Endpunkt auf (z. B.
einen OpenAPI-operationId oder ein CE-OrganizationRequest). Details:
Jobs → InvokeAction.
Job-eigene Source-/Target-Pfade — ein Job kann über Source/Target die
SourceTable/TargetTable seiner Mapping-Zeilen überschreiben (bzw. bei fehlendem Mapping
ein synthetisches Mapping erzeugen), sodass eine Mapping-Gruppe für mehrere Ressourcen oder
Aktionspfade wiederverwendet werden kann. Details:
Jobs → Source und Target.
EmbedChildren — bettet die Datensätze eines referenzierten Kind-Jobs bereits beim Lesen
in die Nachricht des Elterndatensatzes ein, sodass Eltern- und Kind-Datensätze gemeinsam als
eine Nachricht verarbeitet werden (derzeit nur mit D365CE als Quellsystem). Details:
Mappings → EmbedChildren.
Retry- und Fehlerverhalten
Szenario
Verhalten
Konflikt im Zielsystem (HTTP 409 / Duplikat)
Weiterleitung in die passende Transitive-Queue
Transientes Netzwerkproblem, Zielsystem temporär nicht erreichbar
Backoff (DeliveryCount² · 1000 ms), Abandon, erneute Zustellung nach Lock-Ablauf
Veraltete Nachricht (Quelle älter als Ziel)
Bei aktivem SkipOutdatedMessages: Weiterleitung in sbqignored
Maximale Zustellversuche überschritten
Weiterleitung in die Dead-Letter-Subqueue der jeweiligen Queue, Alert ausgelöst (wenn konfiguriert)
Initialisierungsfehler (Verbindung)
Fehler wird geloggt, laufender Aufruf bricht ab, nächster Aufruf versucht erneut
2 - Einrichtung
Von null zur laufenden DataBridge-Instanz: Voraussetzungen, Installation und Konfiguration der Umgebung.
Dieses Kapitel führt Schritt für Schritt durch die erstmalige Einrichtung einer
dsyr.DataBridge-Instanz. Am Ende steht eine vollständig deployete und konfigurierte
Azure Function App, die synchronisieren kann.
Ergänzend, außerhalb des regulären Installationswegs:
Container-Betrieb — Betrieb als Container-Image. Beta,
nicht für den Kundenbetrieb vorgesehen.
2.1 - Voraussetzungen
Benutzerkonten, Berechtigungen, Azure-Provider und Software, die vor der Installation bereitstehen müssen.
Bevor die DataBridge installiert werden kann, müssen die folgenden Voraussetzungen
in Azure, Dataverse und Business Central erfüllt sein.
Azure-Abonnement
Ein aktives Azure-Abonnement ist Pflicht. Im Abonnement müssen die folgenden
Resource Provider registriert sein:
Provider
Zweck
Pflicht
Microsoft.Insights
Application Insights
✅
Microsoft.OperationalInsights
Log Analytics
✅
Microsoft.ServiceBus
Service Bus Namespace
✅
Microsoft.Storage
Table Storage, Blob Storage
✅
Microsoft.Web
Azure Function App
✅
Microsoft.Dashboard
Grafana-Dashboard in Application Insights
✅
Microsoft.KeyVault
Sichere Speicherung von Connection Strings
optional
Microsoft.Relay
Hybrid Connections (OnPremise-Anbindung)
optional
Microsoft.App
Container Apps
veraltet / deprecated
Provider können im Azure Portal unter Abonnement → Ressourcenanbieter aktiviert werden.
`Microsoft.Dashboard` ist seit v2.1 erforderlich
Das Grafana-Dashboard wird bei jedem Deployment
angelegt — ohne Möglichkeit, es abzuwählen. Ist der Provider nicht registriert, schlägt
das gesamte Deployment fehl.
Empfohlene Instanzen-Struktur
Pro Umgebung wird eine eigene DataBridge-Instanz (= Ressourcengruppe) benötigt.
Als Regelfall werden zwei Instanzen empfohlen:
Instanz
Zweck
Test
Validierung von Mappings und Konfigurationsänderungen
Produktion
Liveverbindung zwischen den Produktivsystemen
Eine Entwicklungsinstanz ist meist nicht nötig, da die Entwicklung der DataBridge selbst
bei WYSA liegt und sich eine Synchronisation im Entwicklungssystem selten lohnt.
Eine dritte Instanz für Entwicklung ist dann sinnvoll, wenn im Entwicklungssystem
eigene Anpassungen an Dataverse oder Business Central entstehen, die vor dem Test
gegen eine laufende Synchronisation geprüft werden sollen — etwa neue Felder, geänderte
Optionssets oder umgebaute Entitäten. In diesem Fall werden drei Ressourcengruppen
benötigt (Entwicklung, Test, Produktion).
Laufzeitumgebung
Die DataBridge läuft als Azure Function App. Die folgenden Eckdaten werden vom Deployment
gesetzt und müssen nicht vorbereitet werden — sie sind hier als Referenz für die
Abstimmung mit der IT aufgeführt:
Merkmal
Wert
Laufzeit
.NET 10, Isolated Worker
Azure Functions Runtime
v4
Betriebssystem
Windows
App Service Plan
Y1 (Consumption) oder EP1–EP3 (Premium), wählbar beim Deployment
Beim containerisierten Betrieb wird zusätzlich Zugriff auf die WYSA-Container-Registry
benötigt. Das aktuelle Image ist
acrwysatest.azurecr.io/containered-connector:v2.3.0.
Unterstützte Quell- und Zielsysteme
System
Lesen
Schreiben
Anmerkung
Dynamics 365 Business Central
✅
✅
Cloud und OnPremise
Dynamics 365 / Dataverse
✅
✅
Change Tracking erforderlich (siehe unten)
Microsoft Dynamics NAV
✅
✅
OnPremise, wahlweise Basic Auth oder NTLM
Microsoft SQL Server
⚠️ Preview
—
MySQL / MariaDB
⚠️ Preview
—
Oracle Database
⚠️ Preview
—
PostgreSQL
⚠️ Preview
—
Für die vier SQL-Systeme gelten die unten beschriebenen Anforderungen an Anwendungsbenutzer
und Change Tracking nicht — dort werden lediglich ein Connection String und die
Netzwerkerreichbarkeit aus Azure heraus benötigt. Die Konnektoren sind als Vorabversion
eingestuft und unterstützen kein Schreiben; Details auf den
Konnektor-Seiten.
Benutzerkonten
Die folgenden Anforderungen gelten für die Anbindung von Dataverse und Business
Central. Für SQL-Quellsysteme genügt ein Datenbankbenutzer mit Leserechten.
Für die Einrichtung und Pflege von Dataverse und Business Central wird ein menschlicher
Benutzer benötigt, der in Entra ID existiert und entsprechend lizensiert ist.
System
Mindestrechte
Dataverse
Rolle „Systemadministrator" + mindestens eine Power Platform-Lizenz
Business Central
Administrationsrechte + BC-Lizenz zugewiesen
Anwendungsbenutzer (Service Principal / App Registration)
Anwendungsbenutzer ermöglichen der DataBridge den automatisierten, sicheren Zugriff
auf die Systeme — ohne personengebundene Credentials.
Minimum: 1 Anwendungsbenutzer pro DataBridge-Instanz.
Empfehlung: 3 Anwendungsbenutzer für maximale Sicherheit und klare Trennung:
Anwendungsbenutzer
Zweck
Benötigte Rechte
Deployment-User
Installation und Updates der DataBridge
Azure: Contributor auf Ressourcengruppe (bei aktiviertem enableManagedIdentity: Owner oder User Access Administrator, da Rollen zugewiesen werden) · Dataverse: S2S-Benutzer + Systemadministrator
Dataverse-User
Datenaustausch mit Dataverse im laufenden Betrieb
Dataverse: S2S-Benutzer + Systemadministrator oder individuelle Sicherheitsrolle
BC-User
Datenaustausch mit Business Central im laufenden Betrieb
BC: Registriert + individuelle Sicherheitsrolle
Alle Anwendungsbenutzer müssen als App Registration in Entra ID angelegt und in
den jeweiligen Systemen als S2S-Benutzer registriert sein.
Dataverse: Change Tracking aktivieren
Für alle Dataverse-Tabellen, die als Quelle genutzt werden sollen, muss
Change Tracking aktiviert sein. Ohne Change Tracking kann die DataBridge keine
effizienten Differenzabfragen durchführen.
Aktivierung: Power Platform Admin Center → Umgebung → Tabellen → Tabelle auswählen →
Eigenschaften → „Änderungsnachverfolgung aktivieren" ✅
Benötigte Software für die Installation
Bei Installation über den Azure Marketplace entfällt dieser Abschnitt
Wird die DataBridge über den Marketplace-Assistenten installiert, ist keine lokale
Software erforderlich — die Einrichtung läuft vollständig im Azure Portal.
Für das Deployment per Bicep / Azure CLI muss auf dem ausführenden Rechner
installiert sein:
az bicep install
az bicep version   # Ausgabe sollte ≥ 0.35 zeigen
Die Installation selbst kann durch WYSA durchgeführt werden, sofern der
Deployment-Anwendungsbenutzer mit Contributor-Rechten auf der Ressourcengruppe
bereitgestellt wurde. Soll der Preview-Schalter enableManagedIdentity genutzt werden,
benötigt der Deployment-User Owner oder User Access Administrator, da dabei
Rollenzuweisungen angelegt werden.
2.2 - Installation
Die DataBridge über den Azure Marketplace oder per Bicep in Azure einrichten.
Automatisierte oder wiederholbare Deployments, Integration in eine Pipeline.
Beide Wege legen dieselben Ressourcen an und sind gleichwertig im Ergebnis.
Weg 1 — Azure Marketplace (empfohlen)
1. Ressourcengruppe anlegen
Im Azure Portal eine neue Ressourcengruppe für die DataBridge-Instanz erstellen.
Pro Umgebung (Test, Produktion) wird eine eigene Ressourcengruppe verwendet.
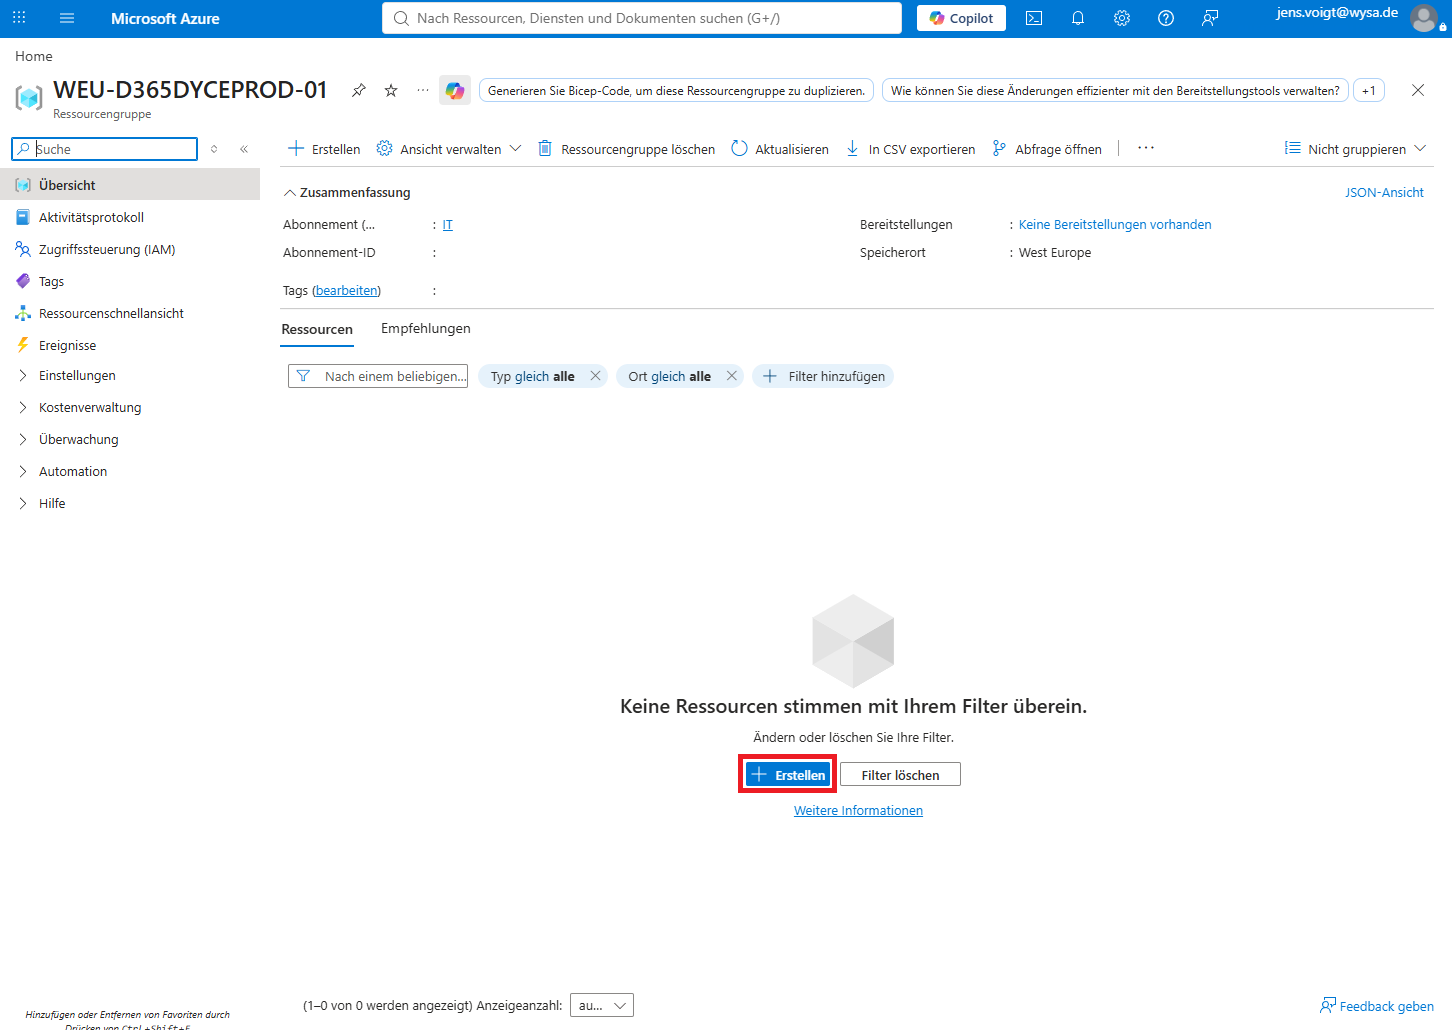
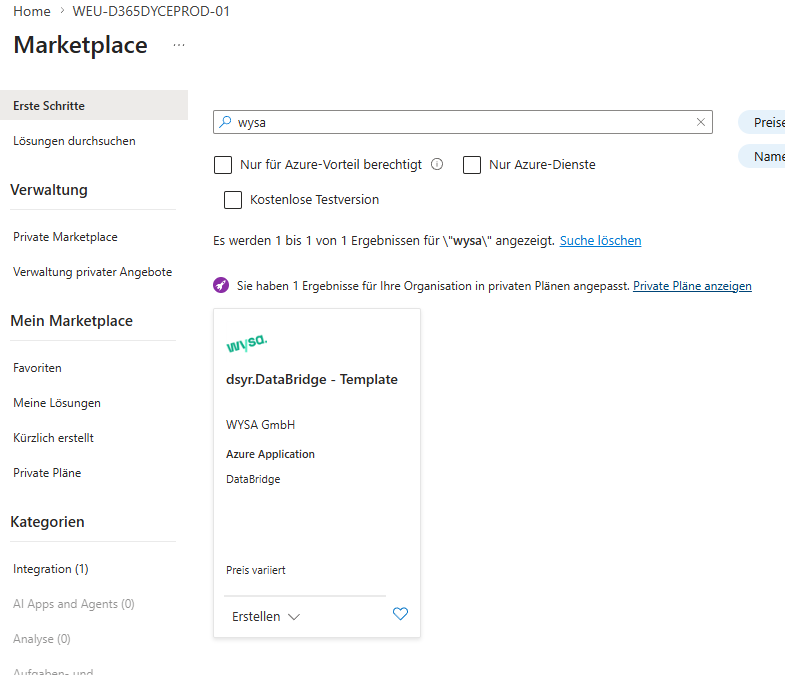
2. DataBridge aus dem Marketplace auswählen
In der Ressourcengruppe Erstellen wählen und im Marketplace nach der
WYSA DataBridge suchen.
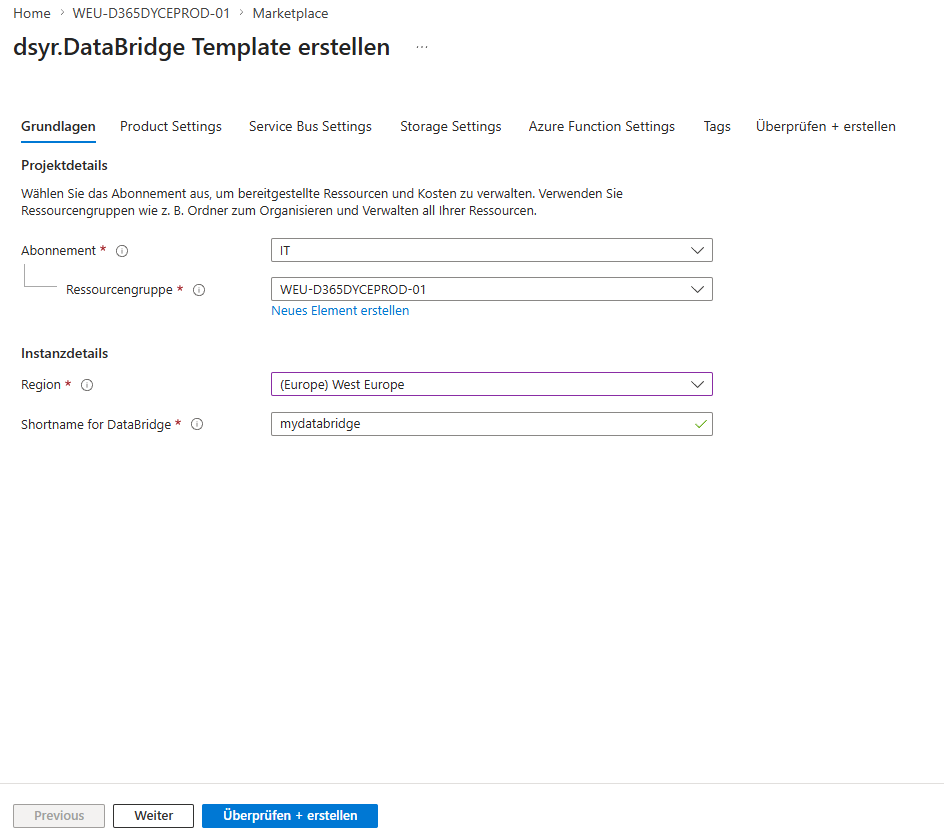
3. Region und Kurzname festlegen
Feld
Bedeutung
Region
Azure-Region, in der alle Ressourcen angelegt werden
Shortname for DataBridge
Namensbestandteil für alle Ressourcen dieser Instanz
Der Kurzname prägt alle Ressourcennamen
Aus dem Kurznamen werden sämtliche Ressourcennamen abgeleitet — Bindestriche werden dabei
intern entfernt:
Der Name muss innerhalb Azure eindeutig sein und sollte die Umgebung erkennbar machen
(z. B. kunde-databridge-test).
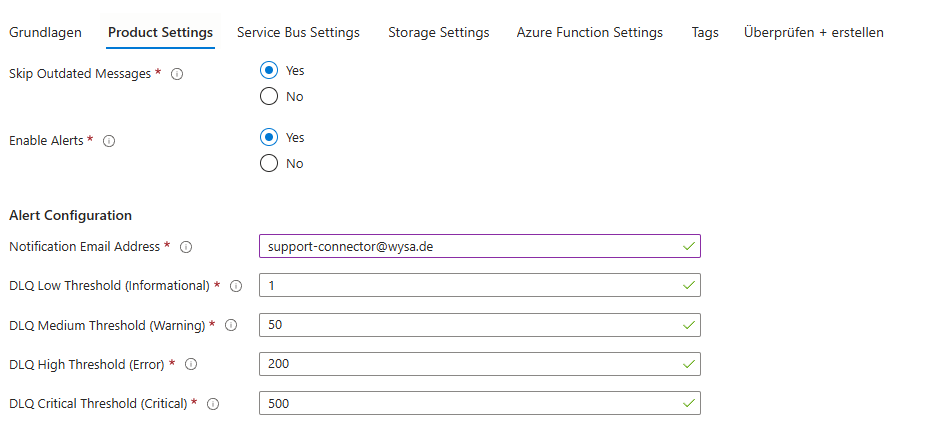
4. Produkteinstellungen
Unter Product Settings werden die fachlichen Einstellungen gruppiert:
Bereich
Einstellungen
Function Settings
GetChanges Timer Expression — Taktung des Quellabrufs (Vorgabe: alle 15 Sekunden)
Telemetry
Sampling-Override sowie die drei Sampling-Raten für Logs und Abhängigkeiten
Alert
Alerts aktivieren, Benachrichtigungs-E-Mail und die vier Dead-Letter-Schwellwerte
Preview
SkipOutdatedMessages
Alerts sind standardmäßig aus
Enable Alerts steht auf No. Wird es auf Yes gesetzt, ist zusätzlich eine
Benachrichtigungs-E-Mail einzutragen — sonst werden keine Alerts angelegt. Details:
Monitoring & Alerts.
Alle Telemetrie-Einstellungen können auf den Vorgabewerten bleiben und später jederzeit
in den Umgebungsvariablen angepasst werden.
5. Service Bus
Feld
Vorgabe
Bedeutung
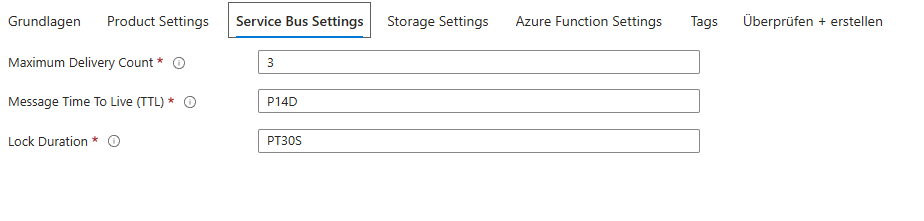
Maximum Delivery Count
3
Zustellversuche, bevor eine Nachricht in die Dead-Letter-Queue geht
Message Time To Live (TTL)
P14D
Aufbewahrungszeit einer Nachricht (ISO 8601)
Lock Duration
PT30S
Sperrdauer während der Verarbeitung
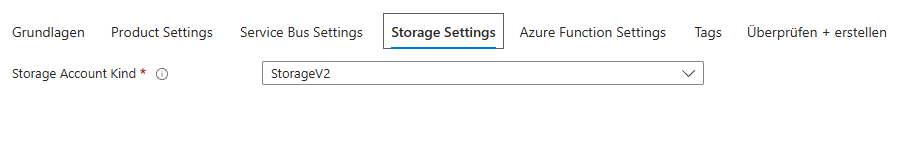
6. Storage Account
Als Speicherkonto-Typ steht ausschließlich StorageV2 zur Verfügung.
7. App Service Plan
Feld
Vorgabe
Bedeutung
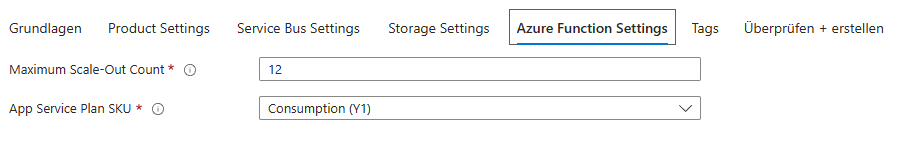
Maximum Scale-Out Count
12
Obergrenze für parallele Instanzen
App Service Plan SKU
Consumption (Y1)
Alternativ Premium (EP1) bis Premium (EP3)
Anschließend über Überprüfen und erstellen das Deployment starten.
Erneutes Durchlaufen bei einem Update
Der Assistent kann für ein Update erneut ausgeführt werden. Solange die Vorgabewerte
übernommen werden, ergibt sich keine Änderung an bestehenden Einstellungen.
Weg 2 — Bicep / Azure CLI
1. Bicep-Dateien bereitstellen
Die Bicep-Templates befinden sich im Repository unter bicep/. Klone das Repository
oder lade die Dateien auf den Rechner, von dem aus die Installation durchgeführt wird.
2. Bei Azure anmelden
az login
Es öffnet sich ein Browser-Fenster. Melde dich mit dem Deployment-Anwendungsbenutzer
oder dem Administrations-Benutzer an, der Contributor-Rechte auf der Ziel-Ressourcengruppe
hat. Den Haken bei „Zugriffseinwilligung für alle Benutzer" nicht setzen.
3. Abonnement prüfen
az account show
Vergleiche die angezeigte Abonnement-ID mit der ID im Azure Portal. Falls mehrere
Abonnements vorhanden sind, das richtige setzen:
az account set --subscription "<Abonnement-ID>"
4. Ressourcen deployen
az deployment group create --template-file ./bicep/main.bicep --resource-group <Name-der-Ressourcengruppe> --parameters name=<instanzname> -c
Das Flag -c zeigt eine Vorschau der Änderungen an. Mit Y oder J bestätigen.
Instanzname immer setzen
Der Parameter name wird als Namensbestandteil für alle angelegten Ressourcen
verwendet. Der Standardwert lautet customername-databridge und ist unbedingt zu
überschreiben — andernfalls kommt es zu Namenskonflikten mit anderen Installationen.
Bicep-Parameter im Überblick
Infrastruktur:
Parameter
Standardwert
Beschreibung
name
customername-databridge
Namensbestandteil für alle Ressourcen. Immer überschreiben.
location
Region der Ressourcengruppe
Zielregion für alle Ressourcen
storageKind
StorageV2
Speicherkonto-Typ (einziger erlaubter Wert)
appServiceSku
Y1
Y1 (Consumption) oder EP1–EP3 (Premium)
functionScaleLimit
12
Obergrenze für parallele Instanzen
maxDeliveryCount
3
Zustellversuche pro Nachricht (1–100)
defaultMessageTimeToLive
P14D
Aufbewahrungszeit für Nachrichten (ISO 8601)
lockDuration
PT30S
Sperrdauer während der Verarbeitung (ISO 8601)
tagsByResource
(leer)
Tags je Ressourcentyp
Laufzeit und Telemetrie:
Parameter
Standardwert
Beschreibung
getChangesTimerExpression
*/15 * * * * *
Taktung des Quellabrufs
skipOutdatedMessages
false
Nachrichten mit älterem Quell-Zeitstempel überspringen
telemetryControl
TRACE_SAMPLE
TRACE_SAMPLE, TRACE_ALL oder TRACE_NONE
telemetryInfoSampleRate
20
Anteil der Information-Einträge bei erfolgreichen Läufen (%)
Alerts für Dead-Letter-Queue und Queue-Länge anlegen
notificationEmail
(leer)
Empfänger der Alert-Benachrichtigungen. Nur bei enableAlerts = true erforderlich.
dlqLowThreshold
1
Schwellwert Severity „Informational"
dlqMediumThreshold
50
Schwellwert Severity „Warning"
dlqHighThreshold
200
Schwellwert Severity „Error"
dlqCriticalThreshold
500
Schwellwert Severity „Critical"
Parameter in einer Datei ablegen
Statt alle Werte auf der Kommandozeile zu übergeben, können sie in einer
.bicepparam-Datei gepflegt und mit --parameters <datei>.bicepparam übergeben werden.
Eine kommentierte Vorlage liegt unter bicep/params/databridge.sample.bicepparam.
Was angelegt wird
Nach erfolgreichem Deployment existieren in der Ressourcengruppe:
Der Name der Standard-Transitive-Queue endet auf -standart. So wird sie angelegt und so
sucht die DataBridge sie.
Table-Storage-Tabellen:connections, jobs, mappings, watermark — sie werden
vom Deployment leer angelegt.
Phase 2 — Function App befüllen
Beim Marketplace-Weg entfällt dieser Schritt in der Regel; das Paket wird mit ausgeliefert.
Beim Bicep-Weg wird der Anwendungscode separat eingespielt.
Option A: Container-Image
Wird die DataBridge containerisiert betrieben, verweist die Function App auf das
bereitgestellte Image:
Die bereitgestellte .zip-Datei per Drag & Drop hochladen
Nach dem Upload startet die Function App automatisch neu
Option C: Deployment-Pipeline
Das Deployment kann über eine CI/CD-Pipeline automatisiert werden.
WYSA stellt hierfür Azure-Pipeline-Definitionen zur Verfügung (cicd/-Verzeichnis).
Alternativ kann eine eigene Azure-DevOps- oder GitHub-Actions-Pipeline verwendet werden.
Nach der Installation: Konfigurationstabellen befüllen
Nach dem Deployment laufen die Azure Functions — aber noch ohne Konfiguration.
Die vier Table-Storage-Tabellen existieren, sind aber leer:
Reihenfolge
Tabelle
Inhalt
1
connections
Zugangsdaten für alle Quell- und Zielsysteme
2
mappings
Feld-Mappings zwischen Quell- und Zieltabellen
3
jobs
Synchronisations-Jobs (welche Tabelle, welche Richtung, welcher Schedule)
4
watermark
Wird zur Laufzeit automatisch befüllt — kein manueller Eintrag nötig
Die Tabellen können über den Azure Storage Explorer oder direkt im Azure Portal
(Storage Account → Tables) bearbeitet werden.
Details zu den Tabellen und den erwarteten Feldern sind im Kapitel
Konfiguration beschrieben.
Umgebungsvariablen prüfen
Alle Verbindungs-Strings sowie der Timer-Ausdruck und die Telemetrie-Einstellungen werden
vom Deployment gesetzt. Nachträglich anzupassen sind sie nur, wenn vom Vorgabewert
abgewichen werden soll.
Eine vollständige Übersicht findet sich auf der Seite
Umgebungsvariablen.
Installation prüfen
Sobald Konfigurationstabellen und Umgebungsvariablen gesetzt sind, kann die Installation
geprüft werden:
GET https://func-<name>.azurewebsites.net/api/GetInfo?code=<Function-Key>
Eine erfolgreiche Antwort sieht so aus:
{
"Version": "2.1.2026.802"}
Der Function-Key ist erforderlich
GetInfo ist mit Function-Level-Authentifizierung geschützt. Ohne den Parameter code
antwortet der Endpunkt mit 401 Unauthorized.
Den Schlüssel findet man im Azure Portal unter Function App → Funktionen → GetInfo →
Funktionsschlüssel.
Alternativ: Im Azure Portal → Function App → Funktionen → GetInfo → Testen/Ausführen —
dort wird der Schlüssel automatisch mitgegeben.
Für eine inhaltliche Prüfung der Konfiguration stehen zusätzlich die Diagnose-Funktionen
Validate (prüft die hinterlegte Konfiguration) und CheckList (gleicht Mappings gegen
die Attribute der beteiligten Systeme ab) zur Verfügung.
2.3 - Umgebungsvariablen
Alle Konfigurationsparameter der DataBridge Function App — mit Standardwerten und Erläuterung.
Die DataBridge Function App wird über Anwendungseinstellungen (Application Settings)
konfiguriert. Diese sind im Azure Portal unter Function App → Einstellungen →
Umgebungsvariablen zu finden und zu bearbeiten.
Seit v2.1 bereits beim Deployment setzbar
Der Timer-Ausdruck und alle vier Telemetrie-Einstellungen lassen sich direkt beim
Deployment vorgeben — als Bicep-Parameter (Beispiele in
bicep/params/databridge.sample.bicepparam) oder im Marketplace-Assistenten unter
Product Settings. Ein nachträgliches Pflegen in den App-Settings ist damit nur noch
für Änderungen im laufenden Betrieb nötig.
Jede Änderung startet die Function App neu
Das Speichern einer Anwendungseinstellung löst einen Neustart aus. Laufende Verarbeitungen
werden abgebrochen; die betroffenen Queue-Nachrichten werden erneut zugestellt.
Infrastruktur-Verbindungen
Diese Variablen verbinden die Function App mit den zugehörigen Azure-Diensten.
Sie werden durch das Deployment automatisch befüllt.
Variable
Pflicht
Beschreibung
AzureWebJobsStorage
✅¹
Connection String zum Azure Storage Account (Table Storage für die Konfiguration + Function-interner Storage).
ExportQueueServiceBus
✅¹
Connection String zum Service Bus Namespace (alle Verarbeitungs-Queues)
APPLICATIONINSIGHTS_CONNECTION_STRING
faktisch
Connection String zu Application Insights. Ohne den Wert startet die DataBridge trotzdem, gibt aber nur eine Warnung aus und sendet keinerlei Telemetrie — kein Logging, keine Metriken, keine Fehlerdiagnose.
¹ Schlüssel- oder identitätsbasiert. Standardmäßig werden die beiden Connection Strings
gesetzt. Zusätzlich setzt das Deployment in diesem Modus TARGET_BASED_SCALING_ENABLED=0:
Target-based Scaling ist damit abgeschaltet, der Host skaliert direkt über den Metrics Monitor
und die entsprechende Warnung im Log entfällt. Ist der Preview-Schalter enableManagedIdentity (Bicep) aktiv, entfallen sie und
werden durch die identitätsbasierten Varianten ersetzt — die Function nutzt dann die Managed
Identity:
Variable (Identity-Modus)
Beschreibung
AzureWebJobsStorage__accountName
Name des Storage Accounts. Der Functions-Host leitet Blob/Queue/Table-Endpunkte daraus ab und authentifiziert über die Managed Identity.
ExportQueueServiceBus__fullyQualifiedNamespace
Voll qualifizierter Service-Bus-Namespace (z. B. sbfoo.servicebus.windows.net) für den identitätsbasierten Zugriff.
Lokal (local.settings.json) bleiben die schlüsselbasierten Connection Strings maßgeblich.
`ExportQueueServiceBus` steht an zwei Stellen
Das Deployment hinterlegt den Service-Bus-Connection-String doppelt: einmal als
Anwendungseinstellung und einmal als Eintrag unter Connection strings (Typ ServiceBus).
Die DataBridge sucht den Wert in dieser Reihenfolge:
ConnectionStrings:ExportQueueServiceBus → SERVICEBUSCONNSTR_ExportQueueServiceBus →
SQLCONNSTR_… → CUSTOMCONNSTR_… → Anwendungseinstellung ohne Präfix.
Wird der Namespace ausgetauscht, sind beide Stellen anzupassen — sonst greift
weiterhin der alte Wert aus der höher priorisierten Quelle.
Im Identity-Modus (enableManagedIdentity) entfällt das: dort gibt es keinen
Connection-String-Eintrag, sondern nur ExportQueueServiceBus__fullyQualifiedNamespace.
Laufzeit-Einstellungen
Variable
Typ
Standardwert
Pflicht
Beschreibung
GetChangesTimerExpression
CRON (6-stellig)
*/15 * * * * *
✅
Taktung des GetChanges-Timers. Bei einer Neuinstallation alle 15 Sekunden.
SkipOutdatedMessages
Boolean
false
—
Wenn true: Nachrichten, deren Quell-Zeitstempel älter ist als der Zieldatensatz, werden nicht verarbeitet, sondern nach sbqignored verschoben.
`GetChangesTimerExpression` ist zwingend
Die Variable hat keinen Standardwert im Code — der Wert kommt aus dem Deployment.
Fehlt die Einstellung, schlägt die Timer-Bindung fehl und GetChanges läuft gar nicht.
`SkipOutdatedMessages` wirkt nur bei D365-Systemen
Die Einstellung wird ausschließlich von den Konnektoren für Business Central, Dataverse
und NAV ausgewertet — bei SQL-Quellen hat sie keine Wirkung. Zusätzlich greift sie nur,
wenn im Job ein WatermarkField gesetzt ist.
Nach einem Standard-Deployment steht der Wert auf false. Nur wenn die Variable
vollständig fehlt, gilt der Code-Fallback true — im Marketplace-Assistenten liegt
die Option unter Product Settings → Preview.
CRON-Ausdruck — Format
Der CRON-Ausdruck nutzt das 6-stellige NCrontab-Format (inkl. Sekunden):
Einzelne Jobs können über das Feld Schedule einen eigenen, seltener greifenden
Zeitplan bekommen — siehe Jobs.
Logging & Telemetrie
Die DataBridge steuert ihr Telemetrie-Volumen über zwei Mechanismen: gepuffertes Logging
für Log-Einträge und Sampling für ausgehende Aufrufe. Ausführlich beschrieben unter
Betrieb → Logging.
Variable
Typ
Standardwert
Beschreibung
TELEMETRY_CONTROL
String
TRACE_SAMPLE
Globaler Override für beide Sampling-Mechanismen. Werte: TRACE_SAMPLE (selektives Sampling, entspricht auch einem leeren Wert), TRACE_ALL (sendet alles), TRACE_NONE (unterdrückt alles).
TELEMETRY_INFO_SAMPLE_RATE
Integer 0–100
20
Anteil der Information-Einträge, die bei erfolgreichen Läufen gesendet werden. Bei Läufen mit Warnungen oder Fehlern immer 100 %.
TELEMETRY_DEPENDENCY_SAMPLE_RATE
Integer 0–100
10
Anteil der erfolgreichen und schnellen Aufrufe an Quell- und Zielsysteme (D365 OData, SQL, Table Storage, Service Bus), die gesendet werden. Fehlgeschlagene und langsame Aufrufe sind davon nicht betroffen.
TELEMETRY_DEPENDENCY_SLOW_MS
Integer (ms)
2000
Schwellwert, ab dem ein Aufruf als „langsam" gilt und immer gesendet wird — auch bei Erfolg.
Telemetrie-Verhalten im Überblick
Lauf-Ergebnis
Trace
Debug
Information
Warning
Error
Fehlerfreier Lauf
nie
—
~20 % (konfigurierbar)
✅
✅
Lauf mit Warnungen
nie
—
✅ alle
✅
✅
Lauf mit Fehler
nie
✅ alle
✅ alle
✅
✅
Trace-Einträge erreichen Application Insights grundsätzlich nie — auch nicht bei
Fehler-Läufen. Sie sind ausschließlich live im Log Stream der Function App bzw. im
Container-Log sichtbar.
Abhängigkeiten
Aufruf
Wird gesendet
Fehlgeschlagen
immer vollständig
Langsam (≥ TELEMETRY_DEPENDENCY_SLOW_MS)
immer vollständig
Erfolgreich und schnell
anteilig gemäß TELEMETRY_DEPENDENCY_SAMPLE_RATE
Die Entscheidung fällt hier pro Aufruf und nicht pro Funktionsausführung — ein
fehlgeschlagener Lauf enthält deshalb nicht zwangsläufig die erfolgreichen Aufrufe davor.
`TRACE_ALL` nicht dauerhaft setzen
TRACE_ALL deaktiviert beide Sampling-Mechanismen und kann das Datenvolumen um ein
Vielfaches erhöhen — bis zum Erreichen der Tagesobergrenze, ab der gar keine Telemetrie
mehr ankommt. Nur gezielt für die Dauer einer Analyse aktivieren.
Funktionen gezielt deaktivieren
Einzelne Azure Functions können ohne Redeployment deaktiviert werden.
Das ist nützlich, um z. B. die Quellabruf-Funktion zu stoppen, ohne die
Queue-Verarbeitung zu unterbrechen.
Die letzten vier gehören zur optionalen Durable-Orchestrierung, die im Regelbetrieb
ohnehin nicht aktiv ist.
Diese Variablen legt das Deployment nicht an
Die Toggles sind weder Teil des Bicep-Deployments noch des Marketplace-Assistenten. Sie
müssen bei Bedarf manuell in den Anwendungseinstellungen angelegt und danach wieder
entfernt bzw. auf false gesetzt werden.
Tipp: Wartungsfenster
Um während einer Wartung keine neuen Nachrichten zu erzeugen, GetChanges.Disabled = true
setzen. Die Queue-Funktionen können aktiv bleiben und bereits vorhandene Nachrichten
weiter verarbeiten.
Plattform-Einstellungen — nicht verändern
Diese Werte setzt das Deployment. Sie steuern die Azure-Functions-Laufzeit selbst und
haben keinen fachlichen Bezug zur DataBridge:
Variable
Wert
Bedeutung
FUNCTIONS_EXTENSION_VERSION
~4
Version der Azure-Functions-Runtime
FUNCTIONS_WORKER_RUNTIME
dotnet-isolated
Worker-Modell (.NET Isolated Worker)
WEBSITE_CONTENTAZUREFILECONNECTIONSTRING
= AzureWebJobsStorage
Ablage des Function-Contents
WEBSITE_RUN_FROM_PACKAGE
1
Ausführung direkt aus dem Deployment-Paket
Änderungen führen zu einer nicht startfähigen App
Diese Einstellungen sind nicht dafür gedacht, angepasst zu werden. Ein abweichender Wert
kann dazu führen, dass die Function App gar nicht mehr startet oder keine Funktionen mehr
registriert werden.
Nur im Container-Betrieb
Variable
Wert
Bedeutung
AzureWebJobsSecretStorageType
files
Weist die Runtime an, Function-Keys ins Dateisystem zu schreiben. Ohne diesen Wert sind HTTP-Trigger mit Function-Authentifizierung nicht aufrufbar.
Key Vault (optional)
Statt Connection Strings direkt in den Anwendungseinstellungen zu speichern, können
diese in einem Azure Key Vault hinterlegt werden. Die Function App referenziert
das Secret dann per Key Vault Reference:
Diese Referenz wird direkt als Wert der jeweiligen Umgebungsvariable eingetragen.
Azure löst sie zur Laufzeit automatisch auf — ohne Änderungen am Code.
Key Vault wird nicht mitdeployt
Das Bicep-Deployment legt keinen Key Vault an. Die System Managed Identity der
Function App wird hingegen seit v2.2 automatisch angelegt. Vor der Nutzung des Key Vault
sind daher manuell einzurichten:
Key Vault anlegen und das Secret hinterlegen
Der (bereits vorhandenen) System Managed Identity der Function App die Berechtigung
Get auf die Key Vault Secrets erteilen
Ohne diese Schritte bleibt die Referenz unaufgelöst und die App startet mit einem
fehlerhaften Verbindungswert.
Für die Zugangsdaten zu Quell- und Zielsystemen gibt es einen zweiten, davon
unabhängigen Weg über den Parameter keyVaultUrl im Verbindungs-JSON — siehe
Verbindungen.
2.4 - Container-Betrieb
Die DataBridge als Container bauen, in eine Azure Container Registry veröffentlichen und lokal starten — Beta.
Die DataBridge lässt sich als Container-Image bauen und betreiben. Das Image basiert auf
der Azure-Functions-Laufzeit und enthält dieselbe Anwendung wie das reguläre Deployment.
Beta — nicht für den Kundenbetrieb
Der Container-Betrieb ist eine Beta-Funktion und nicht für den produktiven
Kundenbetrieb vorgesehen. Auch der auf dieser Seite beschriebene Weg selbst ist noch
Beta: Abläufe, Dateinamen und Parameter können sich ohne Ankündigung ändern.
Wer die DataBridge als Container einsetzen möchte, wendet sich bitte vorab an WYSA —
dort wird der konkrete Anwendungsfall geprüft und der aktuelle Stand mitgeteilt.
Sinnvoll ist der Container-Betrieb derzeit vor allem für lokale Tests und
Entwicklung: Die HTTP-Trigger lassen sich damit ohne Azure-Deployment aufrufen.
Voraussetzungen
Werkzeug
Zweck
Docker Desktop oder Podman
Image bauen und Container starten
Azure CLI (az)
Anmeldung an der Azure Container Registry (nur zum Veröffentlichen)
Alle Befehle auf dieser Seite werden aus dem Ordner src/ ausgeführt — dort liegen
Dockerfile, compose.yml und die Start-Scripts.
Image bauen
Das Dockerfile liegt in src/. Bei Bedarf lässt sich dort das Basis-Image anpassen.
Damit steht das Image unter der angegebenen Versionsnummer in der Registry bereit.
Registry in der Function App nicht auswählbar
Lässt sich die Registry beim Konfigurieren einer Azure Function App nicht auswählen,
weil kein Admin-Konto verwendet wird, kann der Admin-Zugang nachträglich aktiviert
werden:
az acr update -n acrwysatest --admin-enabled true
Lokal betreiben
Umgebungsdatei anlegen
In src/.podman/ liegt die Vorlage podman.env.sample. Diese kopieren und unter dem
Namen podman.<Umgebung>.env ablegen, zum Beispiel podman.wysatest.env:
Anschließend die Datei mit den Verbindungsdaten der Zielumgebung füllen. Sie enthält
unter anderem AzureWebJobsStorage, ConnectionStrings__ExportQueueServiceBus,
APPLICATIONINSIGHTS_CONNECTION_STRING, den Timer-Ausdruck
GetChangesTimerExpression sowie die
Funktions-Toggles.
Danach in src/compose.yml prüfen, dass env_file auf die richtige Datei verweist:
    env_file:
      - .podman/podman.wysatest.env
Der Container veröffentlicht seinen Port unter 7071 und setzt
AzureWebJobsSecretStorageType=files, damit die Function-Keys im Container abgelegt
werden können.
Start-Script (empfohlen)
Der einfachste Weg sind die mitgelieferten Start-Scripts in src/. Sie bauen das Image,
starten den Container und geben anschließend alle HTTP-Trigger-URLs inklusive
Authentication-Key aus.
Die URLs lassen sich direkt im Browser öffnen oder in Bruno beziehungsweise curl
verwenden.
Manueller Start
Wer den Container selbst steuern möchte, startet ihn aus dem Ordner src/:
podman compose up --build -d
Logs anzeigen:
podman compose logs -f
Container beenden:
podman compose down
Beim manuellen Start muss der Key selbst ausgelesen werden
Azure Functions verlangen bei AuthorizationLevel.Function einen Schlüssel im
Query-Parameter ?code=. Das Start-Script liest den Master-Key automatisch aus dem
laufenden Container.
Beim manuellen Start muss der Schlüssel selbst ermittelt werden — er liegt nach dem
ersten Aufruf im Container unter /azure-functions-host/Secrets/host.json.
Installation prüfen
Ob der Container korrekt läuft, lässt sich über die HTTP-Trigger prüfen — GetInfo
liefert die Version, CheckList und Validate prüfen Mappings und Konfiguration. Die
Details dazu stehen unter Installation.
3 - Konfiguration
Die vier Azure Tables als zentrales Konfigurationssystem: Verbindungen, Jobs, Mappings und Watermarks.
Die dsyr.DataBridge hat keine Konfigurationsdateien. Alle Laufzeit-Einstellungen —
Verbindungen zu Quell- und Zielsystemen, Synchronisations-Jobs, Feld-Mappings und
Änderungsstände — leben in vier Azure Tables innerhalb der zugehörigen Ressourcengruppe.
Das hat einen entscheidenden Vorteil: Anpassungen werden ohne Redeployment wirksam.
Die Tabellen werden beim nächsten Funktionsaufruf automatisch neu eingelesen.
Die connections-Tabelle speichert Zugangsdaten zu allen Quell- und Zielsystemen.
Die Tabelle connections ist die Grundlage jeder DataBridge-Konfiguration. Sie enthält
die Zugangsdaten zu allen Systemen, mit denen die DataBridge kommuniziert — sowohl
Quell- als auch Zielsysteme.
Tabellenstruktur
Spalte
Wert
Beschreibung
PartitionKey
connection
Muss immer connection lauten
RowKey
frei wählbar
Eindeutiger Name dieser Verbindung. Wird in der jobs-Tabelle als Referenz verwendet.
Timestamp
automatisch
Systemseitig gesetzt, nicht bearbeitbar
Type
Connector-Typ
Gibt an, um welches System es sich handelt (siehe Tabelle unten)
Json
JSON-Objekt
System-spezifische Verbindungsparameter (unterscheidet sich je nach Type)
PartitionKey ist nicht frei wählbar
Die DataBridge liest die Tabelle ausschließlich mit dem Filter
PartitionKey eq 'connection'. Zeilen mit einem abweichenden PartitionKey werden ohne
Fehlermeldung und ohne Warnung ignoriert — die Verbindung existiert dann für die
DataBridge nicht, und jeder Job, der sie referenziert, wird als unvollständig verworfen.
Unterstützte Connector-Typen
Type-Wert
System
Lesen
Schreiben
D365BC
Dynamics 365 Business Central
✅
✅
D365CE
Dynamics 365 / Dataverse
✅
✅
D365NAV
Microsoft Dynamics NAV
✅
✅
MSSQL
Microsoft SQL Server
⚠️ Preview
—
MYSQL
MySQL / MariaDB
⚠️ Preview
—
ORACLE
Oracle Database
⚠️ Preview
—
PGSQL
PostgreSQL
⚠️ Preview
—
OPENAPI
Generische REST-API über OpenAPI-Spezifikation
✅
✅ (inkl. Löschen)
SQL-Konnektoren sind Preview und nur lesend
Die vier SQL-Konnektoren sind als interne Vorabversion eingestuft. Schreiben wird
nicht unterstützt — ein SQL-System als Ziel führt zur Laufzeit zu einem Fehler.
Auch beim Lesen bestehen Einschränkungen: Nur der MSSQL-Konnektor wertet den Filter des
Jobs aus. Details auf den jeweiligen Konnektor-Seiten.
Universelle JSON-Parameter
Diese Parameter sind für alle Connector-Typen gültig und werden in das Json-Feld
eingetragen. Alle sind optional:
Parameter
Standardwert
Beschreibung
keyVaultUrl
(leer)
URL zu einem Azure-Key-Vault-Secret. Wenn gesetzt, werden alle übrigen Parameter aus dem Secret geladen — das Json-Feld selbst enthält dann nur diesen einen Eintrag.
maxPageSize
5000
Maximale Anzahl Datensätze pro Abruf-Seite. Kann bei Performance-Problemen reduziert werden.
language
de-DE
Kultur für die Interpretation von Zahlen- und Datumsformaten.
httpClientTimeoutSeconds
100
Zeitlimit für einzelne Aufrufe in Sekunden. Relevant bei langsamen Quell- oder Zielsystemen.
Zusätzliche Parameter für HTTP-Konnektoren (D365BC, D365NAV, OpenAPI)
Diese Parameter stehen allen HTTP-basierten Konnektoren zur Verfügung, auch wenn sie
bislang vor allem für den OpenAPI-Konnektor relevant sind:
Parameter
Standardwert
Beschreibung
apiKeyHeader
(leer)
Name des HTTP-Headers für API-Key-Authentifizierung (z. B. X-API-Key). Gesetzt ⇒ API-Key-Authentifizierung wird verwendet.
apiKeyValue
(leer)
Wert des API-Keys
tokenUrl
(leer)
Eigener OAuth2-Token-Endpunkt. Ohne Angabe wird weiterhin der Microsoft-Login-Endpunkt verwendet.
authmethod
(leer)
Erzwingt eine Authentifizierungsmethode: BasicAuthentication, OAuth2, APIKey oder ManagedIdentity (Groß-/Kleinschreibung egal). Ohne Angabe wird die Methode aus den vorhandenen Zugangsdaten abgeleitet. ManagedIdentity wird nie automatisch gewählt, sondern nur über diesen Parameter. Ein unbekannter Wert führt zu einem Fehler.
Auswahl der Authentifizierungsmethode
Sind apiKeyHeaderundapiKeyValue gesetzt, hat API-Key-Authentifizierung Vorrang vor
Basic Auth und OAuth2. Andernfalls gilt weiterhin: userName + password ⇒ Basic Auth,
sonst clientId + clientSecret + tenantId ⇒ OAuth2 Client Credentials.
Ist authmethod gesetzt, gilt ausschließlich dieser Wert.
Für Managed Identity gilt:
"authmethod": "ManagedIdentity" ohne clientId verwendet die system-zugewiesene Identity der Function App.
Mit clientId wird die benutzer-zugewiesene Identity mit dieser Client-ID verwendet.
clientSecret und tenantId werden nicht benötigt. Der Token wird mit dem scope der Connection angefordert (BC-Standard: https://api.businesscentral.dynamics.com/.default).
Die Identity muss im Zielsystem berechtigt sein (bei BC als Microsoft-Entra-Anwendung in Business Central mit Berechtigungssätzen), siehe D365BC.
Hinweis: Beim D365NAV-Konnektor existiert zusätzlich authenticationMethod (nur NTLM). Das ist ein anderer Parameter als authmethod.
JSON-Parameter je Connector-Typ
D365BC — Business Central
Für Cloud-Umgebungen (OAuth2 Client Credentials):
{
"clientId": "<App-Registration Client ID>",
"clientSecret": "<App-Registration Client Secret>",
"tenantId": "<Entra Tenant ID>",
"environment": "<BC-Umgebungsname, z. B. production>",
"companyId": "<BC Company ID (GUID)>"}
OAuth2-Scope beim Token-Abruf. Nur anzupassen, wenn ein abweichender Endpunkt genutzt wird.
Die Auswahl des Authentifizierungsverfahrens erfolgt automatisch: Sind userName und
password gesetzt, verwendet die DataBridge Basic Auth, andernfalls OAuth2 Client
Credentials aus clientId, clientSecret und tenantId.
D365CE — Dataverse / Customer Engagement
{
"connectionstring": "<XRM-Connection-String>"}
Alternativ über Managed Identity (ohne Secret):
{
"url": "https://<org>.crm4.dynamics.com",
"clientid": "<Client-ID der user-assigned Identity, optional>"}
Ohne clientid wird die system-zugewiesene Identity verwendet. Ist connectionstring gesetzt, hat er immer Vorrang. Details siehe D365CE.
baseAddress ersetzt urlnicht. Sämtliche Anfrage-Adressen werden aus url
gebildet; fehlt der Parameter, bricht der Konnektor beim ersten Aufruf ab.
baseAddress wird ausschließlich bei authenticationMethod = NTLM für den
Credential-Cache verwendet und ist ansonsten entbehrlich.
Ein fehlender Schrägstrich am Ende von url wird automatisch ergänzt.
Zusätzliche NAV-Parameter:
Parameter
Standardwert
Beschreibung
scope
https://api.businesscentral.dynamics.com/.default
OAuth2-Scope beim Token-Abruf
baseAddress
(leer)
Basis-Adresse für den NTLM-Credential-Cache. Nur bei authenticationMethod = NTLM relevant.
authenticationMethod
Basic
Siehe Hinweis unten
`authenticationMethod` wirkt nur beim Wert `NTLM`
Nur NTLM (Groß-/Kleinschreibung egal) schaltet auf NTLM-Authentifizierung um — und
auch das nur, wenn zusätzlich userName und password gesetzt sind.
Bei jedem anderen Wert — auch beim Vorgabewert Basic — entscheidet die DataBridge
automatisch anhand der vorhandenen Felder: userName + password ergibt Basic Auth,
sonst clientId + clientSecret + tenantId für OAuth2.
Zeitlimit für einzelne SQL-Befehle in Sekunden. Bei großen Tabellen oder langsamen Abfragen zu erhöhen.
Diagnose-Schalter (D365BC und D365NAV)
Für die Fehlersuche lassen sich zusätzliche Protokollierungen einschalten. Alle drei
Schalter stehen standardmäßig auf false:
Parameter
Beschreibung
logCreateRequests
Protokolliert die vollständigen Anfragen beim Anlegen von Datensätzen
logUpdateRequests
Protokolliert die vollständigen Anfragen beim Aktualisieren von Datensätzen
logReceivedData
Protokolliert die vollständigen Antwortdaten des Systems
Nicht dauerhaft aktiviert lassen
Diese Schalter erzeugen erhebliche Datenmengen in Application Insights und können
Geschäftsdaten im Klartext protokollieren. Nur gezielt für die Dauer einer Analyse
aktivieren und danach wieder zurücksetzen.
Key Vault — Verbindungsdaten sicher speichern
Statt Credentials direkt in Table Storage zu speichern, kann ein Azure-Key-Vault-Secret
referenziert werden. Das Json-Feld enthält dann nur die Referenz:
Das Secret selbst enthält das vollständige JSON-Objekt der Verbindung — also alle
Parameter, die sonst direkt im Json-Feld stünden. Beim Verbindungsaufbau lädt die
DataBridge das Secret und ersetzt damit die gesamte Verbindungskonfiguration.
Optional lässt sich eine bestimmte Secret-Version adressieren, indem die Versions-ID an
den Pfad angehängt wird.
Key Vault wird nicht mitdeployt
Das Bicep-Deployment legt keinen Key Vault an. Die System Managed Identity der
Function App wird seit v2.2 hingegen automatisch angelegt. Vor der Nutzung des Key Vault
ist daher manuell einzurichten:
Key Vault anlegen und das Secret hinterlegen
Der (bereits vorhandenen) System Managed Identity die Berechtigung Get auf die
Key Vault Secrets erteilen
Ohne diese Schritte schlägt die Auflösung der Referenz beim Verbindungsaufbau fehl.
Hinweise
Der RowKey ist der Bezeichner, der in der jobs-Tabelle unter SourceConnection
bzw. TargetConnection eingetragen wird. Sprechende Namen wählen
(z. B. bc-produktion, dataverse-test).
Eine Verbindung kann von mehreren Jobs gleichzeitig genutzt werden.
Beim Start prüft die DataBridge jede Verbindung mit einem Verbindungstest. Schlägt er
fehl, bricht der laufende Aufruf ab und die Initialisierung wird beim nächsten Aufruf
erneut versucht.
Änderungen in der connections-Tabelle werden bei der nächsten Initialisierung
eingelesen — kein Redeployment nötig.
3.2 - Jobs (jobs)
Die jobs-Tabelle definiert, welche Daten wann und in welche Richtung synchronisiert werden.
Ein Job beschreibt genau eine Synchronisationsrichtung zwischen zwei Systemen:
er verbindet eine Quelltabelle mit einer Zieltabelle, legt den Zeitplan fest und
verweist auf das zugehörige Mapping.
Tabellenstruktur
Spalte
Pflicht
Beschreibung
PartitionKey
✅
Muss immer job lauten.
RowKey
✅
Eindeutiger Jobname. Wird im Logging und als Referenz für ResponseJobs verwendet.
IsActive
✅
true = Job wird von GetChanges ausgeführt. false = Job wird nur indirekt (als ResponseJob) aufgerufen.
SourceConnection
✅
RowKey-Referenz auf einen Eintrag in der connections-Tabelle (Quelldaten).
TargetConnection
✅
RowKey-Referenz auf einen Eintrag in der connections-Tabelle (Zieldaten).
Mapping
✅
PartitionKey-Referenz auf eine Gruppe von Einträgen in der mappings-Tabelle.
Source
—
Quellressource (Tabelle, Entität, Pfad oder Aktion). Überschreibt die SourceTable der Mapping-Zeilen für diesen Job (siehe unten).
Target
—
Zielressource (Tabelle, Entität, Pfad oder Aktion). Überschreibt die TargetTable der Mapping-Zeilen für diesen Job (siehe unten).
Order
✅
Ganzzahl. Legt die Ausführungsreihenfolge fest — muss über alle Jobs eindeutig sein.
WatermarkField
—
Feldname im Quellsystem, der als Änderungsindikator genutzt wird (meistens ein Datums-/Zeitstempelfeld). Nur bei WatermarkType = date oder datetime erforderlich; bei string (Dataverse Change Tracking) bleibt das Feld leer.
WatermarkType
✅
Typ des Watermark-Wertes: date, datetime oder string (Details: Watermarks).
Filter
—
Filterausdruck für die Quellanfrage. Format ist systemabhängig (siehe unten).
Schedule
—
CRON-Ausdruck (6-stellig, NCrontab). Wenn leer, läuft der Job bei jedem Timer-Aufruf.
Action
—
Steuert, welche Änderungsarten gelesen werden, oder benennt eine Aktion. Leer = NewUpdate. Wirkt bei den CRUD-Werten (Delete, DeleteOnUpdate) nur bei D365CE als Quellsystem (siehe unten); ein nicht erkannter Wert schaltet den Job auf InvokeAction (siehe unten).
Priority
—
Standard (Vorgabe), High oder Low. Steuert die Service-Bus-Queue.
ResponseJob
—
RowKey eines anderen Jobs, der nach erfolgreichem Schreiben automatisch ausgeführt wird.
IsValid
—
Reserviert. Die Spalte kommt in bestehenden Tabellen vor, wird von der DataBridge aber nicht gelesen und hat keine Wirkung.
PartitionKey ist nicht frei wählbar
Die DataBridge liest die Tabelle ausschließlich mit dem Filter PartitionKey eq 'job'.
Zeilen mit einem abweichenden PartitionKey werden ohne Fehlermeldung und ohne Warnung
ignoriert — der Job existiert dann für die DataBridge schlicht nicht.
Dasselbe gilt für die connections-Tabelle (dort connection). Nur bei mappings ist
der PartitionKey frei wählbar — er dient dort der Gruppierung.
Ausführungsreihenfolge
Das Feld Order bestimmt, in welcher Reihenfolge die fälligen Jobs bei jedem Timer-Aufruf
abgearbeitet werden. Empfehlung: BC-Jobs vor CE-Jobs ausführen, um sicherzustellen,
dass IDs aus BC schon in Dataverse existieren, bevor sie referenziert werden.
Order 10: BC → CE (Stammdaten, z. B. Kunden)
Order 20: BC → CE (Bewegungsdaten, z. B. Angebote)
Order 30: CE → BC (Rückmeldungen)
Der Order-Wert muss über alle Jobs eindeutig sein — auch über inaktive ResponseJobs
hinweg. Ein doppelter Wert führt dazu, dass die betroffenen Jobs als unvollständig
markiert und nicht ausgeführt werden.
Filter-Syntax
Der Filter bestimmt, welche Datensätze aus der Quelle abgerufen werden.
D365BC, D365NAV und SQL — Filter mit Watermark-Platzhalter
Der Filterausdruck wird als Bedingung in die Quellanfrage eingesetzt. Zwei Elemente
steuern das Verhalten:
%watermark% wird zur Laufzeit durch den gespeicherten Watermark-Wert ersetzt
{{ … }} klammert einen Block, der komplett entfällt, wenn die Watermark leer ist
{{lastModifiedDateTime gt %watermark%}}
Ist die Watermark leer (Erstlauf oder manuell geleert), verschwindet der gesamte Block
und der Job liest den vollständigen Bestand. Genau dafür ist die Klammerung gedacht.
Die Position im Filter ist egal — die Klammerung entscheidet
Es kommt nicht darauf an, dass der Watermark-Vergleich zuerst steht. Ausgewertet wird
allein die {{ }}-Klammerung: Jeder Block, der %watermark% enthält, wird bei leerer
Watermark ersatzlos entfernt. Mehrere Blöcke sind erlaubt.
Daraus folgt eine Falle beim Kombinieren von Bedingungen:
{{lastModifiedDateTime gt %watermark%}} and {{blocked eq false}}
Bei leerer Watermark entsteht daraus " and blocked eq false" — ein ungültiger
Filterausdruck, der die Abfrage gegen das Quellsystem scheitern lässt.
Richtig kombiniert wird, indem die Zusatzbedingung außerhalb der Klammer steht und
das and mit in den Watermark-Block wandert:
blocked eq false and lastModifiedDateTime gt 2026-08-01T10:00:00.000Z
leer
blocked eq false
Beide Varianten sind gültig — der Erstlauf liest den vollen Bestand, gefiltert auf
blocked eq false.
D365CE / Dataverse — JSON-Operationen
Dataverse nutzt die Change Tracking API; ein OData-Filter kommt dort nicht zum Einsatz.
Stattdessen erwartet das Filter-Feld ein JSON-Objekt, das nach dem Abruf
clientseitig ausgewertet wird — passende Datensätze werden verarbeitet, alle anderen
verworfen.
Ein nicht aufgeführter Operationsname führt zu einem Fehler
(Undefined FilterOperation). Die unter SourceField genannten Felder werden
automatisch mit abgefragt — sie müssen nicht zusätzlich im Mapping stehen.
Schedule — jobbezogener CRON-Ausdruck
Wenn ein Job seltener als der globale Timer laufen soll, kann ein eigener
CRON-Ausdruck eingetragen werden. Die DataBridge prüft anhand von LastCronRun im
Watermark, ob das Intervall bereits abgelaufen ist.
Beispiele:
Schedule
Bedeutung
0 */2 * * * *
Alle 2 Minuten
0 */15 * * * *
Alle 15 Minuten
0 0 * * * *
Stündlich
0 0 6 * * *
Täglich um 06:00 Uhr
(leer)
Greift bei jedem Timer-Aufruf
Der globale Timer (GetChangesTimerExpression) steht bei einer Neuinstallation auf
*/15 * * * * * — also alle 15 Sekunden. Ein Job ohne eigenen Schedule wird damit bei
jedem dieser Läufe geprüft.
Priorität
Wert
Service-Bus-Queue
Typischer Einsatz
High
sbqhighexport
Zeitkritische Stammdaten (Preise, Kundenstatus)
Standard
sbqexport
Normalbetrieb (Vorgabe, auch bei leerem oder unbekanntem Wert)
Low
sbqlowexport
Große Historien-Importe, Bulk-Daten
Jede der drei Queues hat einen eigenen, gleichrangigen Verarbeiter. Sie laufen unabhängig
und parallel — dadurch bleibt eine hochpriore Nachricht nicht hinter einem Rückstau
niedrigerer Priorität stehen. Eine echte Vorrang-Reihenfolge zwischen den Queues gibt es
nicht.
Weitere Queues sind rein intern
Der Service Bus enthält vier weitere Queues (sbqignored, sbqtransitivehigh,
sbqtransitivestandart, sbqtransitivelow). Sie sind Ziele der internen
Fehlerbehandlung — für übersprungene bzw. bei Konflikten im Zielsystem zurückgestellte
Nachrichten — und nicht als Wert für Priority gedacht. Details:
Architektur → Queue-Struktur.
Action — welche Änderungsarten gelesen werden
Wert
Wirkung
(leer) / NewUpdate
Nur Neuanlagen und Änderungen (Vorgabe, auch bei unbekanntem Wert)
Delete
Nur Löschungen
DeleteOnUpdate
Löschungen, die im Quellsystem als Änderung auftreten
All
Neuanlagen, Änderungen und Löschungen in einem Job
ein beliebiger anderer Wert
Der Job wird als Aktions-Job (InvokeAction) behandelt — siehe unten
CRUD-Werte wirken nur bei D365CE als Quellsystem
Die Werte Delete, DeleteOnUpdate und All werden ausschließlich vom Dataverse-Connector
ausgewertet. Steht als Quelle ein D365BC-, D365NAV- oder SQL-System, haben sie keine
Wirkung — der Job liest dort unabhängig vom gesetzten Wert immer Neuanlagen und
Änderungen.
InvokeAction — Aktions-Jobs
(neu) Enthält Action weder einen leeren Wert noch den Namen eines bekannten
JobActionType (NewUpdate, Delete, TimeStamp, DeleteOnUpdate), wird der Job zu
einem Aktions-Job: Statt eines CRUD-Zyklus ruft er einen benannten, nicht-CRUD-Endpunkt
auf. Der Wert von Action wird dabei unverändert als Aktionsname übernommen — z. B. ein
OpenAPI-operationId oder der Name eines CE-OrganizationRequest.
Action = SendByEInvoice
Aktuell implementiert der OpenAPI-KonnektorInvokeAction
(ResourcePath aus Source/Target bzw. TargetPath + TargetTable der Mapping-Zeilen).
Details und Konfigurationsbeispiel: Konnektoren → OpenAPI → InvokeAction.
Source und Target — job-eigene Ressourcenpfade
(neu) Bislang bestimmten ausschließlich die Mapping-Zeilen (SourceTable/TargetTable),
welche Ressource ein Job liest bzw. beschreibt. Ein Job kann jetzt zusätzlich eigene Felder
Source und Target tragen, die diese Werte überschreiben:
Sind Source/Target am Job leer, gilt weiterhin das bisherige Verhalten — die
Mapping-Zeilen bestimmen die Ressource (mit einer einmaligen Warnung im Log, die auf die
ältere Konfigurationsform hinweist).
Ist mindestens eines der beiden Felder gesetzt, wird nur dieses überschrieben; das jeweils
andere fällt weiterhin auf den Mapping-Wert zurück.
Fehlt sogar das Mapping-Feld am Job komplett, wird aus Source/Target ein
synthetisches Mapping ohne TargetKey erzeugt (JOB-<Jobname>) — nützlich für reine
Aktions-Jobs ohne Feld-Mapping.
Enthält Source/Target einen Schrägstrich (pfad/ressource), wird der Teil vor dem
letzten Schrägstrich als Pfad (SourcePath/TargetPath), der Teil danach als
Ressourcenname (SourceTable/TargetTable) interpretiert.
Damit lässt sich ein und dieselbe Mapping-Definition für mehrere Ressourcen bzw.
Aktionspfade wiederverwenden, statt für jede Kombination eine eigene Mapping-Gruppe
anzulegen.
ResponseJob — Rückschreiben von IDs
Ein ResponseJob löst das Problem, dass Business Central beim Anlegen eines Datensatzes
eine neue interne ID vergibt, die anschließend in Dataverse gespeichert werden soll.
Ablauf:
Job A schreibt einen Datensatz von CE nach BC
BC antwortet mit dem neu erzeugten Datensatz inkl. der neuen BC-ID
Die DataBridge führt automatisch Job B (den ResponseJob) aus
Job B liest die BC-ID aus der Antwort (ReadFromMessage-Operation) und schreibt
sie zurück nach CE
Konfiguration:
Job A:  IsActive = true
        ResponseJob = "JobB-RowKey"

Job B:  IsActive = false   ← wird nur durch Job A ausgelöst, nie direkt
        SourceConnection = BC-Verbindung
        TargetConnection = CE-Verbindung
Felder, die aus der BC-Antwort gelesen werden, werden im Mapping mit einem
Unterstrich-Präfix im SourceField markiert und die Operation ReadFromMessage
eingetragen (Details: Mappings → ReadFromMessage).
3.3 - Mappings (mappings)
Die mappings-Tabelle definiert, welche Felder wie zwischen Quell- und Zielsystem übertragen und transformiert werden.
Die mappings-Tabelle ist die mächtigste Konfigurationsebene der DataBridge.
Sie legt für jedes Feld fest: woher kommt der Wert, wohin geht er, und wie wird
er unterwegs transformiert.
Ein Mapping ist eine Gruppe von Zeilen in der Tabelle — alle mit demselben
PartitionKey. Jede Zeile beschreibt genau eine Feld-Zuordnung.
Tabellenstruktur
Spalte
Pflicht
Beschreibung
PartitionKey
✅
Name des Mappings. Wird im Job unter Mapping referenziert. Im Gegensatz zu jobs und connections ist der PartitionKey hier frei wählbar — er dient der Gruppierung.
RowKey
✅
Eindeutiger Bezeichner innerhalb des Mappings. Konvention: _quellfeld__zielfeld_
SourceTable
✅
Name der Quelltabelle/-entität. Muss innerhalb eines Mappings konsistent sein.
SourceField
—
Name des Quellfeldes. Kann leer sein (bei DefaultValue) oder mit _ beginnen — dann handelt es sich um ein virtuelles Feld.
TargetTable
✅
Name der Zieltabelle/-entität. Muss innerhalb eines Mappings konsistent sein.
TargetField
✅
Name des Zielfeldes. Muss dem tatsächlichen API-/Spaltenname entsprechen.
TargetKey
—
JSON-Objekt. Definiert, wie ein bestehender Datensatz im Zielsystem identifiziert wird (für Upsert-Logik).
SourceOperation
—
JSON-Objekt der Form { "Operations": [ … ] }. Transformation beim Lesen aus der Quelle.
TargetOperation
—
JSON-Objekt der Form { "Operations": [ … ] }. Transformationen beim Schreiben ins Ziel.
RowKey-Namenskonvention
Die empfohlene Konvention für den RowKey: _quellfeld__zielfeld_
Doppelter Unterstrich trennt Quell- vom Zielfeld. Die umgebenden Unterstriche
kennzeichnen es als Mapping-RowKey. Diese Konvention ist optional, aber empfohlen
für Lesbarkeit und Filterbarkeit.
TargetKey — Upsert-Schlüssel
Der TargetKey bestimmt, wie die DataBridge entscheidet, ob ein Datensatz im
Zielsystem angelegt (Insert) oder aktualisiert (Update) wird.
Es gibt vier Typen:
PrimaryKey
Nutzt den systemnativen Primärschlüssel des Zielsystems. Der Schlüsselname wird
automatisch aus dem SourceField der Mapping-Zeile übernommen.
{ "KeyType": "PrimaryKey" }
Id
Ähnlich wie PrimaryKey, nutzt jedoch die systemspezifische ID-Eigenschaft des Connectors.
{ "KeyType": "Id" }
Unterschied zwischen PrimaryKey und Id
Bei Business Central und NAV entscheidet die Wahl über die Anführungszeichen im
erzeugten OData-Schlüssel: PrimaryKey setzt den Wert in Anführungszeichen, Id
schreibt ihn unquotiert. Die falsche Wahl führt zu einem Syntaxfehler in der Abfrage.
Dataverse kennt nur PrimaryKey. Ein dort eingetragenes Id fällt in den
Standardzweig, erzeugt lediglich eine Warnung im Log und wird übersprungen —
kein Fehler, aber der Schlüssel greift nicht.
CustomKey
Benutzerdefinierter Schlüssel aus einem oder mehreren Feldern. Wird eingesetzt, wenn
der Datensatz im Zielsystem nicht über den Primärschlüssel, sondern über eine
Geschäftsfeld-Kombination identifiziert wird.
Zielfeld, das den zusammengesetzten Schlüsselwert enthält
keyName
Zielfeld-Name für diesen Schlüsselteil
attributeName
Quellfeld-Name, aus dem der Wert kommt
StaticValue
Fester Wert statt eines Quellwertes (siehe unten)
rank
Reihenfolge der Schlüsselteile innerhalb des Schlüssels (aufsteigend)
Filter
Sucht im Zielsystem nach einem Datensatz, der alle angegebenen Feld-Wert-Kombinationen
erfüllt. Im Gegensatz zu CustomKey wird kein explizites Schlüsselfeld benötigt.
Bei Dataverse ist die Bedeutung von keyName und attributeName vertauscht
Im D365CE-Connector haben die beiden Felder bei KeyType: Filter die umgekehrte
Bedeutung wie bei CustomKey:
Feld
Bedeutung bei Filter (D365CE)
keyName
Quellfeld — daraus wird der Suchwert gelesen
attributeName
Zielfeld — dessen Metadaten bestimmen die Typumwandlung
Bei Business Central gilt dagegen für beide Schlüsseltypen dieselbe Zuordnung
(keyName = Zielfeld).
Stiller Fallstrick bei Filter in Dataverse
Die Bedingung wird nur dann in die Abfrage aufgenommen, wenn im selben Mapping eine
Zeile existiert, deren SourceField dem keyNameund deren TargetField dem
attributeName entspricht.
Fehlt diese Zeile, wird die Bedingung kommentarlos weggelassen — die Abfrage
liefert dann zu viele Datensätze, ohne dass ein Fehler auftritt.
Statische Schlüsselwerte
(ab v2.1 — verfügbar für D365CE und D365BC)
Ein Schlüsselteil kann gegen einen fest hinterlegten Wert aufgelöst werden, ohne dass
dafür ein Quellfeld existieren muss. Dazu wird statt attributeName das Feld
StaticValue gesetzt:
StaticValue greift nur, wenn attributeName leer ist. Ist beides gesetzt, gewinnt
der Quellwert.
Bei Business Central werden statische Werte für die Metadaten-Typen string, guid und
int32 unterstützt; andere Typen führen zu einem Fehler.
Besteht der Schlüssel nur aus statischen Werten
Dann wird die Mapping-Zeile auch dann verarbeitet, wenn das SourceField in der
Nachricht gar nicht vorkommt — die Zeile wird also nicht wie sonst übersprungen.
D365NAV unterstützt keine statischen Schlüsselwerte
Der NAV-Connector greift bei der Schlüssel- und Filtererzeugung unbedingt auf
attributeName zu. Ein dort gesetztes StaticValue bleibt wirkungslos und führt zu
einem Fehler, sobald das Quellfeld fehlt.
Mehrere Ziel-Schlüssel mit Rangfolge
(ab v2.1)
Ein Mapping kann mehrere Ziel-Schlüssel besitzen. Sie werden anhand des Feldes KeyRank
in aufsteigender Reihenfolge geprüft — sobald ein Schlüssel im Zielsystem einen
Datensatz findet, wird dieser verwendet und die übrigen werden übersprungen.
Typischer Einsatz: zuerst über eine externe ID suchen, ersatzweise über eine Nummer.
Die Konfiguration unterscheidet sich je nach Ebene:
Ebene
Vorgehen
Table-Mapping
Je Schlüssel eine eigene Mapping-Zeile mit eigenem TargetKey-JSON anlegen. Die DataBridge fasst alle TargetKey-Einträge einer Mapping-Gruppe zusammen und sortiert sie nach KeyRank.
Lookup (TargetOperation)
In Parameters statt TargetKey ein Array TargetKeys mit mehreren Schlüsseln angeben.
KeyRank bestimmt die Reihenfolge mehrerer Schlüssel zueinander.
rank innerhalb von KeyValues bestimmt die Reihenfolge der Felder innerhalb eines
Schlüssels.
Bestehende Mappings mit einem einzelnen TargetKey funktionieren unverändert — intern
wird ein einzelner Schlüssel wie eine Liste mit einem Eintrag behandelt.
Leere Schlüssel in der Quelle
Liefert die Quelle für einen Schlüssel keinen Wert, bricht die Verarbeitung der Nachricht
standardmäßig mit einem Fehler ab — auch dann, wenn ein weiterer Schlüssel den Datensatz
noch hätte finden können. Mit IgnoreEmptySourceKey lässt sich
das je Schlüssel abschalten.
KeyAttributeFromExisting
Optionales Feld am TargetKey, ausgewertet bei KeyType: Filter von den Konnektoren für
Business Central, NAV und OpenAPI. Der Filter findet nur den bestehenden Zieldatensatz.
Für die Item-URL beim Aktualisieren (bei OpenAPI auch beim Löschen) wird der Schlüssel
aus dem hier angegebenen Feld dieses Datensatzes übernommen.
BC/NAV: Pflicht bei Filter. Guid- und Zahl-Schlüssel werden ohne, alle anderen mit
Hochkommas in die URL geschrieben, der Typ kommt aus den Metadaten. Fehlt das Feld im
bestehenden Datensatz, bricht die Verarbeitung mit einem Fehler ab.
OpenAPI: Optional. Ohne Angabe wird der Primärschlüssel der Spezifikation verwendet
(id, Id, ID, uuid oder key).
Der Feldname ist case-sensitiv (id ≠ Id).
IgnoreEmptySourceKey
(ab v2.2, nur D365CE)
Optionales Boolesches Feld am TargetKey. Standard ist false.
Um das Feld einordnen zu können, muss man zwei Situationen auseinanderhalten, die beide
danach aussehen, als wäre ein Schlüssel erfolglos geblieben:
Situation
Was passiert
Verhalten ohne dieses Feld
Schlüssel lässt sich nicht aufbauen — das Quellfeld ist leer, es gibt gar keinen Wert zum Suchen
Es wird nicht gesucht
Fehler, die Nachricht schlägt fehl
Schlüssel findet nichts — es wurde gesucht, im Zielsystem existiert der Datensatz noch nicht
Suche läuft, bleibt ergebnislos
Datensatz wird angelegt — kein Fehler
Die zweite Zeile ist der Normalfall für jeden neuen Datensatz: Beim ersten Übertragen
findet kein Schlüssel etwas, und genau deshalb wird angelegt. IgnoreEmptySourceKey
ändert daran nichts.
Das Feld wirkt ausschliesslich auf die erste Zeile: Es erklärt einen leeren Quellwert
für diesen einen Schlüssel zum Normalfall statt zum Fehler.
Warum ein leerer Schlüssel überhaupt ein Fehler ist
Bei einem leeren Schlüssel konnte nicht geprüft werden, ob der Zieldatensatz existiert.
Ihn trotzdem anzulegen, könnte ein Duplikat erzeugen. Deshalb bricht die DataBridge im
Zweifel ab — es sei denn, Sie erklären mit diesem Feld, dass der Schlüssel erwartbar
leer sein kann.
Wann das Feld überhaupt zum Tragen kommt
Die Schlüssel werden nach KeyRank der Reihe nach geprüft. Sobald ein Schlüssel einen
Datensatz findet, bricht die Suche ab und der Datensatz wird aktualisiert — unabhängig
davon, was bei den vorherigen Schlüsseln passiert ist und wie sie konfiguriert sind.
Beispiel mit drei Schlüsseln, bei dem Schlüssel 1 leer und nicht markiert ist:
Schritt
Ergebnis
Schlüssel 1
leer, wird übersprungen — gemerkt: „hier war ein Fehler"
Schlüssel 2
leer, markiert — wird übersprungen
Schlüssel 3
findet den Datensatz → Suche endet
Ergebnis
Update. Kein Fehler — der gemerkte Fehler wird gar nicht mehr ausgewertet
Das Feld greift also nur dann, wenn die Liste vollständig durchlaufen wurde und
kein einziger Schlüssel einen Datensatz gefunden hat. Erst dann steht die Frage
„Fehler oder anlegen?" überhaupt im Raum.
Die Entscheidung am Ende
Hat kein Schlüssel etwas gefunden, entscheidet sich Folgendes:
Waren alle leer gebliebenen Schlüssel mit IgnoreEmptySourceKey: true markiert
(oder blieb gar keiner leer), wird ein neuer Datensatz angelegt.
War auch nur einer der leer gebliebenen Schlüssel nicht markiert, bleibt es
beim Fehler.
Das Feld gilt also je Schlüssel: Es hebt die Fehlerbehandlung der übrigen Schlüssel nicht
auf. Lassen Sie es bei einem Schlüssel bewusst weg, bleibt ein leerer Wert dort ein
Fehler — auch wenn ein anderer Schlüssel des Mappings markiert ist.
Das Feld bewusst setzen
Für die betroffenen Fälle verschiebt sich das Verhalten von „Nachricht abweisen" zu
„Datensatz anlegen". Setzen Sie es nur dort, wo ein leerer Quellwert fachlich erwartbar
ist und ein weiterer Schlüssel den Datensatz zuverlässig findet.
Typischer Einsatz
Ein optionales Feld wie eine externe ID ist nicht in jedem Quelldatensatz gefüllt, die
Belegnummer dagegen immer. Mit IgnoreEmptySourceKey: true am ID-Schlüssel laufen auch
die Datensätze ohne externe ID sauber durch und werden über die Belegnummer gefunden.
Das Feld wird derzeit ausschliesslich vom D365CE-Konnektor ausgewertet. Bei Business
Central und NAV bleibt es wirkungslos.
Virtuelle Felder
Beginnt das SourceField mit einem Unterstrich, handelt es sich um ein virtuelles
Feld: Es wird nicht aus der Quelltabelle gelesen, sondern zur Laufzeit über eine
SourceOperation erzeugt.
SourceOperations greifen ausschliesslich bei virtuellen Feldern
Eine SourceOperation wird nur ausgeführt, wenn das SourceField der Zeile mit _
beginnt. Steht dort ein normaler Feldname, wird die Operation stillschweigend ignoriert —
das gilt für LookupValue, ActivityParty, LinkToRecord und ReadFromMessage
gleichermaßen.
Umgekehrt wird ein _-präfixiertes Feld nicht in die Select-Liste der Quellabfrage
aufgenommen — stattdessen wird das unter Parameters.SourceField genannte Feld
abgefragt.
Der ResponseJob ist dabei nur einer von mehreren Anwendungsfällen:
Anwendungsfall
Operation
Wert aus einer anderen Tabelle nachschlagen
LookupValue
Wert aus einer ActivityParty-Beziehung lesen
ActivityParty
Link auf einen Dataverse-Datensatz erzeugen
LinkToRecord
Wert aus der Antwortnachricht lesen (ResponseJob)
ReadFromMessage
Zeilen eines Kind-Jobs einbetten
EmbedChildren
SourceOperation — Transformation beim Lesen
SourceOperations werden angewendet, bevor der Wert in die Service Bus Queue
geschrieben wird. Sie sind connector-spezifisch — nicht jede Operation steht in jedem
Connector zur Verfügung.
Es wird nur die erste Operation ausgeführt
Obwohl Operations ein Array ist, wertet die DataBridge bei SourceOperations
ausschließlich den ersten Eintrag aus. Weitere Einträge werden verworfen — ohne
Fehler und ohne Warnung.
LookupValue
(verfügbar: D365BC, D365CE, D365NAV)
Liest einen Wert aus einer anderen Tabelle im Quellsystem nach.
Beispiel: Aus einem Land-Code soll der ausgeschriebene Ländername übertragen werden.
Attribute — liest ein bestimmtes Feld aus dem gefundenen Datensatz. Name — liefert den Anzeigenamen des verknüpften Datensatzes; dann entfallen LookupTable und LookupField.
SourceField
Feld im Quelldatensatz, das den Suchwert enthält
LookupTable
API-Pfad der nachzuschlagenden Tabelle
LookupField
Feld im nachgeschlagenen Datensatz, dessen Wert übertragen wird
UseCache
true dringend empfohlen — siehe Hinweis
LookupType Name nur in Dataverse
Der Wert Name ist ausschließlich im D365CE-Connector implementiert. Business Central
und NAV werfen dafür einen Nicht-implementiert-Fehler.
UseCache aktiviert das Pre-Caching
Mit UseCache: true löst der Dataverse-Connector die benötigten Lookup-Werte seit v2.1
pro Batch gebündelt vorab auf — in Blöcken von 1000 Werten — statt für jeden
Datensatz einzeln beim Zielsystem nachzufragen. Das beschleunigt große Änderungsmengen
erheblich.
Ohne UseCache entfällt das Pre-Caching vollständig. Vorausgesetzt wird zusätzlich ein
gesetztes Parameters.SourceField.
ReadFromMessage
(verfügbar: D365BC, D365NAV, D365CE)
Liest einen Wert aus der ursprünglichen Queue-Nachricht — wird typischerweise in
ResponseJobs verwendet, um Felder aus der Antwort des Zielsystems (z. B. eine neu
vergebene ID) zurückzuschreiben.
Liest ein Feld über eine ActivityParty-Beziehung aus. Wird für CE-Aktivitäten
(E-Mails, Aufgaben) verwendet, bei denen Teilnehmer über den activityparty-Datensatz
verknüpft sind.
Feld im verknüpften Datensatz, das gelesen werden soll
TargetTable
Entität des verknüpften Datensatzes
Werden mehrere Teilnehmer gefunden, werden ihre Werte komma-separiert zusammengefügt.
TypeMask ist ein Dataverse-Plattformwert
Die DataBridge reicht den Wert unverändert an Dataverse durch. Die Bedeutung der
einzelnen Zahlen (1 = Sender, 2 = To-Empfänger, …) ist in der
Dataverse-Dokumentation von Microsoft
beschrieben und nicht Teil dieser Anwendung.
LinkToRecord
(verfügbar: nur D365CE)
Erzeugt eine anklickbare URL zu einem Datensatz in Dataverse.
Nützlich, um in BC oder SQL einen direkten Link auf den zugehörigen CE-Datensatz zu
speichern.
An die angegebene Basis-URL werden automatisch &etn=<entity> und &id=<guid> angehängt.
EmbedChildren
(neu, verfügbar: nur D365CE als Quellsystem)
Bettet die Zeilen eines referenzierten Kind-Jobs in die Nachricht des Elterndatensatzes
ein, sodass Eltern- und Kind-Datensätze gemeinsam als eine Nachricht durch den Service Bus
laufen und gemeinsam ins Ziel geschrieben werden — z. B. eine Rechnung mit ihren
Rechnungspositionen.
Pfad im Zieldatensatz, unter dem das Array landet (z. B. lines)
Der referenzierte Kind-Job liefert SourceConnection, Quellressource und Mapping; sein
Filter kann {{...%parent.feld%...}}-Platzhalter enthalten, die zur Abrufzeit gegen den
Eltern-Quelldatensatz aufgelöst werden. Beim Schreiben in eine
OpenAPI-Zielressource
wird daraus ein verschachteltes JSON-Array gebaut und unverändert — ohne Feld-für-Feld-Abgleich
gegen ein eventuell vorhandenes Zielarray — mit der Elternanfrage übertragen.
TargetOperation — Transformationen beim Schreiben
TargetOperations werden angewendet, bevor der Wert ins Zielsystem geschrieben wird.
TargetOperations werden über den Namen aufgelöst
Anders als bei SourceOperations dürfen mehrere Einträge im Array stehen. Sie werden
jedoch nicht der Reihe nach ausgeführt, sondern anhand ihres Namens gesucht — die
Reihenfolge im Array hat keine Wirkung.
Es gilt eine feste Rangfolge:
DefaultValue — überschreibt den Quellwert vollständig
DefaultValueIfNullOrEmpty — greift, wenn das Ergebnis leer ist
DefaultValueMap — übersetzt den bis dahin ermittelten Wert zuletzt
DefaultValue
(alle Konnektoren)
Schreibt immer einen festen Wert ins Zielfeld — unabhängig vom Quellwert.
Das SourceField kann in diesem Fall leer gelassen werden.
Array mehrerer Schlüssel mit KeyRank (ab v2.1, siehe oben)
DoNotCreate
true verhindert das automatische Anlegen (ab v2.1, siehe unten)
SetNullIfEqualsValueOfField
Setzt das Lookup auf null, wenn der Wert dem angegebenen Feld der Nachricht entspricht — Schutz gegen Selbstreferenzen
DefaultValue
Fester Wert; überspringt die Auflösung vollständig
DoNotCreate — automatisches Anlegen abschalten
Standardmäßig legt die DataBridge einen nicht gefundenen Ziel-Datensatz automatisch an.
Mit "DoNotCreate": true unterbleibt das: Der Lookup wird nur aufgelöst, wenn der
Datensatz bereits existiert — andernfalls bleibt das Feld leer.
Die Option wirkt nur auf diesen Fallback. Die vorgelagerte Suche über mehrere
TargetKeys läuft unverändert.
OptionMapping
(verfügbar: D365CE; bei D365BC und D365NAV für String-Felder)
Übersetzt Textwerte aus dem Quellsystem in numerische Optionset-Werte von Dataverse
(und umgekehrt). Die Mapping-Liste enthält alle bekannten Schlüssel-Wert-Paare.
Für MultiSelect-Optionsets ist zusätzlich der Parameter OptionDelimiter anzugeben —
er trennt die Einzelwerte im Quellstring. Ohne ihn schlägt die Aufteilung fehl.
Sonderzeichen in Schlüsseln
In der Praxis liefert Business Central Sonderzeichen in Feldwerten kodiert: ein
Leerzeichen als _x0020_, ein Bindestrich als _x002D_. Diese kodierten Werte sind
dann 1:1 als Key einzutragen.
Die DataBridge vergleicht die Schlüssel lediglich als Zeichenketten — die Kodierung
stammt aus dem Quellsystem, nicht aus dieser Anwendung.
Datentyp-Umwandlung
Welche Quelltypen ein Zielfeld akzeptiert, hängt vom Connector und vom Zielfeld-Typ ab.
Die vollständigen Matrizen stehen auf den Konnektor-Seiten.
Zwei Punkte, die häufig zu Rückfragen führen:
String zu Dezimalzahl(ab v2.1) — Dezimalfelder akzeptieren jetzt auch Quellwerte
vom Typ string. Diese werden immer im Format en-US interpretiert, also mit Punkt
als Dezimaltrennzeichen. Ein leerer String wird zu null, ein nicht konvertierbarer Wert
erzeugt einen Fehler.
Culture bei echten Zahlentypen — kommt der Wert dagegen bereits als decimal oder
money, gilt die im Verbindungs-JSON eingestellte language (Vorgabe de-DE).
Diese Asymmetrie ist beabsichtigt
Derselbe Zahlenwert wird also unterschiedlich interpretiert, je nachdem, ob er als
Zeichenkette oder als Zahl aus dem Quellsystem kommt. Bei Feldern, die als string
geliefert werden, ist der Punkt als Dezimaltrennzeichen zu verwenden — unabhängig von
der eingestellten language.
Spezialfälle
Feld ohne Quellwert (reiner Standardwert)
Soll ein Zielfeld immer mit einem festen Wert befüllt werden, ohne dass ein
Quellfeld existiert:
Ob mehrere Einträge im Operations-Array wirken, hängt davon ab, um welche Art von
Operation es sich handelt:
Verhalten bei mehreren Einträgen
SourceOperation
Nur der erste Eintrag wird ausgeführt, alle weiteren verworfen
TargetOperation
Mehrere Einträge sind zulässig; sie werden über ihren Namen aufgelöst, nicht über die Reihenfolge. Es gilt die Rangfolge DefaultValue → DefaultValueIfNullOrEmpty → DefaultValueMap.
Eine Verkettung im Sinne von „erst A, dann B auf das Ergebnis von A" gibt es bei
SourceOperations damit nicht.
3.4 - Watermarks (watermark)
Die watermark-Tabelle speichert den letzten synchronisierten Stand pro Job — und verhindert so doppelte Übertragungen.
Die Tabelle watermark ist die Gedächtnisfunktion der DataBridge. Nach jedem
Job-Lauf wird hier gespeichert, bis zu welchem Stand die Daten gelesen wurden.
Beim nächsten Lauf startet der Quellabruf genau an diesem Punkt.
Diese Tabelle wird vom Deployment angelegt und zur Laufzeit automatisch befüllt —
manuelle Einträge sind normalerweise nicht nötig. Es gibt jedoch Situationen, in denen
ein gezielter Eingriff sinnvoll ist.
Tabellenstruktur
Spalte
Wert
Beschreibung
PartitionKey
watermark
Fest vorgegeben — immer watermark
RowKey
Jobname
Entspricht dem RowKey des zugehörigen Jobs in der jobs-Tabelle
Timestamp
automatisch
Systemseitig gesetzt, nicht bearbeitbar
Watermark
Letzter Stand
Format abhängig vom WatermarkType des Jobs (siehe unten)
LastCronRun
Zeitstempel
Beginn der letzten Ausführung des Jobs. Basis für die CRON-Intervallprüfung.
Watermark-Typen
Der Typ wird im Job über das Feld WatermarkType festgelegt und bestimmt,
wie der gespeicherte Wert interpretiert wird.
datetime — Vollständiger Zeitstempel
Für Quellsysteme, die Änderungen über ein Datum-/Uhrzeit-Feld tracken.
Typisch für Business Central (lastModifiedDateTime).
Format:yyyy-MM-ddTHH:mm:ss.fffZ
Beispielwert:2026-05-31T08:15:00.000Z
Der Filter im Job sieht dann so aus:
{{lastModifiedDateTime gt %watermark%}}
date — Nur Datum
Für Quellsysteme, bei denen nur das Datum (ohne Uhrzeit) relevant ist.
Typisch für NAV-Systeme mit datumbasiertem Tracking.
Format:yyyy-MM-dd
Beispielwert:2026-05-31
string — Change Tracking Token
Für Dataverse / D365CE: Die Change Tracking API gibt bei jedem Abruf einen
opaken Token zurück, der den aktuellen Änderungsstand repräsentiert.
Dieser Token wird als string gespeichert und beim nächsten Lauf direkt
an die API übergeben — kein Datumsvergleich, kein Risiko fehlender Änderungen.
Für alle D365CE-Jobs WatermarkType = string verwenden. Die Dataverse
Change Tracking API garantiert lückenlose Erkennung aller Änderungen —
auch wenn der Timer während einer Änderung ausgeführt wird.
Schreibweise und unbekannte Typen
Der Typ wird ohne Beachtung von Groß-/Kleinschreibung und ohne umgebende Leerzeichen
erkannt — datetime, DateTime und DATETIME sind gleichwertig.
Ein unbekannter Typ legt die Änderungserkennung still
Steht im Feld WatermarkType ein Wert, der weder date noch datetime noch string
ergibt (z. B. ein Tippfehler), gilt der Typ als unbekannt. Dann passiert Folgendes:
Die gespeicherte Watermark bleibt unangetastet — sie wird nicht geleert
Sie wird aber auch nie fortgeschrieben
Im Log erscheint eine Warnung mit Jobnamen und dem hinterlegten Rohwert
Der Job liest damit bei jedem Lauf dieselbe Menge erneut. Die Warnung im Log ist der
einzige Hinweis darauf — es entsteht kein Fehler.
Bis einschließlich v2.0 war das Verhalten deutlich schlimmer: Der Vergleich war
zeichengenau, ein abweichend geschriebenes DateTimeleerte die Watermark, und der
Job las bei jedem Lauf das komplette Quellsystem — ohne jede Meldung.
Wann wird der Watermark aktualisiert?
Der Watermark wird am Ende der Erkennungsphase fortgeschrieben — also sobald alle
gefundenen Änderungen in die Queue geschrieben sind, und bevor das Zielsystem
beschrieben wurde. Für die Zustellung ins Ziel sorgen danach die Queue-Mechanismen
(Wiederholung, Dead-Letter).
Im Einzelnen:
Beim Lesen führt die DataBridge den Änderungsmarker (ChangeTracker) der verarbeiteten
Datensätze mit
Bei date und datetime wird jeweils der höhere der beiden Werte behalten, bei
string gewinnt immer der zuletzt gelesene Token — ein opaker Token hat keine
Ordnung
Nach dem Leeren des letzten Batches wird der Endstand in die Tabelle geschrieben
LastCronRun wird auf den Zeitpunkt gesetzt, zu dem der Job begonnen hat
`LastCronRun` wird bei jedem Lauf geschrieben
Auch dann, wenn der Job keine Änderungen gefunden hat oder gar keinen eigenen Schedule
besitzt. Der Wert ist damit ein verlässlicher Indikator dafür, ob ein Job überhaupt
gelaufen ist.
Bricht ein Job mit einem Fehler ab, bleibt der Watermark auf dem zuletzt geschriebenen
Stand. Beim nächsten Lauf wird ab diesem Punkt erneut gelesen.
Zeitzonen
Zeitstempel werden zeitzonenunabhängig verglichen. Bis v2.0 wurde die Zeitangabe in die
lokale Zeit des Servers umgerechnet — beim Typ date konnte das über eine Tagesgrenze
springen und das Vergleichsergebnis je nach Betriebsstandort verändern.
Erster Lauf — kein Eintrag vorhanden
Existiert für einen Job noch kein Watermark-Eintrag, legt die DataBridge ihn
beim ersten Lauf automatisch an. Als Startpunkt wird ein möglichst früher Wert
verwendet:
Typ
Initialwert
datetime
0001-01-01T00:00:00.000Z
date
0001-01-01
string
(leer)
Das bedeutet: der erste Lauf lädt alle vorhandenen Datensätze aus dem Quellsystem.
Bei großen Datenmengen sollte dies zu einem Zeitpunkt mit geringer Last geschehen.
Manueller Eingriff — Wann und warum
Kein Schutz gegen gleichzeitige Änderungen
Die DataBridge schreibt Watermark-Einträge ohne ETag-Prüfung — es gilt
Last-Writer-Wins. Wird ein Wert von Hand geändert, während der zugehörige Job gerade
läuft, überschreibt der Job die manuelle Änderung am Ende seines Laufs kommentarlos.
Vor einem Eingriff daher die betroffene Funktion deaktivieren
(AzureWebJobs.GetChanges.Disabled = true) oder einen Zeitpunkt wählen, zu dem der Job
nachweislich nicht läuft.
Vollständigen Neulauf erzwingen
Den Wert in der Watermark-Spalte leeren oder auf den Initialwert zurücksetzen.
Beim nächsten Lauf werden alle Datensätze erneut übertragen.
Typische Anwendungsfälle:
Mapping wurde grundlegend geändert und alle Datensätze sollen neu gemappt werden
Zielsystem wurde zurückgesetzt oder neu aufgebaut
Datenverlust im Zielsystem
Partiellen Neulauf ab bestimmtem Datum
Den Watermark-Wert manuell auf ein Datum setzen, ab dem neu gelesen werden soll:
2026-01-01T00:00:00.000Z
Damit werden nur Datensätze übertragen, die seit diesem Datum geändert wurden.
Bei WatermarkType = string ist das nicht möglich — der Token stammt aus Dataverse
und lässt sich nicht sinnvoll von Hand konstruieren. Dort bleibt nur das vollständige
Leeren.
LastCronRun zurücksetzen
Wenn ein Job mit eigenem Schedule nicht zum erwarteten Zeitpunkt ausgeführt wurde,
kann LastCronRun manuell auf einen früheren Wert gesetzt werden. Die DataBridge
erkennt dann, dass das Intervall abgelaufen ist, und führt den Job beim nächsten
Timer-Aufruf aus.
4 - Konnektoren
Die unterstützten Quell- und Zielsysteme: Dynamics 365, Dataverse, NAV und SQL-Datenbanken.
Jedes Quell- oder Zielsystem wird über einen Konnektor angebunden. Ein Konnektor
übernimmt die systemspezifische Kommunikation: Authentifizierung, Datenabfrage,
Änderungserkennung und das Schreiben von Datensätzen.
Die Konnektoren D365BC, D365CE und D365NAV kommunizieren über HTTP/OData-APIs.
MSSQL, MySQL, Oracle und PostgreSQL verwenden direkte Datenbankverbindungen (ADO.NET).
Der OpenAPI-Konnektor kommuniziert ebenfalls über HTTP, leitet Pfade, Wrapper-Schlüssel und
Feldtypen jedoch aus einer OpenAPI-Spezifikation ab, statt sie fest zu verdrahten.
Zur Spalte Job-Filter
Die Spalte gibt an, ob das Feld Filter des Jobs vom Konnektor tatsächlich ausgewertet
wird. Bei MySQL, Oracle und PostgreSQL wird der Filter ignoriert — diese
Konnektoren lesen bei jedem Lauf den vollständigen Tabelleninhalt, unabhängig davon, was
im Job eingetragen ist.
Bei D365CE erfolgt die Auswertung nicht im Quellsystem, sondern clientseitig nach dem
Abruf. Siehe Jobs → Filter-Syntax.
Schreiben in SQL-Systeme
Keiner der vier SQL-Konnektoren unterstützt das Schreiben. Ein SQL-System als
TargetConnection führt zur Laufzeit zu einem Abbruch. Die SQL-Konnektoren sind derzeit
ausschließlich als Quellsystem einsetzbar.
Der OpenAPI-Konnektor
Der OpenAPI-Konnektor unterscheidet sich grundlegend von den übrigen HTTP-
Konnektoren: Er ist nicht auf ein bestimmtes System zugeschnitten, sondern bindet
beliebige REST-APIs an, für die eine OpenAPI-Spezifikation vorliegt. Pfade,
Wrapper-Schlüssel und Feldtypen werden zur Laufzeit aus der Spezifikation aufgelöst, statt
je System hartcodiert zu sein. Er befindet sich aktuell noch in Entwicklung.
Versionsangaben
Die auf den Konnektor-Seiten genannten Mindestversionen sind getestete Versionsstände.
Die DataBridge prüft die Version des angebundenen Systems nicht — ältere Stände können
funktionieren, sind aber nicht abgesichert. Bei Fragen zu einer konkreten Version bitte
WYSA kontaktieren.
4.1 - D365BC — Business Central
Konnektor für Microsoft Dynamics 365 Business Central. Unterstützt Lesen und Schreiben über OData v4.
Der D365BC-Konnektor verbindet die DataBridge mit Microsoft Dynamics 365 Business Central
über die OData-v4-REST-API (API-Version 2.0). Er unterstützt sowohl Cloud-Umgebungen
(OAuth2) als auch OnPremise-Installationen (Basic Auth).
Eigenschaft
Wert
Lesen
✅ unterstützt
Schreiben
✅ unterstützt
Job-Filter
✅ wird als OData-$filter an BC übergeben
Status
Freigegeben
Getestete Mindestversion
Business Central v17.0 (Oktober 2020)
Die Mindestversion wird nicht geprüft
Die Angabe zur Mindestversion beschreibt den getesteten Stand. Die DataBridge fragt die
Version von Business Central nicht ab und lehnt ältere Stände nicht ab. Ob eine ältere
Installation funktioniert, hängt allein davon ab, ob sie die verwendete API-Version 2.0
und die im Mapping genannten Felder bereitstellt.
Verbindungsparameter
Cloud-Umgebung (empfohlen)
{
"clientId": "<App-Registration Client ID>",
"clientSecret": "<App-Registration Client Secret>",
"tenantId": "<Entra Tenant ID>",
"environment": "<BC-Umgebungsname, z. B. production>",
"companyId": "<Company ID (GUID)>"}
Cloud-Umgebung mit Managed Identity (ab v2.3)
Ohne Client Secret, über die Managed Identity der Function App:
{
"authmethod": "ManagedIdentity",
"clientId": "<Client-ID der user-assigned Identity, optional>",
"environment": "<BC-Umgebungsname, z. B. production>",
"companyId": "<Company ID (GUID)>"}
Ohne clientId wird die system-zugewiesene Identity der Function App verwendet, mit clientId die benutzer-zugewiesene.
clientSecret und tenantId sind nicht nötig. Der Token wird mit dem scope der Connection angefordert und rechtzeitig vor Ablauf erneuert.
Managed Identity wird nur über authmethod aktiviert, nie automatisch.
Voraussetzung: Die Identity ist in Business Central unter Microsoft-Entra-Anwendungen angelegt, aktiviert und mit Berechtigungssätzen versehen.
Ist url gesetzt, wird daraus die Basisadresse gebildet (<url>/api/) und environment
nicht ausgewertet. Ist url leer, verwendet der Konnektor den Cloud-Endpunkt und bildet
die Adresse aus environment.
Die Auswahl des Authentifizierungsverfahrens erfolgt automatisch: Sind userName und
password gesetzt, wird Basic Auth verwendet, andernfalls OAuth2 Client Credentials aus
clientId, clientSecret und tenantId. Mit authmethod lässt sich die Methode ausdrücklich festlegen.
Optionale Parameter
Gelten für Cloud und OnPremise:
Parameter
Standardwert
Beschreibung
scope
https://api.businesscentral.dynamics.com/.default
OAuth2-Scope beim Token-Abruf
maxPageSize
5000
Maximale Datensätze pro Abruf-Seite
language
de-DE
Kultur für die Interpretation von Zahlen- und Datumsformaten
Protokolliert die vollständigen Anfragen beim Anlegen
logUpdateRequests
false
Protokolliert die vollständigen Anfragen beim Aktualisieren
logReceivedData
false
Protokolliert die vollständigen Antwortdaten
Die drei Diagnose-Schalter erzeugen erhebliche Datenmengen und können Geschäftsdaten im
Klartext protokollieren — nur gezielt für die Dauer einer Analyse aktivieren.
Vollständige Beschreibung unter Verbindungen.
Tabellen- und Feldnamen
SourceTable / TargetTable
Der Tabellenname leitet sich aus dem API-Pfad der Business-Central-API v2.0 ab —
ohne den Company-Teil der URL.
API-Typ
URL-Struktur
SourceTable
Standard-API
.../api/v2.0/companies({id})/customers
v2.0/customers
Custom API
.../api/{publisher}/{product}/{version}/entities
{publisher}/{product}/{version}/entities
SourceField / TargetField
Exakter Feldname aus der BC-API-Seite (case-sensitive). Zu finden in der
BC-API-Dokumentation oder über den API-Explorer in Business Central.
Unterstützte TargetKey-Typen
Typ
Beschreibung
PrimaryKey
Systemnativer BC-Primärschlüssel. Der Wert wird in Anführungszeichen gesetzt.
Id
BC-interne ID (GUID). Der Wert wird ohne Anführungszeichen eingesetzt.
CustomKey
Benutzerdefinierter Schlüssel über ein oder mehrere Felder
Filter
Suche über Feldwert-Kombination
PrimaryKey und Id sind nicht austauschbar
Der einzige Unterschied in der erzeugten Anfrage ist die Quotierung: PrimaryKey setzt
den Wert in einfache Anführungszeichen, Id nicht. Wird der falsche Typ gewählt, entsteht
eine syntaktisch ungültige OData-Adresse — eine GUID in Anführungszeichen oder ein
Textschlüssel ohne Anführungszeichen. Business Central quittiert das mit einem
Syntaxfehler, nicht mit einem leeren Ergebnis.
Statische Schlüsselwerte (ab v2.1)
In einem KeyValue kann statt attributeName ein StaticValue angegeben werden. Der
Schlüsselteil wird dann nicht aus dem Quelldatensatz gelesen, sondern fest gesetzt.
Statische Werte werden für die BC-Metadatentypen string, guid und int32 unterstützt.
Bei jedem anderen Typ des Schlüsselfeldes bricht die Verarbeitung mit einem Fehler ab
(Metadata type … not yet implemented for CreateKeyString).
Quotierung von String-Schlüsseln seit v2.1 korrigiert
Bis einschließlich v2.0 wurden Schlüsselwerte vom Typ string ohne umschließende
Anführungszeichen in den $filter geschrieben. Ein mehrteiliger Schlüssel mit einem
String-Anteil führte dadurch zu einer ungültigen Filterabfrage gegen BC. Seit v2.1 wird
korrekt quotiert.
SourceOperations
LookupValue
Liest einen Wert aus einer anderen BC-API-Tabelle nach.
LookupType kennt die beiden Werte Attribute und Name. Business Central
unterstützt ausschließlich Attribute; der Wert Name führt zu einem Abbruch
(SourceOperation for Lookups). Name ist dem D365CE-Konnektor vorbehalten.
ReadFromMessage
Liest einen Wert aus der BC-Antwort — nur in ResponseJobs.
Das SourceField muss einen _-Prefix haben.
Beim Schreiben bestimmt der Datentyp des Zielfeldes in den BC-Metadaten, welche
Umwandlung angewendet wird. Der Quelltyp stammt aus dem Feldtyp des Quellsystems und
entscheidet, ob die Umwandlung gelingt.
Zieltyp (BC-Metadaten)
Akzeptierte Quelltypen
Verhalten und Sonderfälle
Boolean
boolean, string
Leerwert → null. Ein nicht als Wahrheitswert lesbarer Text führt zum Abbruch.
Date
date, datetime, string
Ausgabe im Format yyyy-MM-dd. Leerwert → 0001-01-01. Nicht lesbares Datum → Abbruch.
DateTimeOffset
date, datetime, string
Ausgabe im Format yyyy-MM-ddTHH:mm:ss.fffZ. Leerwert → 0001-01-01T00:00:00.000Z.
Decimal
decimal, money, double
Interpretation mit der Kultur aus language. Leerwert → null.
Decimal
string(ab v2.1)
Interpretation immer als en-US (Punkt als Dezimaltrennzeichen), unabhängig von language.
Double(ab v2.1)
decimal, money, double
Interpretation mit der Kultur aus language. string wird nicht akzeptiert und führt zum Abbruch.
Leerwert → null. Nicht als Ganzzahl lesbarer Wert → Abbruch.
String
alle Quelltypen
Wert wird getrimmt. Leerwert → leerer String, das Zielfeld wird also geleert. Liegt eine OptionMapping-TargetOperation vor, wird stattdessen der zugeordnete Wert geschrieben; ein unbekannter Quellwert führt zum Abbruch.
Jeder in der Tabelle nicht genannte BC-Zieltyp führt beim Schreiben zu einem Abbruch
(No Resolver defined for edmPrimitiveTypeKind …).
Leerer String leert das Zielfeld
Business Central und NAV verhalten sich hier unterschiedlich: Der BC-Konnektor liefert
für einen leeren Quellwert einen leeren String und überschreibt damit den bisherigen
Inhalt des Zielfeldes. Der NAV-Konnektor liefert stattdessen null — das
Feld bleibt dort unverändert.
Schreibvorgang und Fehlerverhalten
Vor jedem Schreibvorgang sucht der Konnektor den bestehenden Zieldatensatz — je nach
TargetKey-Typ über den Schlüssel oder über einen Filter. Wird ein Datensatz gefunden,
erfolgt ein Update, andernfalls eine Neuanlage.
Seit v2.1 kein stilles Überspringen mehr
Bis v2.0 lieferte die Suche nach einem bestehenden Datensatz bei einem unerwarteten
HTTP-Status (etwa 500 oder 403) einen Leerwert zurück — für die DataBridge
ununterscheidbar von einem nicht vorhandenen Datensatz. Die Folge war eine Neuanlage und
damit Dubletten im Zielsystem.
Seit v2.1 werden ausschließlich Erfolgsmeldungen und 404 als gültige Antworten
akzeptiert. Jeder andere Status löst eine Ausnahme aus; die Verarbeitung der Nachricht
schlägt fehl und wird über die Service-Bus-Wiederholung erneut versucht.
ResponseJob — BC-IDs zurückschreiben
Wenn BC beim Anlegen eines Datensatzes eine neue ID vergibt (z. B. die Kundennummer),
kann diese über einen ResponseJob automatisch ins Quellsystem zurückgeschrieben werden.
Beispiel: CE-Kontakt nach BC anlegen und BC-ID zurück nach CE schreiben
Business Central liefert für jede Entität ein lastModifiedDateTime-Feld,
das beim Speichern automatisch aktualisiert wird.
Der Filterausdruck aus dem Job wird als OData-$filter an die BC-Anfrage angehängt.
Die Regeln zur Klammerung und zum Platzhalter %watermark% sind unter
Jobs → Filter-Syntax beschrieben.
4.2 - D365CE — Dataverse / Customer Engagement
Konnektor für Microsoft Dataverse und Dynamics 365 Customer Engagement. Unterstützt Lesen und Schreiben.
Der D365CE-Konnektor verbindet die DataBridge mit Microsoft Dataverse und
Dynamics 365 Customer Engagement über das offizielle Dataverse SDK.
Er nutzt die Change Tracking API für eine lückenlose Erkennung aller Änderungen.
Eigenschaft
Wert
Lesen
✅ unterstützt
Schreiben
✅ unterstützt
Job-Filter
✅ clientseitig nach dem Abruf
Status
Freigegeben
Getestete Mindestversion
Dataverse / D365CE v9.1
Die Mindestversion beschreibt den getesteten Stand; eine Versionsprüfung findet im Code
nicht statt.
Voraussetzung: Change Tracking aktivieren
Für alle Dataverse-Tabellen, die als Quelle genutzt werden, muss Change Tracking
aktiviert sein. Ohne Change Tracking kann der Konnektor keine Differenzabfragen
durchführen.
Aktivierung: Power Platform Admin Center → Umgebung → Tabellen → Tabelle auswählen
→ Eigenschaften → Änderungsnachverfolgung aktivieren ✅
Statt eines Connection-Strings mit Secret kann die Verbindung über eine Managed Identity
aufgebaut werden:
{
"url": "https://<org>.crm4.dynamics.com",
"clientid": "<Client-ID der user-assigned Identity, optional>"}
Ohne clientid wird die system-zugewiesene Identity der Function App verwendet, mit clientid die benutzer-zugewiesene.
Ist connectionstring gesetzt, hat er immer Vorrang; url wird dann ignoriert.
Sind weder connectionstring noch url gesetzt, bricht der Verbindungsaufbau mit einem Fehler ab.
Voraussetzung: Die Identity ist in der Dataverse-Umgebung als Application User angelegt und hat eine passende Sicherheitsrolle (Power Platform Admin Center → Umgebung → Einstellungen → Benutzer + Berechtigungen → Anwendungsbenutzer).
Zusätzlich stehen die universellen Parameter keyVaultUrl, maxPageSize, language und
httpClientTimeoutSeconds zur Verfügung — siehe
Verbindungen.
Tabellen- und Feldnamen
SourceTable / TargetTable
Logischer Entitätsname in Kleinbuchstaben — so wie er in den Dataverse-Metadaten steht.
Entität
SourceTable
Account
account
Contact
contact
Custom Entity
wysa_bcsegment
SourceField / TargetField
Logischer Attributname in Kleinbuchstaben.
Attribut
SourceField
Account Name
name
Custom Field
wysa_bcsystemid
Unterstützte TargetKey-Typen
Typ
Beschreibung
PrimaryKey
Dataverse GUID (Primärschlüssel der Entität)
CustomKey
Benutzerdefinierter Schlüssel über ein oder mehrere Felder (Alternate Key)
Filter
Suche über Feldwert-Kombination ohne expliziten Schlüssel
Bei CustomKey werden Schlüsselteile vom Typ int32, guid und string unterstützt;
jeder andere Typ führt zum Abbruch (keytype … not yet supported for key …).
Leere Schlüsselteile werden übersprungen — bleibt danach kein Teil übrig, gilt der
Schlüssel als nicht auflösbar.
Ist der Alternativschlüssel in Dataverse nicht angelegt oder nicht aktiv, bricht die Suche
mit einem Fehler ab (ab v2.3). Die Nachricht landet nach den Wiederholungen in der
Dead-Letter-Queue und wird nicht als neuer Datensatz angelegt. Bis v2.2 wurde dieser
Fall wie „Datensatz nicht gefunden“ behandelt, was zu Dubletten führen konnte.
Ein KeyValue kann statt attributeName ein StaticValue enthalten; der Schlüsselteil
wird dann fest gesetzt und als Typ string behandelt.
Der Typ `Id` existiert im CE-Konnektor nicht
Anders als bei D365BC und D365NAV kennt der CE-Konnektor
keinen TargetKey-Typ Id. Ein unbekannter oder falsch geschriebener KeyType löst
keinen Fehler aus, sondern nur eine Warnung im Log
(Undefined Key definition for InitiateEntityWithKey); der Schlüssel gilt anschließend
als nicht auflösbar.
Für die Fehlersuche bedeutet das: Ein Lookup, das dauerhaft leer bleibt, oder ein Upsert,
der scheinbar wirkungslos ist, kann schlicht an einem ungültigen KeyType liegen. Der
Hinweis erscheint ausschließlich als Warnung, nicht als Ausnahme.
Mehrere Ziel-Schlüssel mit Rangfolge (ab v2.1)
Statt eines einzelnen TargetKey lässt sich eine Liste TargetKeys angeben. Die
Schlüssel werden nach KeyRankaufsteigend geprüft; der erste Schlüssel, der im
Zielsystem einen Datensatz findet, gewinnt — alle weiteren werden übersprungen.
LookupType kennt zwei Werte. Nur der CE-Konnektor unterstützt beide:
Wert
Wirkung
Attribute
Der genannte LookupField-Wert wird aus dem verknüpften Datensatz gelesen
Name
Der Anzeigename der Referenz wird direkt aus dem Quelldatensatz übernommen — ohne zusätzliche Abfrage
Vorab-Zwischenspeicherung von Lookups (ab v2.1)
Der CE-Konnektor löst benötigte Lookup-Werte vor der Verarbeitung eines Batches gebündelt
auf und legt sie im Cache ab. Die IDs werden dazu in Blöcken zu je 1.000 Stück abgefragt,
statt jeden Wert einzeln nachzuschlagen. Das beschleunigt die Verarbeitung großer
Änderungsmengen spürbar.
Die Vorab-Auflösung greift nur bei UseCache: true. Ohne diese Option bleibt es bei
Einzelabfragen. Die Funktion ist dem CE-Konnektor vorbehalten — D365BC und D365NAV
verfügen nicht darüber.
ReadFromMessage
Liest Werte aus einer vorherigen Quellanfrage — nur in ResponseJobs.
Verhalten wie beim D365BC-Konnektor.
ActivityParty
Liest ein Feld über eine ActivityParty-Beziehung. Wird für CE-Aktivitäten
(E-Mails, Aufgaben, Anrufe) verwendet, bei denen Teilnehmer über den
activityparty-Datensatz verknüpft sind.
TypeMask entspricht dem Dataverse-Feld participationtypemask und wird von der
DataBridge unverändert an die Abfrage durchgereicht. Die gültigen Werte gibt die
Dataverse-Plattform vor; die gebräuchlichsten sind:
TypeMask
Teilnehmerrolle
1
From (Absender)
2
To (Empfänger)
3
CC
4
BCC
Diese Tabelle ist eine Plattform-Referenz, keine Festlegung der DataBridge. Die
verbindliche und vollständige Liste steht in der Microsoft-Dokumentation zur Entität
activityparty.
LinkToRecord
Erzeugt eine anklickbare URL zu einem Datensatz in Dataverse.
Befüllt ein Lookup-Feld in Dataverse, indem der verknüpfte Datensatz über eine
Feldwert-Kombination gesucht wird. Die Operation gehört in die Spalte TargetOperation
des Mappings und benötigt zwingend den Operations-Rahmen, den Namen Lookup sowie
TargetTable.
Ohne TargetTable ist nicht bestimmt, in welcher Entität gesucht werden soll — die
Operation schlägt fehl. Fehlt der Operations-Rahmen oder der Name, wird die Operation
gar nicht erst erkannt und die Verarbeitung bricht mit Lookup Operation missing ab.
Wird kein passender Datensatz gefunden, legt die DataBridge standardmäßig einen neuen an.
Weitere Parameter der TargetOperation
Parameter
Wirkung
TargetTable
Entität, in der gesucht wird. Bei Lookup Pflicht.
TargetKey / TargetKeys
Schlüssel bzw. Schlüsselliste zur Suche (siehe oben)
DefaultValue
Fester Wert, der ohne Suche gesetzt wird. Bei Lookup-Feldern eine GUID; bei Options-Feldern der numerische Optionswert.
SetNullIfEqualsValueOfField
Name des Primärschlüsselfeldes. Stimmt der aufzulösende Wert mit dem Schlüssel des Quelldatensatzes überein, wird null gesetzt statt eine Selbstreferenz zu erzeugen.
OptionDelimiter
Trennzeichen, mit dem ein Quellwert für ein MultiSelect-Feld in Einzelwerte zerlegt wird
DoNotCreate
true verhindert die automatische Neuanlage (siehe unten)
DoNotCreate (ab v2.1)
Ist DoNotCreate auf true gesetzt, wird der Zieldatensatz eines Lookups nur dann
verknüpft, wenn er bereits existiert. Wird er nicht gefunden, bleibt das Feld leer —
es entsteht kein neuer Datensatz.
Ein leerer Value setzt das Zielfeld auf null. Ein Quellwert, der in der Liste nicht
vorkommt, führt zum Abbruch (Could not find TableMapping for …).
Kodierung von Sonderzeichen — Praxisbeobachtung
In der Praxis liefert Business Central Sonderzeichen in Optionswerten kodiert:
Leerzeichen als _x0020_, Bindestrich als _x002D_. Diese kodierten Werte sind als Key
exakt so einzutragen, wie sie von BC geliefert werden.
Es handelt sich um eine Beobachtung aus laufenden Installationen, nicht um eine
Umwandlung, die die DataBridge selbst vornimmt — der Vergleich erfolgt zeichengenau
(Groß-/Kleinschreibung wird ignoriert). Im Zweifel den tatsächlich gelieferten Wert über
logReceivedData an der Quellverbindung prüfen.
Datentypen — Zieltyp und akzeptierte Quelltypen
Beim Schreiben bestimmt der Attributtyp des Zielfeldes aus den Dataverse-Metadaten,
welche Umwandlung angewendet wird.
Zielattribut (Dataverse)
Akzeptierte Quelltypen
Verhalten und Sonderfälle
BigIntAttributeMetadata
int64, int32
Leerwert → null
BooleanAttributeMetadata
boolean, string, byte(ab v2.3), int32(ab v2.3)
Leerwert → null; bei Ganzzahlen 0 → Nein, sonst Ja
DateTimeAttributeMetadata
date, datetime, string
Leerwert → null; auch 0001-01-01 wird zu null
DecimalAttributeMetadata
decimal, money
Interpretation mit der Kultur aus language
DecimalAttributeMetadata
string(ab v2.1)
Interpretation immer als en-US, unabhängig von language
DoubleAttributeMetadata
double, decimal
Interpretation mit der Kultur aus language. string wird nicht akzeptiert.
EntityNameAttributeMetadata
alle Quelltypen
Wird als Text behandelt; Leerwert → null
IntegerAttributeMetadata
int32, optionsetvalue, string
Leerwert → null
LookupAttributeMetadata
typunabhängig
Erfordert eine Lookup- oder DefaultValue-TargetOperation, sonst Lookup Operation missing
MemoAttributeMetadata
alle Quelltypen
Wird als Text behandelt; Leerwert → null
MoneyAttributeMetadata
nur decimal
money, double und string führen zum Abbruch
MultiSelectPicklistAttributeMetadata
nur string
Erfordert OptionMapping; Zerlegung über OptionDelimiter. Leerwert → null
PicklistAttributeMetadata
string, int32
Erfordert OptionMapping oder DefaultValue
StateAttributeMetadata
boolean, string, int32, byte(ab v2.3)
Erfordert OptionMapping oder DefaultValue
StatusAttributeMetadata
string, int32
Erfordert OptionMapping oder DefaultValue
StringAttributeMetadata
alle Quelltypen
Wert wird getrimmt; Leerwert → null
Sonderfälle jenseits der Tabelle:
UniqueIdentifierAttributeMetadata sowie Primärschlüssel- und logische Attribute
(z. B. statuscodename) werden beim Schreiben stillschweigend übersprungen
FileAttributeMetadata und ImageAttributeMetadata werden nicht unterstützt
(type not supported)
Jeder sonstige, nicht aufgeführte Attributtyp führt zum Abbruch
(Type … not yet implemented)
Die Zahlentypen verhalten sich bewusst unterschiedlich
Die drei numerischen Zieltypen akzeptieren nicht dieselben Quelltypen:
Decimal akzeptiert seit v2.1 auch string — dann aber immer im Format en-US.
Ein deutsch formatierter Text wie 1.234,56 wird dabei falsch oder gar nicht gelesen.
Money akzeptiert ausschließlichdecimal. Ein Quellfeld, das als money oder
double typisiert ankommt, führt zum Abbruch — auch wenn der Wert inhaltlich passt.
Double akzeptiert keinen string.
Zeigt ein Mapping Source Type not yet implemented, liegt in aller Regel eine dieser drei
Abweichungen vor.
Sonderentitäten
Einige Dataverse-Entitäten werden nicht über den generischen Weg verarbeitet.
listmember — Marketinglisten
Datensätze der Entität listmember werden nicht über den generischen Schreibpfad
angelegt oder gelöscht, sondern über die Dataverse-Nachrichten AddMemberList bzw.
RemoveMemberList. Das Mapping muss daher die Felder listid und entityid befüllen —
sie liefern die Kennungen für die beiden Nachrichten.
Entitäten ohne statuscode
Für die folgenden Entitäten wird das Attribut statuscode beim Lesen automatisch aus der
Spaltenliste entfernt, weil sie es nicht besitzen:
Entität
listmember
quotedetail
opportunityproduct
salesorderdetail
Ein Job-Filter mit der Operation StatusCode ist für diese Entitäten folglich nicht
verwendbar.
Job-Filter
Der CE-Konnektor wertet das Feld Filter des Jobs clientseitig aus: Die Datensätze
werden über die Change Tracking API abgerufen und anschließend geprüft; nicht passende
Datensätze werden verworfen.
Unterstützt werden die Operationen Equals, Boolean, OptionSetValue, NotNull,
IsNull und StatusCode. Ein anderer Operationsname führt zum Abbruch
(Undefined FilterOperation).
beliebig (wird von der Change Tracking API intern verwaltet)
Der CE-Konnektor nutzt die Dataverse Change Tracking API. Diese liefert bei jedem
Abruf einen opaken Token, der beim nächsten Aufruf übergeben wird. So werden alle
Änderungen erfasst — auch wenn der Timer genau während einer Änderung ausgeführt wird.
4.3 - D365NAV — Microsoft Dynamics NAV
Konnektor für Microsoft Dynamics NAV. Unterstützt Lesen und Schreiben über OData.
Der D365NAV-Konnektor verbindet die DataBridge mit Microsoft Dynamics NAV
über OData. Er ist auf die ältere NAV-API-Struktur ausgelegt und unterstützt auch
OnPremise-Installationen mit NTLM-Authentifizierung.
Eigenschaft
Wert
Lesen
✅ unterstützt
Schreiben
✅ unterstützt
Job-Filter
✅ wird als OData-$filter an NAV übergeben
Status
Freigegeben
Getestete Mindestversion
NAV 2018
Die Mindestversion wird nicht geprüft
Die Angabe beschreibt den getesteten Stand. Die DataBridge fragt die NAV-Version nicht
ab. Ältere Installationen können funktionieren, sofern sie OData mit $metadata
bereitstellen — abgesichert ist das jedoch nicht.
Nicht alle BC-Funktionen stehen auch in NAV zur Verfügung
Der NAV-Konnektor ist dem D365BC-Konnektor nachempfunden, aber nicht mit
ihm identisch. Die wichtigsten Abweichungen:
Statische Schlüsselwerte (StaticValue) werden nicht unterstützt. Die Schlüssel-
und Filtererzeugung greift stets auf attributeName zu; ein KeyValue ohne
attributeName führt zum Abbruch.
Ein leerer Textwert wird als null geschrieben, nicht als leerer String — das
Zielfeld bleibt damit unverändert, statt geleert zu werden.
LookupType: Name wird nicht unterstützt (siehe SourceOperations).
baseAddress ersetzt urlnicht. Sämtliche Anfrage-Adressen — Datenabruf,
Metadaten, Schreib- und Löschvorgänge — werden aus url gebildet. Fehlt der Parameter,
bricht der Konnektor beim ersten Aufruf mit einem Fehler ab.
baseAddress wird ausschließlich bei authenticationMethod = NTLM für den
NTLM-Credential-Cache verwendet und ist ansonsten entbehrlich.
Ein fehlender Schrägstrich am Ende von url wird automatisch ergänzt.
Die Metadaten werden eine Ebene oberhalb von url abgefragt. Aus
https://<server>:<port>/<instanz>/ODataV4/Company('CRONUS')/ wird also
https://<server>:<port>/<instanz>/ODataV4/$metadata. Antwortet der Server dort nicht mit einem
Erfolgsstatus, bricht der Konnektor mit Could not read Metadata from <URL> (StatusCode: …) ab.
`authenticationMethod` wirkt nur beim Wert NTLM
Nur der Wert NTLM (Groß-/Kleinschreibung egal) schaltet auf NTLM-Authentifizierung um —
und auch das nur, wenn zusätzlich userName und password gesetzt sind.
Bei jedem anderen Wert — auch beim Vorgabewert Basic — entscheidet die DataBridge
automatisch anhand der vorhandenen Felder: userName + password ergibt Basic Auth,
sonst clientId + clientSecret + tenantId für OAuth2. Ein Tippfehler im Wert bleibt
daher folgenlos, solange nicht NTLM benötigt wird.
Optionale Parameter
Parameter
Standardwert
Beschreibung
scope
https://api.businesscentral.dynamics.com/.default
OAuth2-Scope beim Token-Abruf
baseAddress
(leer)
Basis-Adresse für den NTLM-Credential-Cache
authenticationMethod
Basic
Siehe Hinweis oben
maxPageSize
5000
Maximale Datensätze pro Abruf-Seite
language
de-DE
Kultur für die Interpretation von Zahlen- und Datumsformaten
Protokolliert die vollständigen Anfragen beim Anlegen
logUpdateRequests
false
Protokolliert die vollständigen Anfragen beim Aktualisieren
logReceivedData
false
Protokolliert die vollständigen Antwortdaten
Die drei Diagnose-Schalter erzeugen erhebliche Datenmengen und können Geschäftsdaten im
Klartext protokollieren — nur gezielt für die Dauer einer Analyse aktivieren.
Vollständige Beschreibung unter Verbindungen.
Tabellen- und Feldnamen
SourceTable / TargetTable: Name des OData-EntitySets, so wie er in $metadata steht
SourceField / TargetField: Exakter Feldname aus der NAV-OData-API (case-sensitive)
Unterstützte TargetKey-Typen
Typ
Beschreibung
PrimaryKey
NAV-nativer Primärschlüssel. Der Wert wird in Anführungszeichen gesetzt.
Id
Systemeigene ID. Der Wert wird ohne Anführungszeichen eingesetzt.
CustomKey
Benutzerdefinierter Schlüssel über ein oder mehrere Felder
Filter
Suche über Feldwert-Kombination
Bei CustomKey werden die Metadatentypen int32 und string unterstützt, bei Filter
die Typen string und guid. Jeder andere Typ des Schlüsselfeldes führt zum Abbruch
(Metadata type … not yet implemented for CreateKeyString).
Kein `StaticValue` in NAV-Schlüsseln
Die für D365BC ab v2.1 verfügbaren statischen Schlüsselwerte gibt es im
NAV-Konnektor nicht. Jeder Schlüsselteil muss über attributeName auf ein Quellfeld
verweisen. Ein KeyValue, das nur StaticValue enthält, führt beim Verarbeiten zu einem
Fehler, weil der Zugriff auf das Quellattribut ins Leere läuft.
SourceOperations
LookupValue
Liest einen Wert aus einer anderen NAV-Tabelle nach — Aufbau und Parameter wie beim
D365BC-Konnektor.
Leerwert → null. Nicht als Ganzzahl lesbarer Wert → Abbruch.
String
alle Quelltypen
Wert wird getrimmt. Leerwert → null. Liegt eine OptionMapping-TargetOperation vor, wird stattdessen der zugeordnete Wert geschrieben; ein unbekannter Quellwert führt zum Abbruch.
Jeder in der Tabelle nicht genannte NAV-Zieltyp führt beim Schreiben zu einem Abbruch
(No Resolver defined for edmPrimitiveTypeKind …).
Leerer Textwert leert das Zielfeld nicht
Das ist der wichtigste Unterschied zu Business Central. Ein leerer Quellwert wird in NAV
als null übergeben — das Zielfeld behält damit seinen bisherigen Inhalt. Soll ein Feld
im Zielsystem tatsächlich geleert werden, lässt sich das über einen leeren Textwert
nicht erreichen.
ResponseJob
Der NAV-Konnektor unterstützt das ResponseJob-Muster wie D365BC: Nach erfolgreichem
Schreiben in NAV kann ein ResponseJob ausgelöst werden, der Felder aus der NAV-Antwort
(z. B. neu vergebene Nummern) zurück ins Quellsystem schreibt. Aufbau und Konfiguration
sind unter D365BC → ResponseJob beschrieben.
Änderungserkennung (Watermark)
Eigenschaft
Wert
Empfohlener WatermarkType
datetime oder date
Typisches WatermarkField
Systemabhängig — z. B. Last_Date_Modified, Timestamp
Filterformat
{{WatermarkField gt %watermark%}}
Im Gegensatz zu Business Central gibt es kein einheitliches lastModifiedDateTime-Feld.
Das korrekte Watermark-Feld hängt von der NAV-Version und der verwendeten Seite bzw.
Codeunit ab. Im Zweifelsfall mit dem NAV-Administrator klären.
Der Filterausdruck aus dem Job wird als OData-$filter an die NAV-Anfrage angehängt.
Die Regeln zur Klammerung und zum Platzhalter %watermark% sind unter
Jobs → Filter-Syntax beschrieben.
Fehlersuche
Fehler beim Schreiben werden mit dem Text Error in NAV-Communication protokolliert,
zusammen mit der verwendeten relativen Adresse sowie dem neuen und dem bestehenden
Datensatz. Bis einschließlich v2.0 lautete derselbe Text irreführend
Error in BC-Communication — ältere Logeinträge einer NAV-Verbindung sind also trotz
BC-Nennung dem NAV-Konnektor zuzuordnen.
4.4 - MSSQL — Microsoft SQL Server
Konnektor für Microsoft SQL Server. Lesen wird unterstützt — Schreiben nicht.
Preview
Der MSSQL-Konnektor ist als Vorabversion eingestuft. Lesen ist funktionsfähig,
Schreiben wird nicht unterstützt. Vor einem produktiven Einsatz bitte WYSA kontaktieren.
Der MSSQL-Konnektor ermöglicht das Lesen von Daten aus Microsoft SQL Server-Datenbanken
(OnPremise und Azure SQL) und deren Übertragung in andere Systeme.
Eigenschaft
Wert
Lesen
⚠️ Preview
Schreiben
— nicht unterstützt
Job-Filter
✅ wird als WHERE-Klausel übernommen
Status
Preview
Wie die übrigen drei SQL-Konnektoren wertet MSSQL den Filter des Jobs aus und erzeugt
gültiges Paging für sein Datenbanksystem.
Schreiben wird nicht unterstützt
Ein MSSQL-System als TargetConnection führt zur Laufzeit zu einem Abbruch. Der
Konnektor ist ausschließlich als Quellsystem einsetzbar. Auch das Löschen von Datensätzen
ist nicht implementiert.
Tabellenname, ggf. mit Schema-Präfix (z. B. Customers, dbo.Orders)
SourceField
Spaltenname. Wird automatisch in eckige Klammern gesetzt (ab v2.3; bis v2.2 nur bei Namen mit Leerzeichen).
Der Wert aus SourceTable wird unverändert hinter FROM eingesetzt.
Spaltennamen ohne Klammern angeben
SourceField und WatermarkField müssen exakt dem Spaltennamen in der Tabelle entsprechen,
ohne eckige Klammern, Tabellen-Alias, Schema-Präfix oder Ausdruck. Die DataBridge setzt
die Klammern selbst. Der Wert wird anschließend über diesen Namen aus dem Ergebnis gelesen;
[Spalte], t.Spalte oder UPPER(Spalte) werden dort nicht gefunden und führen zum Abbruch.
Änderungserkennung (Watermark)
Die Erkennung basiert auf einer Zeitstempel-Spalte in der SQL-Tabelle. Diese Spalte muss
beim Einfügen oder Ändern eines Datensatzes automatisch aktualisiert werden.
Eigenschaft
Wert
WatermarkType
date oder datetime
WatermarkField
Name der Zeitstempel-Spalte (z. B. ModifiedAt, UpdatedDate); wird wie SourceField in eckige Klammern gesetzt
Die Spalte aus WatermarkField wird zusätzlich zu den gemappten Feldern abgefragt und für
die Sortierung (ORDER BY … ASC) verwendet.
Empfehlung: echtes Datum als Watermark-Spalte
Spalten vom Typ datetime, datetime2, smalldatetime oder date sind vorgesehen und
werden als ISO-Zeitstempel weitergereicht. Eine Spalte anderen Typs — etwa rowversion,
timestamp oder bigint — führt nicht mehr zu einem Abbruch, wird aber unverändert über
ToString() weitergegeben; die Sortierung (ORDER BY … ASC) erfolgt weiterhin nach dem
Spaltentyp der Datenbank, nicht nach dem Textwert.
Filter — die WHERE-Klausel kommt aus dem Job
Die WHERE-Klausel wird nicht erzeugt, sondern übernommen
Die DataBridge baut keine Bedingung aus WatermarkField und Watermark zusammen. Der
Inhalt des Feldes Filter am Job wird — nach Ersetzung des Platzhalters %watermark% —
wörtlich hinter WHERE eingesetzt.
Daraus folgt:
Ohne Eintrag im Feld Filter entsteht keine WHERE-Klausel. Der Job liest bei
jedem Lauf die vollständige Tabelle.
Der Ausdruck muss gültiges T-SQL sein. Ein Syntaxfehler im Filter führt zu einer
fehlgeschlagenen Abfrage.
Es findet keine Parametrisierung statt. Der Filtertext wird als Zeichenkette in die
Abfrage eingesetzt; der Zugriff auf die jobs-Tabelle ist entsprechend zu beschränken.
Ein typischer Filter für eine MSSQL-Quelle:
{{ModifiedAt > '%watermark%'}}
Die Klammerung {{ … }} sorgt dafür, dass der Block bei leerer Watermark vollständig
entfällt — der Erstlauf liest dann den gesamten Bestand. Die vollständigen Regeln stehen
unter Jobs → Filter-Syntax.
Datentypen — gelesene Werte
Da Schreiben nicht unterstützt wird, ist beim MSSQL-Konnektor allein der Lesepfad
relevant. Der Typ ergibt sich aus dem ADO.NET-Spaltentyp; der so ermittelte Typname wird
zusammen mit dem formatierten Wert an den Zielkonnektor weitergereicht und dort für die
Auswahl der Umwandlung verwendet.
ADO.NET-Spaltentyp
Weitergegebener Typ
Formatierung des Wertes
Int32
int32
Wird als Ganzzahl gelesen und in der Kultur aus language ausgegeben
Decimal
decimal
Wird als Dezimalzahl gelesen und in der Kultur aus language ausgegeben
Double
double
Wie Decimal — Umwandlung über einen Dezimalwert
DateTime
datetime
Format u, also yyyy-MM-dd HH:mm:ssZ
alle übrigen
Name des .NET-Typs (z. B. string, boolean, guid)
Unveränderte Textdarstellung
`language` wirkt auf Zahlenwerte
Zahlen werden in der Kultur der Quellverbindung formatiert. Steht dort der Vorgabewert
de-DE, wird ein Komma als Dezimaltrennzeichen ausgegeben. Zielkonnektoren, die einen
Textwert zwingend als en-US lesen — etwa die String-zu-Decimal-Umwandlung ab v2.1 —
interpretieren das falsch. In gemischten Szenarien ist language an der Quellverbindung
entsprechend zu setzen.
Welche Quelltypen ein Zielsystem akzeptiert, steht auf der jeweiligen Zielkonnektor-Seite:
D365BC, D365CE, D365NAV.
4.5 - MySQL — MySQL / MariaDB
Konnektor für MySQL und MariaDB. Preview — derzeit nicht für den produktiven Einsatz geeignet.
Preview — nicht produktionsreif
Der MySQL-Konnektor ist als Vorabversion eingestuft und für den produktiven Einsatz
derzeit nicht geeignet. Er ist weder freigegeben noch für den Regelbetrieb
abgesichert.
Wer MySQL oder MariaDB anbinden möchte, wendet sich bitte vorab an WYSA — dort wird der
konkrete Anwendungsfall geprüft und der aktuelle Stand mitgeteilt.
Der MySQL-Konnektor ist für das Lesen von Daten aus MySQL- und MariaDB-Datenbanken
vorgesehen.
Eigenschaft
Wert
Lesen
⚠️ Preview, nicht produktionsreif
Schreiben
— nicht unterstützt
Job-Filter
✅ wird als WHERE-Klausel übernommen
Status
Preview
Wie beim MSSQL-Konnektor wird der Inhalt des Feldes Filter am Job — nach
Ersetzung des Platzhalters %watermark% — wörtlich hinter WHERE eingesetzt. Ohne Eintrag
im Feld Filter entsteht keine WHERE-Klausel und der Job liest bei jedem Lauf die
vollständige Tabelle. Der Ausdruck muss gültiges MySQL-SQL sein; es findet keine
Parametrisierung statt. Details zur Filter-Syntax siehe MSSQL — Filter.
Schreiben wird nicht unterstützt
Ein MySQL-System als TargetConnection führt zur Laufzeit zu einem Abbruch. Auch das
Löschen von Datensätzen ist nicht implementiert.
Die Spalte aus WatermarkField wird zusätzlich zu den gemappten Feldern abgefragt und für
die Sortierung verwendet.
Empfehlung: echtes Datum als Watermark-Spalte
Geeignet sind datetime, timestamp und date — der Wert wird dann als ISO-Zeitstempel
weitergereicht. Eine Spalte anderen Typs, etwa bigint oder int, führt nicht mehr zu
einem Abbruch, wird aber unverändert über ToString() weitergegeben.
Datentypen — gelesene Werte
Da Schreiben nicht unterstützt wird, ist allein der Lesepfad relevant. Der Typ ergibt sich
aus dem ADO.NET-Spaltentyp; der so ermittelte Typname wird zusammen mit dem formatierten
Wert an den Zielkonnektor weitergereicht und dort für die Auswahl der Umwandlung
verwendet.
ADO.NET-Spaltentyp
Weitergegebener Typ
Formatierung des Wertes
Int32
int32
Wird als Ganzzahl gelesen und in der Kultur aus language ausgegeben
Decimal
decimal
Wird als Dezimalzahl gelesen und in der Kultur aus language ausgegeben
Double
double
Wie Decimal — Umwandlung über einen Dezimalwert
DateTime
datetime
Format u, also yyyy-MM-dd HH:mm:ssZ
alle übrigen
Name des .NET-Typs (z. B. string, boolean, guid)
Unveränderte Textdarstellung
Welche Quelltypen ein Zielsystem akzeptiert, steht auf der jeweiligen Zielkonnektor-Seite:
D365BC, D365CE, D365NAV.
4.6 - Oracle — Oracle Database
Konnektor für Oracle Database. Preview — derzeit nicht für den produktiven Einsatz geeignet.
Preview — nicht produktionsreif
Der Oracle-Konnektor ist als Vorabversion eingestuft und für den produktiven Einsatz
derzeit nicht geeignet. Er ist weder freigegeben noch für den Regelbetrieb
abgesichert.
Wer eine Oracle-Datenbank anbinden möchte, wendet sich bitte vorab an WYSA — dort wird der
konkrete Anwendungsfall geprüft und der aktuelle Stand mitgeteilt.
Der Oracle-Konnektor ist für das Lesen von Daten aus Oracle-Database-Instanzen
vorgesehen.
Eigenschaft
Wert
Lesen
⚠️ Preview, nicht produktionsreif
Schreiben
— nicht unterstützt
Job-Filter
✅ wird als WHERE-Klausel übernommen
Status
Preview
Wie beim MSSQL-Konnektor wird der Inhalt des Feldes Filter am Job — nach
Ersetzung des Platzhalters %watermark% — wörtlich hinter WHERE eingesetzt. Ohne Eintrag
im Feld Filter entsteht keine WHERE-Klausel und der Job liest bei jedem Lauf die
vollständige Tabelle. Der Ausdruck muss gültiges PL/SQL sein; es findet keine
Parametrisierung statt. Details zur Filter-Syntax siehe MSSQL — Filter.
Schreiben wird nicht unterstützt
Ein Oracle-System als TargetConnection führt zur Laufzeit zu einem Abbruch. Auch das
Löschen von Datensätzen ist nicht implementiert.
Tabellenname, ggf. mit Schema-Präfix (SCHEMA.TABLENAME)
SourceField
Spaltenname, wie in Oracle definiert (üblicherweise Großbuchstaben)
Änderungserkennung (Watermark)
Eigenschaft
Wert
WatermarkType
date oder datetime
WatermarkField
Name der Zeitstempel-Spalte
Die Spalte aus WatermarkField wird zusätzlich zu den gemappten Feldern abgefragt und für
die Sortierung verwendet.
Empfehlung: echtes Datum als Watermark-Spalte
Geeignet sind DATE und TIMESTAMP — der Wert wird dann als ISO-Zeitstempel
weitergereicht. Eine Spalte anderen Typs, etwa NUMBER, führt nicht mehr zu einem Abbruch,
wird aber unverändert über ToString() weitergegeben.
Datentypen — gelesene Werte
Da Schreiben nicht unterstützt wird, ist allein der Lesepfad relevant. Der Typ ergibt sich
aus dem ADO.NET-Spaltentyp; der so ermittelte Typname wird zusammen mit dem formatierten
Wert an den Zielkonnektor weitergereicht und dort für die Auswahl der Umwandlung
verwendet.
ADO.NET-Spaltentyp
Weitergegebener Typ
Formatierung des Wertes
Int32
int32
Wird als Ganzzahl gelesen und in der Kultur aus language ausgegeben
Decimal
decimal
Wird als Dezimalzahl gelesen und in der Kultur aus language ausgegeben
Double
double
Wie Decimal — Umwandlung über einen Dezimalwert
DateTime
datetime
Format u, also yyyy-MM-dd HH:mm:ssZ
alle übrigen
Name des .NET-Typs (z. B. string, boolean, guid)
Unveränderte Textdarstellung
Oracle liefert Zahlen häufig als NUMBER
Oracle bildet NUMBER je nach Präzision auf unterschiedliche .NET-Typen ab. Welcher Typ
tatsächlich weitergegeben wird, ist daher vom Spaltenaufbau abhängig und im Einzelfall zu
prüfen.
Welche Quelltypen ein Zielsystem akzeptiert, steht auf der jeweiligen Zielkonnektor-Seite:
D365BC, D365CE, D365NAV.
4.7 - PostgreSQL
Konnektor für PostgreSQL. Preview — Lesen mit Filterunterstützung, Schreiben nicht unterstützt.
Preview
Der PostgreSQL-Konnektor ist als Vorabversion eingestuft. Lesen ist funktionsfähig,
Schreiben wird nicht unterstützt. Vor einem produktiven Einsatz bitte WYSA kontaktieren.
Der PostgreSQL-Konnektor ermöglicht das Lesen von Daten aus PostgreSQL-Datenbanken
und deren Übertragung in andere Systeme.
Eigenschaft
Wert
Lesen
⚠️ Preview
Schreiben
— nicht unterstützt
Job-Filter
✅ wird als WHERE-Klausel übernommen
Status
Preview
Wie beim MSSQL-Konnektor wird der Inhalt des Feldes Filter am Job — nach
Ersetzung des Platzhalters %watermark% — wörtlich hinter WHERE eingesetzt. Ohne Eintrag
im Feld Filter entsteht keine WHERE-Klausel und der Job liest bei jedem Lauf die
vollständige Tabelle. Der Ausdruck muss gültiges PostgreSQL-SQL sein; es findet keine
Parametrisierung statt. Details zur Filter-Syntax siehe MSSQL — Filter.
Schreiben wird nicht unterstützt
Ein PostgreSQL-System als TargetConnection führt zur Laufzeit zu einem Abbruch. Der
Konnektor ist ausschließlich als Quellsystem einsetzbar. Auch das Löschen von Datensätzen
ist nicht implementiert.
Tabellenname, ggf. mit Schema-Präfix (z. B. public.customers)
SourceField
Spaltenname (in PostgreSQL üblicherweise Kleinbuchstaben)
Der Wert aus SourceTable wird unverändert hinter FROM eingesetzt.
Änderungserkennung (Watermark)
Eigenschaft
Wert
WatermarkType
date oder datetime
WatermarkField
Name der Zeitstempel-Spalte
Die Spalte aus WatermarkField wird zusätzlich zu den gemappten Feldern abgefragt und für
die Sortierung (ORDER BY … ASC) verwendet.
Empfehlung: echtes Datum als Watermark-Spalte
Geeignet sind timestamp, timestamptz und date — der Wert wird dann als
ISO-Zeitstempel weitergereicht. Eine Spalte anderen Typs, etwa bigint oder xid, führt
nicht mehr zu einem Abbruch, wird aber unverändert über ToString() weitergegeben.
Datentypen — gelesene Werte
Da Schreiben nicht unterstützt wird, ist allein der Lesepfad relevant. Der Typ ergibt sich
aus dem ADO.NET-Spaltentyp; der so ermittelte Typname wird zusammen mit dem formatierten
Wert an den Zielkonnektor weitergereicht und dort für die Auswahl der Umwandlung
verwendet.
ADO.NET-Spaltentyp
Weitergegebener Typ
Formatierung des Wertes
Int32
int32
Wird als Ganzzahl gelesen und in der Kultur aus language ausgegeben
Decimal
decimal
Wird als Dezimalzahl gelesen und in der Kultur aus language ausgegeben
Double
double
Wie Decimal — Umwandlung über einen Dezimalwert
DateTime
datetime
Format u, also yyyy-MM-dd HH:mm:ssZ
alle übrigen
Name des .NET-Typs (z. B. string, boolean, guid)
Unveränderte Textdarstellung
Zahlen werden in der Kultur der Quellverbindung formatiert. Steht dort der Vorgabewert
de-DE, wird ein Komma als Dezimaltrennzeichen ausgegeben — für Zielumwandlungen, die
einen Textwert zwingend als en-US lesen, ist language entsprechend anzupassen.
Welche Quelltypen ein Zielsystem akzeptiert, steht auf der jeweiligen Zielkonnektor-Seite:
D365BC, D365CE, D365NAV.
4.8 - OpenAPI — generischer REST-Konnektor
Generischer REST-Konnektor, der Endpunkte, Wrapper-Schlüssel und Datentypen direkt aus einer OpenAPI-Spezifikation ableitet.
Der OpenAPI-Konnektor verbindet die DataBridge mit einer beliebigen REST-API, für die
eine OpenAPI-Spezifikation (JSON oder YAML) existiert. Anders als bei den übrigen HTTP-
Konnektoren werden Pfade, Wrapper-Schlüssel ({"clients": [...]} vs. {"client": {...}})
und Feldtypen nicht pro Ressource fest verdrahtet, sondern zur Laufzeit aus der
Spezifikation aufgelöst. Ein Mapping muss dafür lediglich SourceTable/TargetTable auf
den Ressourcennamen setzen (z. B. clients).
Eigenschaft
Wert
Lesen
✅ unterstützt
Schreiben (Create/Update)
✅ unterstützt
Löschen
✅ unterstützt
Aktionsaufrufe (InvokeAction)
✅ unterstützt
Job-Filter
⚠️ wird als Query-String an die Liste-Anfrage angehängt (kein $filter-Standard, API-abhängig)
Status
In Entwicklung / Preview
Status: in Entwicklung
Der Konnektor befindet sich noch in aktiver Entwicklung. Die OpenAPI-Spezifikation wird über den
in openApiSpecUrl konfigurierten Endpunkt geladen. Bekannte Einschränkungen:
Der Diagnose-Endpunkt CheckList meldet für OpenAPI-Mappings fälschlich „could not find table“.
Er vergleicht die Tabellennamen mit den Pfaden der Spezifikation (/v1/customers) statt mit
den Ressourcennamen (customers). Auf das Lesen und Schreiben hat das keinen Einfluss.
get_connector_table_schema weist keinen Primärschlüssel aus. Intern erkennt der Konnektor
den Schlüssel am Namen der Property (id, Id, ID, uuid, key).
Basis-URL der API (ohne abschließenden Schrägstrich; wird bei Bedarf entfernt)
openApiSpecUrl
✅
—
URL zur OpenAPI-Spezifikation (JSON oder YAML)
authenticateSpecRequest
—
false
true = die Spezifikation wird mit denselben Zugangsdaten wie die API abgerufen; false = ohne Authentifizierung
customHeaders
—
(leer)
Zusätzliche statische Header, die bei jeder Anfrage mitgeschickt werden (z. B. Mandanten- oder Staging-Header)
nextLinkPath
—
(leer)
JSON-Pfad zur nächsten Seiten-URL in paginierten Antworten (z. B. @odata.nextLink). Gesetzt ⇒ URL-basierte Paginierung.
nextPagePath
—
(leer)
JSON-Pfad zur nächsten Seitennummer (z. B. meta.next_page). Erfordert zusätzlich pageQueryParam.
pageQueryParam
—
(leer)
Query-Parameter für die Seitennummer (z. B. page), zusammen mit nextPagePath
pageSizeQueryParam
—
(leer)
Query-Parameter für die Seitengröße (z. B. per_page); wenn gesetzt, wird maxPageSize darüber mitgeschickt
updateMethod
—
PATCH
HTTP-Methode für Aktualisierungen. PUT für APIs, die volle Ersetzung statt Teilaktualisierung erwarten.
Zusätzlich stehen die universellen Parameter maxPageSize, language,
httpClientTimeoutSeconds, keyVaultUrl, logCreateRequests, logUpdateRequests und
logReceivedData zur Verfügung — siehe Verbindungen.
Weder nextLinkPath noch nextPagePath gesetzt
Ohne eines der beiden Paginierungs-Felder liest der Konnektor nur die erste Seite der
Liste-Antwort — es findet keine automatische Fortsetzung statt.
Authentifizierung
Der OpenAPI-Konnektor nutzt dieselbe Auswahllogik wie die übrigen HTTP-Konnektoren, erweitert
um API-Key-Authentifizierung:
Bei den übrigen HTTP-Konnektoren (D365BC, D365CE, D365NAV) ist der OAuth2-Token-Endpunkt fest
auf den Microsoft-Login-Endpunkt eingestellt. Der OpenAPI-Konnektor führt zusätzlich den
Parameter tokenUrl ein: Ist er gesetzt, wird der Token dort statt beim
Microsoft-Standardendpunkt angefragt. Damit lassen sich auch APIs anbinden, deren
OAuth2-Provider nicht Microsoft Entra ID ist. Bleibt tokenUrl leer, greift weiterhin der
Microsoft-Standardendpunkt.
Zusätzliche statische Header (z. B. mandantenspezifische Tokens, die parallel zu OAuth2 oder
API-Key benötigt werden) lassen sich unabhängig von der Authentifizierungsmethode über
customHeaders mitgeben.
Tabellen- und Feldnamen
SourceTable / TargetTable: kurzer Ressourcenname, wie er in der OpenAPI-Spezifikation
als letztes Pfadsegment vorkommt (z. B. clients für /v2/clients). Der Konnektor sucht
in der Spezifikation nach einem Pfad, der auf /<Ressourcenname> endet und keine
Parameter enthält; ein zugehöriger Einzeldatensatz-Pfad (/v2/clients/{id}) wird
automatisch mitaufgelöst.
Alternativ kann auch der vollständige Pfad aus der Spezifikation eingetragen werden
(Rückwärtskompatibilität).
SourceField / TargetField: Feldname aus dem JSON-Schema der Ressource. Verschachtelte
Felder werden mit Punktnotation adressiert (z. B. phone.country_code).
Liste- und Einzeldatensatz-Antworten müssen nicht manuell konfiguriert werden: Wrapper-
Schlüssel wie {"clients": [...]} oder {"client": {...}} werden aus der Spezifikation
erkannt. Fehlen entsprechende Hinweise in der Spezifikation, erkennt der Konnektor ersatzweise
die gebräuchlichen Muster value, data und results als Array-Wrapper.
Unterstützte TargetKey-Typen
Typ
Beschreibung
PrimaryKey / Id
Schlüsselwert wird direkt aus dem TargetKey.KeyName-Attribut der Nachricht gelesen und unverändert in die Item-URL eingesetzt
CustomKey
Ein oder mehrere Feld-Wert-Paare werden als Query-String (key=wert&key2=wert2) an die Liste-Anfrage angehängt; der Datensatz wird darüber gesucht
Filter
Wie CustomKey, zusätzlich wird id als besonderer keyName-Wert erkannt und dafür message.Id verwendet. Für Update und Löschen wird der Schlüssel des gefundenen Datensatzes verwendet: KeyAttributeFromExisting, sonst der Primärschlüssel der Spezifikation
Wird bei CustomKey/Filtermehr als ein Datensatz gefunden, bricht die Verarbeitung mit
einem Fehler ab (Found more than 1 record).
Schreiben (Upsert)
Der Konnektor prüft vor jedem Schreibvorgang, ob bereits ein Zieldatensatz existiert
(GetSingleRequest bei PrimaryKey/Id/CustomKey, ein gefilterter Liste-Abruf bei
Filter). Existiert er, wird nur bei tatsächlicher Werteänderung ein Update ausgelöst —
identische Werte führen zu keiner Anfrage.
Anlegen:POST auf den Collection-Pfad
Aktualisieren:PATCH (Vorgabe) oder PUT (updateMethod) auf den Item-Pfad
Anfrage-Body wird bei Bedarf automatisch in einen aus der Spezifikation abgeleiteten
Wrapper-Schlüssel eingebettet (z. B. {"client": {...}}). Ein Job kann das über
SpecialSettings gezielt abschalten:
{ "DoNotWrapRequestBody": true }
Ein 409 Conflict bei Anlegen oder Aktualisieren wird als transiente Ausnahme
behandelt und über die Transitive-Queue erneut verarbeitet (siehe
Architektur → Retry- und Fehlerverhalten).
Löschen
Anders als die SQL-Konnektoren unterstützt der OpenAPI-Konnektor Löschungen: Der
Schlüssel wird wie beim Lookup aufgelöst, anschließend folgt ein DELETE auf den
Item-Pfad. Bei TargetKey vom Typ Filter wird der Datensatz zuerst gesucht. Wird keiner
gefunden, schreibt der Konnektor eine Warnung ins Log und sendet kein DELETE.
InvokeAction — generische Aktionsaufrufe
Neben dem klassischen CRUD-Zyklus unterstützt die DataBridge seit dieser Version
Aktions-Jobs: Ein Job mit Action = InvokeAction (technisch: jeder Wert, der nicht auf
einen bekannten JobActionType passt) ruft einen benannten, nicht-CRUD-Endpunkt auf, statt
einen Datensatz anzulegen oder zu ändern — z. B.
POST /v2/client_invoices/{id}/send_by_einvoice.
Konfiguration:
Feld
Bedeutung
Job.Action
Name der Aktion (z. B. der OpenAPI-operationId oder ein sprechender Bezeichner) — beliebig, solange er nicht NewUpdate, Delete, TimeStamp oder DeleteOnUpdate entspricht
TableMapping.TargetPath + TargetTable
Ergeben zusammen den Aktionspfad, so wie er in der Spezifikation steht (z. B. TargetPath = "v2/client_invoices/{id}", TargetTable = "send_by_einvoice")
FieldMapping mit gesetztem TargetField
Optional; ergibt den JSON-Request-Body der Aktion
Ablauf:
Der Aktionspfad wird in der Spezifikation nachgeschlagen; die HTTP-Methode wird daraus
übernommen (bevorzugt POST, sonst PUT/PATCH/DELETE — die erste im Pfad
gefundene, nicht-GET-Methode).
Pfadparameter ({id} etc.) werden aus message.Id (Parametername id) bzw. aus
message.Attributes aufgelöst; ein nicht auflösbarer Parameter erzeugt lediglich eine
Warnung und bleibt im Pfad stehen.
Ist mindestens ein Zielfeld gemappt, wird daraus ein JSON-Body gebaut und mitgeschickt.
Bei einem ResponseJob wird die Antwort — über den aus der Spezifikation abgeleiteten
Wrapper-Schlüssel entpackt — als neue Queue-Nachricht mit ActionCode = NewUpdate
weitergereicht.
Ein fehlender Aktionspfad oder eine Antwort ohne 2xx-Statuscode brechen den Job mit einer
Ausnahme ab.
Job-eigene Source-/Target-Pfade (statt nur Mapping-Tabelle)
(neu, alle Konnektoren betroffen — beim OpenAPI-Konnektor besonders relevant)
Ein Job kann eigene Felder Source und Target tragen, die den SourceTable/TargetTable
der referenzierten Mapping-Zeilen überschreiben. Damit lässt sich ein und dasselbe
Mapping für mehrere Ressourcen bzw. Aktionspfade wiederverwenden. Details:
Jobs → Source und Target.
Änderungserkennung (Watermark)
Eigenschaft
Wert
Empfohlener WatermarkType
datetime
WatermarkField
Beliebiger JSON-Pfad im Antwortobjekt (z. B. updated_at), der bei jedem gelesenen Datensatz zu einem gültigen Zeitstempel ausgewertet werden kann
Der Watermark-Wert wird über job.WatermarkField als SelectToken-Pfad auf jedes gelesene
JSON-Objekt angewendet. Der Filterausdruck (Job.Filter) wird — anders als bei D365BC/NAV —
nicht in eine standardisierte Query-Syntax übersetzt, sondern unverändert als Query-String
an die Liste-Anfrage angehängt; Aufbau und Platzhalter sind daher von der jeweiligen API
abhängig.
EmbedChildren — eingebettete Kind-Datensätze
(Quell-Feature ist derzeit nur im D365CE-Connector implementiert, das Zielverhalten dazu
liegt im OpenAPI-Konnektor)
Verweist ein Feld-Mapping über die SourceOperation EmbedChildren auf einen anderen Job,
werden dessen Zeilen bereits beim Lesen in die Nachricht des Elterndatensatzes eingebettet.
Beim Schreiben in eine OpenAPI-Zielressource baut der Konnektor daraus ein verschachteltes
JSON-Array (z. B. Rechnungspositionen unter lines) und schreibt es als Teil der
Elternanfrage — ohne Feld-für-Feld-Abgleich mit einem eventuell vorhandenen Array im
Zieldatensatz. Details zur Quellseite: Architektur und
D365CE.
Caching
OpenAPI-Dokument und aufgelöste Ressourcen-Metadaten (Pfade, Wrapper-Schlüssel, Schema) werden
pro Prozess zwischengespeichert. Ein Neuladen der Spezifikation erfordert einen Neustart der
Function App bzw. ein erneutes Kaltstart-Init.
5 - MCP-Server
Die DataBridge unterstützt das Model Context Protocol: ein eingebauter, read-only Server für Jobs, Mappings, Service-Bus-Queues und echte Connector-Schemas für KI-Assistenten wie Claude Code, GitHub Copilot oder Microsoft 365 Copilot.
Die dsyr.DataBridge unterstützt das Model Context Protocol (MCP)
— den offenen Standard, über den KI-Assistenten strukturiert auf externe Systeme zugreifen. Ein
eingebauter, read-only MCP-Server macht dieselben Daten, die auch über die HTTP-APIs
(GetJobByRowKey, GetMappingByRowKey) verfügbar sind, sowie die Service-Bus-Queue-Diagnose
zusätzlich als MCP-Tools ansprechbar — sodass ein KI-Assistent (Claude Code, GitHub Copilot,
Microsoft 365 Copilot, …) direkt gegen eine laufende DataBridge-Instanz Fragen stellen kann, statt
Tabellen manuell in Azure Storage Explorer oder per REST-Aufruf durchzusehen.
Read-only
Kein Tool verändert, löscht oder sendet irgendetwas. Der Server eignet sich zum Nachschlagen,
Validieren und Debuggen — nicht zum Auslösen von Jobs oder Schreiben in Zielsysteme. Was genau
jedes einzelne Tool lesen darf (und was bewusst nicht zurückgegeben wird, z. B. Nachrichten-
inhalte oder Connection-Credentials), steht auf der Unterseite Operationen.
Auf dieser Seite
Funktionsweise — Endpunkt, Transport, Authentifizierung und wie die Function
intern aufgebaut ist.
Operationen — die zehn verfügbaren Tools im Detail: was jedes einzelne liest,
und was es nicht liest.
Nutzung — Einrichtung mit Claude Code, GitHub Copilot (VS Code) und Microsoft 365
Copilot.
Kurzüberblick
Function
Mcp (DataBridge/Functions/McpApi.cs)
Route
POST /api/mcp (JSON-RPC-Austausch über Streamable HTTP)
Auth-Level
Function (Function Key als ?code=-Query-Parameter)
Tools
10 — Jobs & Mappings, Service-Bus-Diagnose, Connector-Schema (siehe Operationen)
Schreibzugriff
Keiner — alle Tools sind read-only, siehe Operationen
Der Server ist damit direkt an einer laufenden Function App (lokal oder in Azure) ansprechbar,
ohne eigenen Prozess oder zusätzliche Infrastruktur.
5.1 - Funktionsweise
Wie der MCP-Server technisch aufgebaut ist: Endpunkt, Transport, Authentifizierung, interner Aufbau und eine bekannte Einschränkung.
Endpunkt
Function
Mcp (DataBridge/Functions/McpApi.cs)
Route
POST /api/mcp (JSON-RPC-Austausch); GET /api/mcp liefert bewusst 405 — siehe Bekannte Einschränkung
Auth-Level
Function (Function Key als ?code=-Query-Parameter)
Protokoll
MCP über Streamable HTTP, stateless — jede POST-Anfrage ist ein eigenständiger JSON-RPC-Austausch, es gibt keine langlebige Server-Session
Der Server ist damit direkt an einer laufenden Function App (lokal oder in Azure) ansprechbar,
ohne eigenen Prozess oder zusätzliche Infrastruktur. Da die Authentifizierung über den normalen
Azure-Functions-Mechanismus läuft (Function Key), lässt sich der Server ohne zusätzliche
Identity-Provider-Konfiguration einrichten — der Key kann als Query-Parameter oder als Header
übergeben werden, je nachdem, was der jeweilige Client unterstützt (siehe Nutzung).
Interner Aufbau
Der Mcp-Function-Trigger baut pro HTTP-Anfrage einen eigenen
StreamableHttpServerTransport auf und
delegiert die eigentliche Tool-Logik an den IMcpToolService (DataBridge.Core/Services/Mcp/),
der wiederum dieselben Service-Interfaces (IJobService, IMappingService,
IServiceBusService, IConnectionService) aufruft wie die klassischen HTTP-Funktionen — es gibt
keine internen Selbstaufrufe zwischen den Functions. McpApi.cs bleibt dadurch auf die reine
Protokoll-Anbindung beschränkt (Tool-Registrierung, Transport), analog zum dünnen Zuschnitt von
JobApi/MappingApi. Die eigentliche Tool-Logik (Init-Guard, Job-/Mapping-Lesezugriff,
Service-Bus-Delegation, Connector-Auflösung) liegt in IMcpToolService, testbar unabhängig vom
Protokoll-Layer. Details zur Service-Schicht: Architektur.
Die [Description]-Attribute und Standardwerte für die Tool-Parameter liegen bewusst auf den
Methoden von IMcpToolService selbst (reines System.ComponentModel) — McpApi.cs bindet die
Tools direkt auf diese Service-Methoden, ohne zusätzliche Wrapper-Methoden. Der Transport-Teil
(ModelContextProtocol.AspNetCore) bleibt im Host; DataBridge.Core referenziert nur
ModelContextProtocol.Core, und das ausschließlich für die McpException (siehe unten).
Fehlerweitergabe an den Client
Der MCP-C#-SDK ersetzt jede unbehandelte Exception eines Tools durch den generischen Text
„An error occurred invoking ‘…’.“ und hängt nur bei einer McpException deren Message an.
Alle anderen Exceptions landen zwar im Log, der Client sieht aber nicht, warum der Aufruf
fehlgeschlagen ist. Ein CallToolFilter hilft hier nicht, weil der Catch im SDK innerhalb des
Tool-Aufrufs sitzt. McpToolService wirft deshalb bei den beiden Connector-Tools
(list_connector_tables, get_connector_table_schema) Connector-Fehler und unbekannte
Connection-Namen als McpException weiter (SurfaceConnectorErrors), sodass z. B. die
angefragte $metadata-URL und der HTTP-Status beim Client ankommen. Der Test
McpApiTests.ToolsCall_ListConnectorTables_ConnectorFails_ErrorResultCarriesTheCause sichert
dieses Verhalten durch die echte SDK-Pipeline ab.
Bekannte Einschränkung: GET auf /api/mcp
Manche MCP-Clients (typischerweise Remote-Clients, die den Endpunkt über eine echte
Azure-Deployment-URL statt lokal ansprechen) versuchen nach dem initialize-POST zusätzlich
einen GET auf denselben Endpunkt, um einen optionalen Server-zu-Client-SSE-Stream zu öffnen
(Teil der Streamable-HTTP-Spezifikation).
Da dieser Server stateless ist (keine Session, kein Server-Push), unterstützt er diesen
Stream bewusst nicht. Die Route ist deshalb zusätzlich zum POST-Handler mit einem eigenen
GET-Handler registriert, der spezifikationskonform mit 405 Method Not Allowed (statt einem
nicht aussagekräftigen, von Azure Functions automatisch erzeugten 404) antwortet:
Manche Clients interpretieren 405 als „kein SSE-Support, aber Server ist erreichbar" und
fallen automatisch auf reines POST zurück; ein 404 liest sich dagegen wie „Endpunkt existiert
nicht" und lässt die Verbindung fehlschlagen. Ohne diesen Handler tritt das Problem nur bei
Remote-/Azure-Deployments zuverlässig auf — lokal (Claude Code über .mcp.json) sendet der
Client i. d. R. keinen GET-Probe-Request, daher blieb es dort unbemerkt.
5.2 - Operationen
Die zehn MCP-Tools im Detail: was jedes einzelne liest — und was bewusst nicht zurückgegeben wird.
Alle zehn Tools sind als ReadOnly = true, Idempotent = true und Destructive = false markiert
(MCP-Tool-Annotationen, die dem aufrufenden Client mitgeben, dass wiederholte Aufrufe risikolos
sind). Kein Tool schreibt, löscht oder sendet — weder in der jobs-/mappings-Tabelle, noch in
den Service-Bus-Queues, noch in einem Quell-/Zielsystem.
Grenze ist Metadaten vs. Nutzdaten, nicht nur lesend vs. schreibend
Auch innerhalb der reinen Lesezugriffe gibt es eine bewusste zweite Grenze: Betriebs-/
Konfigurationsdaten (Job-Namen, Schemata, Fehlermeldungen, Zeitstempel) sind unkritisch und werden
vollständig zurückgegeben. Fachliche Nutz-/Kundendaten — z. B. der Inhalt einer
Service-Bus-Nachricht — werden dagegen nie zurückgegeben, selbst wenn das zugrunde liegende
Tool ansonsten “nur liest”. Details dazu unten bei den Peek-Tools.
Jobs & Mappings (Table Storage)
Lesen ausschließlich aus den beiden Tabellen jobs/mappings, über dieselben In-Memory-Caches
wie JobApi/MappingApi (IJobService.Jobs/IMappingService.Mappings — reine Query<T>()-Reads,
kein Upsert/Delete im Codepfad).
Tool
Liest
Liest nicht
list_jobs
Alle konfigurierten Jobs: Quelle/Ziel-Connection, Richtung, Priorität, Zeitplan, Mapping-Name, aus der jobs-Tabelle
Keine Connection-Credentials (nur der Name der Connection, nicht ihre Zugangsdaten)
get_job
Ein einzelner Job anhand seines RowKey (Job-Name) — dieselben Felder wie list_jobs
dito
list_mappings
Alle Feld-Mappings zwischen Quell- und Zielsystemen aus der mappings-Tabelle
Keine tatsächlichen Datensatz-Inhalte — nur die Mapping-Konfiguration (welches Feld auf welches Feld abgebildet wird), nicht produzierte/synchronisierte Daten
get_mapping
Ein einzelnes Mapping anhand seines Namens (der Mapping-Name, auf den ein Job verweist und unter dem list_mappings es auflistet)
dito
Warum keine Credentials möglich sind:IConnectionService.GetConnector(name) liefert nur die
IConnector-Instanz zurück, nicht das zugrunde liegende ConnectionSetting-Objekt. Felder wie
ClientSecret, Password oder ApiKeyValue sind private Felder in den konkreten Connectoren und
nicht Teil des IConnector-Interfaces — es gibt schlicht keinen Rückgabewert, über den sie
herauskommen könnten.
Service Bus (Diagnose)
Reine Peek-/Status-Operationen über IServiceBusService. Die beiden Peek-Tools erzeugen den
Empfänger ohne PeekLock und rufen ausschließlich receiver.PeekMessagesAsync(...) auf — es gibt
im Codepfad kein ReceiveMessagesAsync, CompleteMessageAsync, DeadLetterMessageAsync oder
AbandonMessageAsync. Auch SendMessageAsync (existiert auf IServiceBusService für
GetChanges) ist von keinem MCP-Tool aus erreichbar.
Tool
Liest
Liest nicht
list_queue_statuses
Laufzeit-Status (aktive/dead-letter/geplante Nachrichtenanzahl) aller Export-Queues
Keine einzelnen Nachrichten — nur Zähler
get_queue_status
Laufzeit-Status einer einzelnen Queue für eine Job-Priorität
dito
peek_queue_messages
Sequenznummer, JobName, SourceKey, Enqueue-Zeitpunkt, Zustellversuche und BodySize (Größe des Nachrichteninhalts in Bytes) je Nachricht
Den Nachrichteninhalt selbst (Body) nicht — siehe Kasten unten
peek_dead_letter_queue_messages
Zusätzlich zu den obigen Feldern: DeadLetterReason, DeadLetterErrorDescription, ErrorMessage, ErrorTimeStamp, ErrorStackTrace, OperationId
dito — auch hier nur BodySize, nie Body
Warum kein Nachrichteninhalt
Der Body einer Queue-Nachricht enthält die fachlichen Nutzdaten des jeweiligen Jobs — z. B.
bei einem BC-Artikelstamm-Job Produktcode, Bezeichnung und Dimensionswerte, bei anderen Jobs unter
Umständen Kundennamen, Adressen oder Preise. Das ist etwas grundlegend anderes als Betriebsmetadaten
wie ein Fehlertext oder ein Zeitstempel. Beide Peek-Tools geben deshalb bewusst nie den
Nachrichteninhalt zurück — nur dessen Größe in Bytes (BodySize), berechnet über
message.Body.ToMemory().Length, ohne den Inhalt jemals zu deserialisieren oder als String zu
lesen. Für die Fehleranalyse reichen die übrigen Felder (insbesondere bei
peek_dead_letter_queue_messages die Fehlerdetails) in aller Regel aus.
Tabellen-/Entitätsnamen einer Connection direkt aus den Metadaten des Zielsystems — zum Abgleich mit den in Jobs/Mappings konfigurierten Namen
Keine tatsächlichen Datensätze aus der Tabelle — nur ihren Namen
get_connector_table_schema
Spalten-Metadaten (Typ, Nullable, maximale Länge, bei SQL-Dezimalspalten Precision/Scale, Primary Key) einer Tabelle/Entität — zum Validieren eines Mappings gegen das tatsächliche Schema, statt sich auf die Mapping-Konfiguration allein zu verlassen
Keine tatsächlichen Datensätze/Zeilenwerte — nur die Spalten-Struktur
Beide Tools nehmen einen connectionName entgegen (den RowKey aus der connections-Tabelle —
siehe Verbindungen, z. B. BC_Test oder CRM_Test) sowie
einen tableName/Ressourcennamen. Für BC/NAV gibt es zusätzlich den apiPath (derselbe Wert wie
TableMapping.SourcePath/TargetPath im Mapping), da beide Connectoren ihr Schema über einen
versionierten OData-$metadata-Endpunkt beziehen. Bei BC ist er optional: leer bedeutet v2.0
(die Standard-API); Custom-APIs (z. B. publisher/gruppe/v1.0) brauchen ihren Pfad weiterhin.
Bei den SQL-Connectoren hat apiPath eine andere Bedeutung, siehe unten.
Diese beiden Tools sind die einzigen mit OpenWorld = true — sie greifen tatsächlich auf das
externe Quell-/Zielsystem der jeweiligen Connection zu, nicht nur auf die eigene
DataBridge-Infrastruktur. Ungültige Connection-Namen liefern eine klare Meldung
(„Connection ‘…’ is not configured or not initialized") statt einer rohen
KeyNotFoundException — es lässt sich also nicht durch Ausprobieren beliebiger Namen etwas über
das System herausfinden, das über list_jobs/get_job nicht sowieso schon sichtbar wäre.
Schlägt der Zugriff auf das Zielsystem fehl (falscher apiPath, unbekannte Tabelle, Host nicht
erreichbar), enthält das Fehlerergebnis die Ursache, z. B. GET …/api/nope/v1.0/$metadata returned 404 Not Found — technisch als McpException, weil der MCP-SDK nur deren Message an den Client
durchreicht (siehe Funktionsweise).
Connector-Unterstützung
list_connector_tables/get_connector_table_schema funktionieren für alle Connectoren:
D365BC, D365NAV, D365CE (Dataverse), OpenAPI sowie die SQL-Connectoren MSSQL, MySQL,
Oracle und PostgreSQL. Der Rückgabewert ist je Connector unterschiedlich vollständig, da
nicht jedes System dieselbe Metadaten-Tiefe bietet:
Connector
Typ
Nullable
Max. Länge
Precision/Scale
Primary Key
D365BC / D365NAV
✅
✅
✅ (nur Strings)
❌
✅
D365CE (Dataverse)
✅
✅
✅ (nur Strings)
❌
✅
OpenAPI
✅
✅
✅ (falls maxLength im Schema)
❌
❌ (kein natives Konzept — immer null)
MSSQL / MySQL / PostgreSQL
✅
✅
✅ (nur Strings)
✅ (nur Dezimalspalten)
✅
Oracle
✅
✅
✅ (in Zeichen, CHAR_LENGTH)
✅ (nur Dezimalspalten)
✅
SQL-Connectoren: Schema über apiPath
Bei den SQL-Connectoren gibt apiPath das Schema an, in dem die Tabelle liegt — bei
MySQL die Datenbank. Ohne apiPath wird das Standard-Schema der Verbindung verwendet
(MSSQL SCHEMA_NAME(), MySQL DATABASE(), PostgreSQL current_schema(), Oracle der
angemeldete Benutzer). Damit werden gleichnamige Tabellen in unterschiedlichen Schemas
(z. B. dbo.Customers und archive.Customers) nicht vermischt.
Connector
Metadatenquelle
apiPath
MSSQL
INFORMATION_SCHEMA
Schema, z. B. dbo
PostgreSQL
INFORMATION_SCHEMA
Schema, z. B. public
MySQL
INFORMATION_SCHEMA
Datenbank
Oracle
USER_TAB_COLUMNS/USER_CONSTRAINTS, mit apiPathALL_*-Views
Owner/Schema, z. B. HR
Tabellen- und Schemaname werden groß-/kleinschreibungsunabhängig verglichen und als
Parameter an die Datenbank übergeben. Die Metadaten werden je Connector-Instanz
zwischengespeichert — Schemaänderungen an der Datenbank werden erst nach einem Neustart der
Function App sichtbar.
SQL-Connectoren: Datentypen
Die Datentypen aus dem Datenbank-Katalog werden auf .NET-Typen abgebildet. Dabei werden
Precision und Scale sowie bei MySQL der vollständige Spaltentyp (COLUMN_TYPE) berücksichtigt.
Unbekannte Typen (z. B. json, xml, Array-Typen) erscheinen als String.
.NET-Typ
MSSQL
PostgreSQL
MySQL
Oracle
Guid
uniqueidentifier
uuid
—
—
Boolean
bit
boolean
tinyint(1)/boolean, bit(1)
boolean (23ai)
Byte
tinyint
—
tinyint unsigned
—
Int16
smallint
smallint
tinyint, smallint, year
number(1–4,0)
Int32
int
integer
int, mediumint, smallint unsigned
number(5–9,0)
Int64
bigint
bigint
bigint, int unsigned, bit(n>1)
number(10–18,0)
Decimal
decimal, numeric, money
numeric
decimal, bigint unsigned
number mit Nachkommastellen, ab 19 Stellen oder ohne Angabe
Single
real, float(1–24)
real
float
binary_float
Double
float
double precision
double
binary_double, float
DateOnly
date
date
date
—
DateTime
datetime, datetime2, smalldatetime
timestamp
datetime, timestamp
date, timestamp, timestamp with local time zone
DateTimeOffset
datetimeoffset
timestamp with time zone
—
timestamp with time zone
TimeSpan
time
time, interval
time
interval
Byte[]
binary, varbinary, image, timestamp/rowversion
bytea
binary, varbinary, blob-Typen
blob, raw
String
Zeichentypen, xml
Zeichentypen, json/jsonb
Zeichentypen, json
Zeichentypen, clob, json
Besonderheiten:
MSSQLtimestamp ist der alte Name von rowversion, eine binäre Zeilenversion und kein
Datum — daher Byte[].
MySQL speichert BOOLEAN als tinyint(1); erst der vollständige Spaltentyp macht daraus
Boolean. Vorzeichenlose Ganzzahlen erhalten den nächstgrößeren Typ, damit der Wertebereich
passt. timestamp hat keinen Offset und wird daher DateTime.
Oracle kennt keine eigenen Ganzzahltypen; NUMBER(p,0) wird nach der Anzahl der Stellen
auf Int16/Int32/Int64 abgebildet. DATE enthält immer eine Uhrzeit und wird daher
DateTime, nicht DateOnly.
GUIDs, die als Text gespeichert sind (MySQL char(36), Oracle varchar2(36)), erscheinen als
String.
Zusammenfassung: was über MCP grundsätzlich nicht möglich ist
Keine Schreib-, Lösch- oder Sende-Operation auf jobs/mappings/Service-Bus-Queues oder einem
Ziel-/Quellsystem — es gibt für keines der zehn Tools einen Codepfad zu Upsert, Delete,
SendMessageAsync, CompleteMessageAsync o. Ä.
Keine Connection-Credentials (Passwörter, Client-Secrets, API-Keys) — die sind strukturell nie
Teil eines Rückgabewerts.
Kein tatsächlicher Nachrichteninhalt aus einer Service-Bus-Queue — nur dessen Byte-Größe.
Keine tatsächlichen Datensatz-Werte aus einem Ziel-/Quellsystem über die Connector-Tools — nur
Tabellennamen und Spalten-Struktur, keine Zeilen.
5.3 - Nutzung
Den MCP-Server mit Claude Code, GitHub Copilot (VS Code) oder Microsoft 365 Copilot verbinden.
Der Server spricht Standard-MCP über Streamable HTTP — grundsätzlich verbindet sich jeder
MCP-fähige Client über dieselbe URL (.../api/mcp?code=<Function-Key>). Die folgenden Abschnitte
zeigen die konkrete Einrichtung für die gängigsten Clients.
Claude Code
Dieses Repository bringt bereits eine passende .mcp.json
mit:
Lokal (Core Tools / Debugger): Der lokale Function-Host prüft den Auth-Level Function nicht
— der Platzhalterwert local in der URL reicht aus. Voraussetzung ist nur, dass die Function App
tatsächlich auf Port 7062 läuft (nicht der func-Standard 7071!):
Visual Studio / dotnet run: Startprofil DataBridge aus src/DataBridge/Properties/launchSettings.json
(setzt bereits --port 7062).
VS Code: Task func: host start aus .vscode/tasks.json (ebenfalls fest auf --port 7062).
Rider: die in der IDE angezeigte „Azure Functions Project"-Run-Configuration DataBridge —
im Feld „Function host arguments" muss host start --pause-on-error --port 7062 stehen.
Danach lädt Claude Code den databridge-Server automatisch; die Tools erscheinen mit dem Präfix
mcp__databridge__....
Gegen eine Azure-Deployment-Instanz: Die URL enthält zwei Umgebungsvariablen, die ohne
eigene Werte auf den lokalen Host zeigen. Für ein Deployment setzt man sie in der nicht
eingecheckten .claude/settings.local.json des Repositorys:
Den Function Key gibt es im Azure Portal → Function App → Funktionen → Mcp →
Funktionsschlüssel. Niemals einen echten Key in .mcp.json committen. Geänderte Werte greifen
erst beim Start einer neuen Claude-Code-Session.
Eine eigene Datei wie .mcp.local.json wertet Claude Code nicht aus. Wer zusätzlich einen
persönlichen Server-Eintrag braucht (etwa für eine zweite Instanz), legt ihn über
claude mcp add --scope local --transport http <name> "<url>" an.
Beispiel-Interaktion
Ein typischer Anwendungsfall: prüfen, ob ein Mapping-Feld wirklich im Zielsystem existiert.
Prompt: „Prüfe, ob das Mapping BCAccounts gültige Zielfelder hat — vergleiche mit den
echten Metadaten der Connection."
Claude ruft dafür typischerweise nacheinander auf:
get_mapping mit rowKey: "BCAccounts" → liefert die konfigurierten Feld-Mappings inkl.
TargetTable/TargetPath.
get_connector_table_schema mit der targetConnection aus dem zugehörigen Job sowie
tableName/apiPath aus dem Mapping → liefert das tatsächliche Schema.
Vergleicht beide Ergebnisse und meldet fehlende Felder oder Typ-Abweichungen.
Damit lassen sich Mapping-Fehler bereits vor dem ersten produktiven Lauf eines Jobs erkennen,
statt sie erst über eine fehlgeschlagene Dead-Letter-Nachricht zu bemerken (siehe
peek_dead_letter_queue_messages, Operationen).
GitHub Copilot (VS Code)
VS Code (ab Version 1.99, Agent-/Chat-Modus) unterstützt MCP-Server nativ über eine mcp.json —
entweder projektweit unter .vscode/mcp.json oder als Nutzer-Konfiguration über die
Command Palette (MCP: Open User Configuration). Anders als Claude Codes .mcp.json liegt der
Server hier unter dem Schlüssel servers, nicht mcpServers:
Der inputs-Block sorgt dafür, dass VS Code beim ersten Verbindungsversuch einmalig nach dem
Function Key fragt (maskierte Eingabe) statt ihn im Klartext in der Datei zu speichern — dieselbe
Absicht wie die ${DATABRIDGE_FUNCTION_KEY:-local}-Umgebungsvariable im Claude-Code-Beispiel oben,
nur über den VS-Code-eigenen Mechanismus. Lokal (Function-Host ohne Auth-Prüfung) reicht auch hier
ein beliebiger Platzhalterwert. Details zu Input-Variablen:
VS Code MCP-Konfigurationsreferenz.
Nach dem Speichern zeigt VS Code den Server im Chat-/Agent-Modus an; die Tools lassen sich dort
wie jedes andere MCP-Tool auswählen und aufrufen.
Microsoft 365 Copilot
Microsoft 365 Copilot bindet externe MCP-Server nicht direkt per URL im Chat ein, sondern über
Copilot Studio — dort lässt sich ein bestehender MCP-Server einem Agenten als Tool hinzufügen,
und dieser Agent dann in Microsoft 365 Copilot veröffentlichen. Die Einrichtung erfolgt über den
MCP-Onboarding-Wizard in Copilot Studio:
Im Agenten zur Seite Tools wechseln → Add a tool → New tool → Model Context Protocol.
Als Authentifizierungsart API key wählen (nicht OAuth 2.0 — unser Server nutzt den
Azure-Functions-eigenen Function-Key-Mechanismus, kein OAuth).
Als TypeQuery wählen und als Parametername code eintragen — das entspricht genau
dem ?code=-Query-Parameter, den auch Claude Code und VS Code verwenden.
Create, dann den Function Key als API-Key-Wert für die Verbindung hinterlegen.
Copilot Studio unterstützt für MCP ausschließlich den Streamable-HTTP-Transport (SSE ist
seit August 2025 deprecatet) — genau das Protokoll, das McpApi.cs implementiert, es sind also
keine serverseitigen Anpassungen nötig.
Stand der Unterstützung
Die Microsoft-365-Copilot-Integration für MCP-Server entwickelt sich weiter (Copilot Studio hat
die GA für MCP-Tools im Sommer 2026 erreicht); ob und wie ein Tool in einer konkreten
Microsoft-365-Oberfläche (Copilot Chat, Excel, Teams, …) angezeigt wird, hängt vom jeweiligen
Copilot-Erlebnis und der Agenten-Konfiguration ab. Vor einem produktiven Rollout die Verbindung
mit einem Testagenten in Copilot Studio verifizieren.
Alternativ lässt sich der Server auch als benutzerdefinierter Connector über eine
OpenAPI-Beschreibung in Power Apps einbinden (x-ms-agentic-protocol: mcp-streamable-1.0) — das
ist der Weg, wenn mehr Kontrolle über die Connector-Konfiguration nötig ist als der Wizard bietet.
Details dazu: Microsoft-Dokumentation zu MCP in Copilot Studio.
6 - Betrieb & Wartung
Logging, Monitoring, Alerts und Updates für den laufenden Betrieb der DataBridge.
Eine laufende DataBridge-Instanz braucht Beobachtung. Dieses Kapitel erklärt, wie man
den Betrieb nachvollzieht, Fehler diagnostiziert, Warnungen automatisiert und
die Instanz auf neue Versionen aktualisiert.
Upgrade-Pfade zwischen Versionen, Breaking Changes
6.1 - Logging & Telemetrie
Wie die DataBridge Logs erzeugt, welche Telemetrie sie sendet und wie Sampling die Kosten steuert.
Die DataBridge steuert ihr Telemetrie-Volumen über zwei voneinander unabhängige
Mechanismen:
Gepuffertes Logging — Log-Einträge werden pro Funktionsausführung gesammelt und
erst am Ende des Laufs, abhängig vom Ergebnis, selektiv gesendet.
Sampling von Abhängigkeiten — ausgehende Aufrufe an Quell- und Zielsysteme werden
nur anteilig gesendet, sofern sie erfolgreich und schnell waren.
Der zweite Mechanismus ist der eigentliche Kostenhebel: In einer Volumenanalyse über
90 Tage entfielen rund 78 % des gesamten Datenvolumens auf Abhängigkeiten und nur ein
Bruchteil auf Log-Einträge.
KQL-Abfragen für Laufzeiten, Fehler, Abhängigkeiten und Datenvolumen
Gepuffertes Logging — drei Lauf-Ergebnisse
Ergebnis
Kriterium
Gesendete Log-Level
Normaler Lauf
Keine Fehler, keine Warnungen
Nur Warning + Error + ~20 % der Information-Einträge (konfigurierbar)
Lauf mit Warnungen
Mindestens eine Warning, kein Fehler
Alle Information + Warning + Error
Fehlerlauf
Mindestens ein unbehandelter Fehler
Alle Debug + Information + Warning + Error
Der Anteil der Information-Einträge im Normalbetrieb wird über
TELEMETRY_INFO_SAMPLE_RATE gesteuert (Standard: 20 = 20 %). Die Stichprobe wird
pro Eintrag gezogen — es entstehen also vereinzelte Traces aus allen Läufen,
keine vollständigen Ketten. Lückenlose Ketten gibt es nur bei Warning- und Fehler-Läufen.
Trace-Level erreicht Application Insights nie
`LogTrace` ist ausschließlich live sichtbar
Log-Einträge auf Level Trace werden niemals an Application Insights gesendet —
auch nicht bei Fehler-Läufen. Der Telemetriepfad ist auf Debug und höher begrenzt.
Sichtbar sind sie nur live: lokal in der Konsole bzw. im Container-Log, in Azure im
Log Stream der Function App (oder per az webapp log tail).
Sampling von Abhängigkeiten
Ausgehende Aufrufe an Quell- und Zielsysteme (D365 OData, SQL, Table Storage, Service Bus)
werden von Application Insights automatisch als Dependencies erfasst. Ohne Filterung
verursachen sie bei kurzem Polling-Intervall ein Vielfaches aller Log-Einträge zusammen.
Aufruf
Wird gesendet
Fehlgeschlagen
Immer vollständig
Langsam (≥ TELEMETRY_DEPENDENCY_SLOW_MS)
Immer vollständig
Erfolgreich und schnell
Nur zum Anteil TELEMETRY_DEPENDENCY_SAMPLE_RATE (Standard 10 %)
Die Entscheidung fällt pro Aufruf
Anders als beim Logging wird hier pro Aufruf entschieden, und zwar in dem Moment,
in dem der Aufruf endet — also bevor bekannt ist, ob die Funktionsausführung insgesamt
erfolgreich war.
Praktische Folge: Ein fehlgeschlagener Lauf enthält garantiert den fehlgeschlagenen
Aufruf, aber nicht zwangsläufig die erfolgreichen Aufrufe davor. Wird der vollständige
Verlauf für eine Analyse gebraucht, ist vorübergehend TELEMETRY_CONTROL=TRACE_ALL
zu setzen.
Steuerung über TELEMETRY_CONTROL
Die Einstellung wirkt auf beide Mechanismen — Traces und Abhängigkeiten:
Eine leere Variable entspricht TRACE_SAMPLE. Details zu allen Telemetrie-Einstellungen
stehen unter Umgebungsvariablen.
`TRACE_ALL` nicht dauerhaft setzen
TRACE_ALL deaktiviert sämtliches Sampling und kann das Datenvolumen um ein Vielfaches
erhöhen — bis hin zum Erreichen der Tagesobergrenze (Daily Cap), ab der gar keine
Telemetrie mehr ankommt. Nur gezielt für die Dauer einer Analyse aktivieren.
Auswirkung auf bestehende Auswertungen
Bestehende Alerts und Dashboards prüfen
Verworfene Abhängigkeiten werden vollständig entfernt und nicht über einen
Hochrechnungsfaktor (itemCount) kompensiert.
Auswertungen über dependencies / AppDependencies, die auf absoluten Zählungen
oder Durchschnittslaufzeiten beruhen, liefern zu niedrige Werte.
Besonders kritisch sind Fehlerquoten der Form countif(success == false) / count():
Da fehlgeschlagene Aufrufe vollständig erhalten bleiben, erfolgreiche aber gesampelt
werden, ist das Ergebnis deutlich überhöht. Solche Abfragen und darauf basierende
Alerts sind zu entfernen oder auf die Tabelle requests umzustellen, die keinem
Sampling unterliegt.
Nicht betroffen sind:
Fehleranzahlen und Fehlerursachen — fehlgeschlagene Aufrufe werden nie verworfen
Auswertungen langsamer Aufrufe — ab dem Schwellwert immer vollständig
Requests, Exceptions, Traces und Custom Metrics — unverändert
Wichtige Log-Felder in Application Insights
Feld
Beschreibung
operation_Id
Korrelations-ID — verknüpft alle Einträge einer einzigen Funktionsausführung
operation_ParentId
Span-ID des Requests — sorgt für die korrekte Einordnung in der End-to-End-Transaktionsansicht
operation_Name
Name der ausgeführten Function (z. B. GetChanges, ProcessStandardQueueItems)
timestamp
Zeitpunkt des ursprünglichen Log-Aufrufs, nicht des Sendens am Ende der Ausführung
Neben den eigenen Log-Einträgen erfasst Application Insights selbstständig:
Requests — je Funktionsausführung, mit Laufzeit und Erfolgskennzeichen
Exceptions — jede aufgetretene Ausnahme mit Stack Trace
Dependencies — jeder ausgehende Aufruf (unterliegt dem Sampling, siehe oben)
Auswertung im Azure Portal
Schnelle Übersicht — Performance Blade
Application Insights → Untersuchen → Leistung
Zeigt alle Funktionsausführungen mit Durchschnittslaufzeit und P50/P95/P99-Perzentilen.
Ein hoher P95-Wert deutet auf gelegentliche Verzögerungen hin (langsames Zielsystem,
Queue-Stau).
Fehlerdiagnose — Failures Blade
Application Insights → Untersuchen → Fehler
Fehlgeschlagene Aufrufe, gruppiert nach Fehlertyp, mit direktem Zugriff auf Stack Traces.
Filter nach operation_Id, um alle Einträge einer einzigen Ausführung zu sehen.
Tipps für die Fehlersuche
operation_Id finden: Im Failures Blade auf einen fehlgeschlagenen Request klicken →
End-to-End Transaction Details → operation_Id ist in der URL bzw. in den Details sichtbar.
Komplette Traces aktivieren:TELEMETRY_CONTROL = TRACE_ALL setzen, den
problematischen Job über ExecuteJob manuell auslösen, anschließend zurücksetzen.
Zwischen Funktionen korrelieren: Schlägt eine der Process…QueueItems-Funktionen
fehl, ist die operation_Id der ursprünglichen GetChanges-Ausführung in der Nachricht
gespeichert — so lässt sich der vollständige Pfad eines Datensatzes nachvollziehen.
Beachten Sie dabei die Einschränkung beim Dependency-Sampling (siehe oben).
6.1.1 - Metriken
Custom Metrics der DataBridge — vorab aggregiert und ohne Sampling.
Neben Traces und Requests sendet die dsyr.DataBridge eigene Custom Metrics an
Application Insights. Metriken sind numerische Zeitreihen mit Dimensionen — sie eignen
sich für Dashboards, Trend-Analysen und Metric Alerts, ohne dass dafür Log-Einträge
durchsucht werden müssen.
Die Metriken werden über TelemetryClient.GetMetric()vorab aggregiert: Das SDK
sammelt die Werte lokal in 1-Minuten-Intervallen und sendet pro Intervall und
Dimensionskombination einen aggregierten Datenpunkt (Summe, Anzahl, Min, Max).
Metriken unterliegen keinem Sampling
Weder das gepufferte Logging noch das Dependency-Sampling noch das
Application-Insights-Sampling wirken auf Custom Metrics. Für belastbare Mengenangaben
sind sie deshalb die einzige verlässliche Quelle.
Eine verarbeitete Queue-Nachricht mit ihrem Ausgang. Queue-übergreifend: alle drei Prioritäts-Queues schreiben in dieselbe Metrik, unterscheidbar nur über den Ausgang, nicht über die Queue. Transitive heißt: die Nachricht wurde nicht endgültig verworfen, sondern in eine Retry-Queue umgeleitet.
Verarbeitungsdauer einer einzelnen Queue-Nachricht in Millisekunden, unabhängig vom Ausgang.
GetChanges hat keine job-genaue Erfolgs- oder Laufzeit-Metrik
Für GetChanges selbst gibt es aktuell nurChangesDetected (Anzahl, kein
Erfolg/Fehler-Signal) auf Job-Ebene. Erfolgsquote und Laufzeit von GetChanges stammen
aus den automatisch von der Functions-Runtime erzeugten Host-Metriken
(GetChanges Successes/Failures/AvgDurationMs/…, siehe unten) — die kennen nur den
gesamten Timer-Lauf, nicht die einzelnen Jobs darin.
Null-Werte sind bedeutungstragend
Auch Läufe ohne erkannte Änderungen schreiben den Wert 0. Dadurch ist unterscheidbar,
ob ein Job gelaufen ist und nichts gefunden hat oder gar nicht gelaufen ist — eine
Lücke in der Serie bedeutet Letzteres. Das macht die Metrik zur besten Grundlage für
Alerts auf hängende Jobs.
Anzeige in Azure
Metrics Explorer
Application Insights → Metriken → Namespace DataBridge auswählen → Metrik
ChangesDetected. Als Aggregation eignet sich Summe (Anzahl Datensätze) oder
Anzahl (Anzahl Läufe).
Einmalige Freischaltung für Dimensionen
Um im Metrics Explorer nach der Dimension JobName zu filtern oder zu splitten, muss
einmalig pro Application-Insights-Ressource die Option „Enable alerting on custom metric
dimensions" aktiviert werden:
Application Insights → Usage and estimated costs → Custom metrics.
Ohne diese Option erscheint die Metrik nur als Gesamtaggregat über alle Jobs.
Die KQL-Abfrage funktioniert unabhängig davon.
KQL (Logs)
Jeder aggregierte Datenpunkt landet zusätzlich in der Tabelle customMetrics:
customMetrics
| where name == "ChangesDetected"
| extend job = tostring(customDimensions["JobName"])
| summarize sum(valueSum) by bin(timestamp, 2m), job
| render timechart
Host-generierte Metriken (Functions-Runtime)
Zusätzlich zu den oben aufgeführten, selbst erzeugten Metriken schreibt die
Azure-Functions-Runtime automatisch pro Funktion aggregierte Kennzahlen ebenfalls in
die Tabelle customMetrics — ohne dass die DataBridge dafür Code enthält:
<FunctionName> ist z. B. GetChanges, ProcessStandardQueueItems,
ProcessLowPriorityQueueItems oder ProcessHighPriorityQueueItems. Diese Metriken sind
Standardverhalten des Functions-Hosts (WebJobs SDK Function Result Aggregator) und daher
in jeder Azure-Functions-App vorhanden, unabhängig von der DataBridge selbst. Das
Grafana-Dashboard nutzt sie für die Kopfzeilen-Tachos und die
Ausführungen/Laufzeiten-Panels der Zeile „GetChanges".
Nur Funktions-Ebene, keine Job-Ebene
Diese Host-Metriken kennen ausschließlich die aufrufende Funktion, nicht die einzelnen
Jobs, die innerhalb eines Laufs verarbeitet werden. Für job-genaue Aussagen sind
ChangesDetected bzw. MessagesProcessed/ProcessingDurationMs maßgeblich.
Limits
Limit
Wert
Anmerkung
Dimensionen pro Metrik
10
Azure-Monitor-Limit
Zeitreihen pro Metrik (SDK-Default)
1.000
seriesCountLimit der SDK-Pre-Aggregation
Distinct-Werte pro Dimension (SDK-Default)
100
valuesPerDimensionLimit
Konsequenz: Dimensionswerte müssen niedrig-kardinal sein — Job-Namen, Queue-Namen
und Status-Codes sind geeignet; IDs, Zeitstempel oder Datensatz-Schlüssel nicht.
6.1.2 - Performance & Laufzeiten
KQL-Abfragen für Laufzeiten, Fehlerquoten, Abhängigkeiten und Datenvolumen.
Die folgenden Abfragen können direkt im Logs-Bereich von Application Insights
(Kusto Query Language) ausgeführt werden.
Laufzeiten und Fehler
Laufzeiten aller Funktionen (letzte 24 Stunden)
requests
| where timestamp > ago(24h)
| summarize
    Aufrufe        = count(),
    DurchschnittMs = avg(duration),
    P95Ms          = percentile(duration, 95),
    Fehler         = countif(success == false)
  by name
| order by DurchschnittMs desc
Verlauf einer einzelnen Funktion (letzte 7 Tage)
requests
| where timestamp > ago(7d)
| where name == "GetChanges"
| summarize
    P50Ms  = percentile(duration, 50),
    P95Ms  = percentile(duration, 95),
    Fehler = countif(success == false),
    Läufe  = count()
  by bin(timestamp, 1h)
| order by timestamp asc
Durchschnittliche Laufzeit der letzten 30 Tage (täglich)
requests
| where timestamp > ago(30d)
| summarize
    DurchschnittMs = avg(duration),
    P95Ms          = percentile(duration, 95)
  by name, bin(timestamp, 1d)
| order by name asc, timestamp asc
Fehlerquote je Funktion (letzte 7 Tage)
requests
| where timestamp > ago(7d)
| summarize
    Gesamt    = count(),
    Fehler    = countif(success == false),
    FehlerPct = round(100.0 * countif(success == false) / count(), 1)
  by name
| order by FehlerPct desc
Warnungen und Fehler im Zeitverlauf
traces
| where timestamp > ago(7d)
| where severityLevel >= 2  // 2 = Warning, 3 = Error
| summarize Anzahl = count() by severityLevel, bin(timestamp, 1h), operation_Name
| order by timestamp asc
Top-10 häufigste Fehlermeldungen
exceptions
| where timestamp > ago(7d)
| summarize Anzahl = count() by outerMessage
| top 10 by Anzahl desc
Einzelne Ausführung nachvollziehen
Alle Einträge einer Ausführung (per operation_Id)
union requests, traces, exceptions
| where operation_Id == "<operation_Id hier einfügen>"
| project timestamp, itemType, severityLevel, message, outerMessage, operation_Name
| order by timestamp asc
Fehlerläufe mit allen zugehörigen Traces (letzte 24 Stunden)
let fehlgeschlagene =
    requests
    | where timestamp > ago(24h)
    | where success == false
    | project operation_Id, FunktionsName = name, Startzeit = timestamp;
traces
| where timestamp > ago(24h)
| join kind=inner fehlgeschlagene on operation_Id
| project Startzeit, FunktionsName, severityLevel, message
| order by Startzeit desc, severityLevel desc
Abhängigkeiten
Langsamste Abhängigkeiten (letzte 24 Stunden)
Zeigt die ausgehenden Aufrufe an Quell- und Zielsysteme mit den höchsten Laufzeiten:
dependencies
| where timestamp > ago(24h)
| summarize
    Aufrufe        = count(),
    DurchschnittMs = avg(duration),
    P95Ms          = percentile(duration, 95),
    Fehler         = countif(success == false)
  by type, target, name
| order by P95Ms desc
| take 20
Hinweis
Erfolgreiche, schnelle Aufrufe werden gesampelt (siehe
Sampling von Abhängigkeiten). Die Spalte Aufrufe ist
deshalb keine vollständige Zählung. Langsame und fehlgeschlagene Aufrufe sind dagegen
vollständig enthalten — für genau diese Auswertung ist die Abfrage also aussagekräftig.
Fehlgeschlagene Abhängigkeiten nach Zielsystem (letzte 7 Tage)
dependencies
| where timestamp > ago(7d)
| where success == false
| summarize Fehler = count() by type, target, resultCode
| order by Fehler desc
Datenvolumen und Kosten
Datenvolumen pro Tabelle
Wenn das tägliche Datenvolumen die konfigurierte Obergrenze (Daily Cap) erreicht, zeigt
diese Abfrage, welche Tabelle den Verbrauch verursacht:
union withsource = Tabelle *
| where TimeGenerated > ago(7d)
| summarize VolumenMB = round(sum(_BilledSize) / 1024.0 / 1024.0, 1) by Tabelle, bin(TimeGenerated, 1d)
| order by TimeGenerated desc, VolumenMB desc
Hinweis
Erfahrungsgemäß dominiert AppDependencies das Volumen deutlich. Greift die Obergrenze
trotz aktivem Sampling, ist TELEMETRY_DEPENDENCY_SAMPLE_RATE weiter zu reduzieren.
Zusätzlich ist zu prüfen, ob TELEMETRY_CONTROL versehentlich auf TRACE_ALL steht —
damit ist jedes Sampling deaktiviert.
Hinweise zur Interpretation
Warum fehlen manche Traces bei erfolgreichen Läufen?
Das Buffering sendet bei erfolgreichen Läufen nur einen Teil der Information-Einträge
und keine Debug-Einträge. Die Stichprobe wird pro Eintrag gezogen: Jede einzelne
Information-Zeile hat unabhängig eine Chance von 20 % (konfigurierbar via
TELEMETRY_INFO_SAMPLE_RATE), gesendet zu werden. Das führt zu einem gleichmäßigen Strom
vereinzelter Traces — vollständige, lückenlose Ketten gibt es nur bei Warning- und
Fehler-Läufen.
Trace-Einträge erreichen Application Insights grundsätzlich nie — sie sind nur live in
der Konsole bzw. im Log Stream sichtbar.
Warum fehlen manche Abhängigkeiten?
Fehlgeschlagene und langsame Aufrufe kommen immer vollständig an, erfolgreiche und
schnelle nur zu einem Anteil von 10 % (konfigurierbar via
TELEMETRY_DEPENDENCY_SAMPLE_RATE).
Anders als bei den Log-Einträgen wird diese Entscheidung pro Aufruf getroffen — in dem
Moment, in dem der Aufruf endet, also bevor das Ergebnis der Ausführung bekannt ist.
In der End-to-End-Transaktionsansicht sind daher auch bei einem fehlgeschlagenen Lauf
nicht zwangsläufig alle ausgehenden Aufrufe zu sehen. Für eine lückenlose Kette ist
temporär TELEMETRY_CONTROL=TRACE_ALL zu setzen.
Requests vs. Traces vs. Dependencies
Telemetrie-Typ
Wird immer erfasst?
Enthält Laufzeit?
Request
Ja — jede Invocation
Ja
Exception
Ja — jede Exception
Nein
Trace
Nein — abhängig vom Outcome
Nein
Dependency
Nein — garantiert nur, wenn der Aufruf selbst fehlschlägt oder den Langsam-Schwellwert überschreitet
Ja
Custom Metric
Ja — vorab aggregiert, kein Sampling
Nein
Für Laufzeit-Analysen der Funktionen immer die requests-Tabelle verwenden, für Laufzeiten
einzelner Fremdsystem-Aufrufe die dependencies-Tabelle, für inhaltliche Diagnose die
traces-Tabelle. Für belastbare Mengenangaben ausschließlich die
Custom Metrics, da diese nicht gesampelt werden.
Korrelation über operation_Id
Jede Funktionsausführung erhält eine eindeutige operation_Id. Alle Traces, Requests und
Exceptions dieser Invocation tragen dieselbe ID. Das erlaubt es, in KQL alle
zusammengehörenden Einträge mit einem einzigen Filter zu finden.
6.2 - Monitoring & Alerts
Azure Alert Rules und Action Groups für die automatische Überwachung der DataBridge.
Ein funktionierendes Monitoring erkennt Probleme, bevor sie auffallen.
Die DataBridge kann über Azure Monitor Alert Rules so konfiguriert werden,
dass bei Fehlern, Queue-Staus oder Dead-Letter-Einträgen automatisch Benachrichtigungen
ausgelöst werden.
Aufbau des Alert-Systems
Das Azure-Alert-System besteht aus zwei Komponenten:
Alert Rule                    Action Group
──────────────────            ──────────────────────────
Bedingung definieren    →     Wer wird benachrichtigt?
Scope: Ressource              E-Mail, SMS, Webhook, Azure Role
Condition: KQL / Metric
Schwellwert festlegen
kurz (max. 12 Zeichen), erscheint in Alert-E-Mails
Aktionstyp
E-Mail/SMS/Push/Voice oder Azure-Rolle (z. B. alle „Contributor")
Mitgeliefertes Dashboard
Unabhängig von Alerts liefert jede Installation ein vorkonfiguriertes
Grafana-Dashboard mit — es zeigt Erfolgsraten je Funktion,
Queue-Stände (aktive und Dead-Letter-Nachrichten, siehe unten) über alle drei
Prioritäts-Queues, Laufzeiten, Ausführungen und erkannte Änderungen je Job sowie
Exceptions. Es lässt sich zusätzlich nach Job und Zeitraster filtern. Es wird
automatisch angelegt und erfordert keine Einrichtung.
Vorkonfigurierte Alerts (per Bicep)
Das Deployment kann Alert Rules für die Dead-Letter-Queue und die Queue-Länge mit
anlegen. Sie sind standardmäßig deaktiviert:
Alerts müssen aktiviert werden
Die Alerts entstehen nur, wenn beim Deployment enableAlerts = true gesetzt und eine
notificationEmail angegeben wird. Im Marketplace-Assistenten stehen beide unter
Product Settings → Alert. Ohne diese Angaben wird kein Alert angelegt.
Das Deployment erzeugt dabei auch die zugehörige Action Group (ag-<name>,
Kurzname DLQAlert) — eine handangelegte Gruppe ist dafür nicht nötig.
Trigger
Standard-Schwellwert
Parameter
Prüfintervall
Severity
DLQ ≥ 1
1 Nachricht
dlqLowThreshold
5 Minuten
3 — Informational
DLQ > 50
50 Nachrichten
dlqMediumThreshold
15 Minuten
2 — Warning
DLQ > 200
200 Nachrichten
dlqHighThreshold
30 Minuten
1 — Error
DLQ > 500
500 Nachrichten
dlqCriticalThreshold
5 Minuten
0 — Critical
Queue-Länge > 300.000
300.000 Nachrichten
—
15 Minuten
2 — Warning
Ausgewertet werden die Service-Bus-Metriken DeadletteredMessages bzw. ActiveMessages
über die Dimension EntityName = *, also je Queue einzeln. Alle Schwellwerte sind
beim Deployment als Parameter überschreibbar.
Auto-Mitigate statt einmaliger Meldung
Die Regeln sind normale Metric Alerts mit aktiviertem Auto-Mitigate: Sie lösen bei
Unterschreiten des Schwellwerts wieder auf („Entwarnung") und können danach erneut
feuern.
Scope: Application Insights-Ressource der DataBridge
Condition: Custom log search (KQL)
requests
| where operation_Name == "GetChanges"
| where success == false
| summarize FailedCalls = count() by bin(timestamp, 1h)
Alert-Logik:
Einstellung
Wert
Messgröße
FailedCalls
Aggregationstyp
Maximum
Granularität
1 Stunde
Operator
Größer oder gleich
Schwellwert
1 (sofort bei erstem Fehler) oder 5 (bei mehreren Fehlern)
Prüfhäufigkeit
1 Stunde
Action Group: hier die zuvor angelegte Gruppe auswählen.
Empfohlene Alert Rules
Rule
Scope
Bedingung
Schwellwert
Priorität
DLQ-Nachrichten vorhanden
Service Bus
DLQ Count > 0
1
🔴 Kritisch
Fehler in GetChanges
App Insights
Fehlgeschlagene Requests
1/h
🔴 Kritisch
GetChanges arbeitet nicht mehr
App Insights
Ausführungen pro Stunde kleiner als 1
1
🔴 Kritisch
Fehler in ProcessStandardQueueItems
App Insights
Fehlgeschlagene Requests
5/h
🟡 Warnung
Queue wächst unkontrolliert
Service Bus
Queue Length
10.000
🟡 Warnung
Hohe Laufzeit
App Insights
P95 > 30.000 ms
30 Sekunden
🔵 Info
Stillstand erkennen
Der wichtigste Alert ist derjenige auf ausbleibende Läufe — ein stehengebliebener
Timer erzeugt keine Fehler und fällt sonst nicht auf:
requests
| where name == "GetChanges"
| summarize Executions = count() by bin(timestamp, 1h)
Operator Kleiner als, Schwellwert 1.
Alternativ metrikbasiert über die Custom Metric ChangesDetected: Da auch Läufe ohne
Änderungen den Wert 0 schreiben, bedeutet eine Lücke in der Serie, dass der Job
nicht gelaufen ist — siehe Metriken.
Der Schwellwert für die Queue-Länge ist hier bewusst strenger gewählt als der
Deployment-Standard (300.000) — er schlägt an, lange bevor sich ein Rückstau aufbaut.
Keine Alerts auf die Tabelle `dependencies`
Fehlerquoten der Form countif(success == false) / count() über dependencies sind
seit v2.1 stark überhöht, weil erfolgreiche Aufrufe gesampelt werden, fehlgeschlagene
aber vollständig ankommen. Solche Alerts auf die Tabelle requests umstellen — sie
unterliegt keinem Sampling. Details unter
Logging.
Budget-Überwachung (empfohlen)
Zusätzlich zum operativen Monitoring empfiehlt sich eine Budget-Warnung
auf Abonnement-Ebene:
Budget für die Ressourcengruppe der DataBridge festlegen
Alert bei 80 % und 100 % des Budgets
Empfänger: gleiche Action Group wie operative Alerts
So werden unerwartete Kostensteigerungen (z. B. durch Queue-Stau und erhöhte
Service Bus-Operationen) frühzeitig erkannt.
6.3 - Grafana-Dashboard
Das mitgelieferte Betriebsdashboard in Application Insights — Erfolgsraten, Queue-Stände, Laufzeiten, Ausführungen und Fehler je Job, mit Job- und Zeitraster-Filter.
Seit v2.1 liefert jede Installation ein vorkonfiguriertes Grafana-Dashboard mit.
Es zeigt auf einen Blick, ob die DataBridge läuft, wie schnell sie arbeitet und wo Fehler
auftreten — ohne dass dafür KQL-Abfragen geschrieben werden müssen.
Ohne Zutun vorhanden
Das Dashboard wird bei jedem Deployment automatisch angelegt. Es gibt keinen
Schalter zum Abwählen und keine manuelle Einrichtung. Zusätzliche Kosten entstehen
nicht — die Abfragen laufen gegen die ohnehin vorhandene Application-Insights- und
Service-Bus-Instanz.
Wo finde ich es?
Azure Portal → Application Insights-Ressource der DataBridge → Bereich
„Dashboards with Grafana". Das Dashboard ist außerdem direkt von der
Function App aus verlinkt.
Die Dashboard-Ressource selbst liegt als dash-<name> in derselben Ressourcengruppe.
Es handelt sich nicht um eine eigene Azure-Managed-Grafana-Instanz, sondern um das
in Application Insights integrierte Grafana-Feature.
Aufbau
Das Dashboard heißt DataBridge Dashboard und zeigt standardmäßig die letzten
7 Tage. Ein automatischer Refresh ist nicht eingestellt — die Aktualisierung erfolgt
über den Refresh-Knopf bzw. beim Neuladen.
Filter (Dashboard-Variablen)
Oben im Dashboard stehen zwei Variablen zur Verfügung, die für (fast) alle Panels gelten:
Größe der Zeit-Fenster, in die die Zeitreihen-Panels ihre Werte gruppieren. Kleinerer Wert = feinere, aber unruhigere Kurven; größerer Wert = glattere Kurven über einen langen Zeitraum.
Job Namen (jobName)
Mehrfachauswahl aus den tatsächlich aktiven Jobs, inkl. „All"
Schränkt alle job-bezogenen Panels auf die gewählten Jobs ein. Die Liste wird live aus den letzten Metrik-Daten gezogen (Jobs, die aktuell nur 0 liefern, tauchen nicht auf — siehe unten).
Nicht jedes Panel reagiert auf beide Filter
Die Kopfzeilen-Gauges sowie die beiden Service-Bus-Gauges kennen keine Job-Dimension
und reagieren daher nicht auf Job Namen — sie sind Aggregate über die jeweilige
Funktion bzw. Queue. Alle Panels in den drei aufklappbaren Zeilen unten reagieren auf
Bin Size; die job-bezogenen darunter zusätzlich auf Job Namen.
Kopfzeile: Erfolgsraten und Queue-Stände
Immer sichtbar, sieben Kacheln:
Kachel
Typ
Zeigt
GetChanges SuccessRate
Tacho (0–100 %)
Erfolgsquote der Änderungserkennung
ProcessQueueItems SuccessRate
Tacho (0–100 %)
Erfolgsquote der Verarbeitung, über alle drei Queues (Low/Standard/High) zusammengefasst
Active Messages
Tacho
Aktuell wartende Nachrichten, summiert über alle drei Export-Queues (sbqexport, sbqhighexport, sbqlowexport)
Deadletter
Tacho
Nachrichten in den Dead-Letter-Queues, summiert über alle drei Export-Queues
Low
Tacho (0–100 %)
Erfolgsquote der Verarbeitung niedriger Priorität
Standard
Tacho (0–100 %)
Erfolgsquote der Verarbeitung mit Standard-Priorität
High
Tacho (0–100 %)
Erfolgsquote der Verarbeitung hoher Priorität
Farbschwellen der vier SuccessRate-Tachos: rot ab 0 %, gelb ab 80 %, grün ab
95 %. Die beiden Service-Bus-Tachos (Active Messages, Deadletter) färben relativ
zum aktuellen Wertebereich (grün → orange ab 70 % → rot ab 85 %), nicht anhand fester
Nachrichtenzahlen — bei sehr wenigen Nachrichten insgesamt kann die Einfärbung daher
empfindlicher wirken als bei einer großen Queue.
Alle sieben Kopfzeilen-Kacheln werten den im Dashboard gewählten Zeitraum aus (die
SuccessRate-Kacheln über dashboardTime, die Service-Bus-Kacheln, weil Azure-Monitor-
Platform-Metriken grundsätzlich immer an den Zeitraum gebunden sind).
Frühere Einschränkung entfällt
Bis einschließlich v2.2 folgten die vier SuccessRate-Kacheln dem Dashboard-Zeitraum
nicht und zeigten stattdessen einen festen Wert. Das ist seit der Überarbeitung des
Dashboards behoben — alle Kopfzeilen-Kacheln sind jetzt zeitraum-sensitiv.
Zeile „GetChanges"
Aufklappbar, drei Panels — Datenquelle sind hier weiterhin die von der Functions-Runtime
automatisch erzeugten Host-Metriken (GetChanges Successes/Failures/AvgDurationMs/…),
da GetChanges als Ganzes noch keine Job-granulare Erfolg/Fehler-Metrik im eigenen Code
erzeugt (siehe Metriken):
Panel
Typ
Inhalt
Ausführungen
Balken
Erfolgreiche gegen fehlgeschlagene Läufe, gruppiert nach Bin Size
Laufzeiten
Verlauf
Durchschnittliche, minimale und maximale Laufzeit in Millisekunden, gruppiert nach Bin Size
GetChanges per Jobs
Verlauf
Erkannte Änderungen je Job — basiert auf der Custom Metric ChangesDetected mit der Dimension JobName; reagiert auf Job Namen
Das Panel GetChanges per Jobs ist im Alltag das aussagekräftigste: Es zeigt pro Job,
wie viele Änderungen erkannt wurden. Da auch Läufe ohne Änderungen den Wert 0
schreiben, bedeutet eine Lücke in der Kurve, dass der Job gar nicht gelaufen ist —
nicht, dass es nichts zu tun gab.
Wichtige Grenze: keine Job-Erfolgsquote für GetChanges
GetChanges Successes/Failures zählen Timer-Läufe, nicht einzelne Jobs. Ein
Timer-Lauf verarbeitet üblicherweise mehrere Jobs in einer Schleife; solange dabei keine
unbehandelte Ausnahme bis zum Funktionsaufruf durchschlägt, gilt der Lauf als
„erfolgreich" — auch wenn ein einzelner Job innerhalb des Laufs intern gescheitert ist
(z. B. weil ein Connector den Fehler geloggt, aber nicht weitergeworfen hat). Für eine
job-genaue Aussage reicht diese Zeile aktuell nicht aus.
Zeile „ProcessQueueItems"
Aufklappbar, vier Panels. Anders als bei GetChanges gibt es hier bereits eine
job-granulare Custom Metric (MessagesProcessed, siehe Metriken),
die zudem queue-übergreifend ist — alle drei Queues (Low/Standard/High) laufen durch
denselben Verarbeitungscode und tauchen deshalb gemeinsam in einer Sicht auf, statt wie
früher pro Queue getrennt zu sein:
Panel
Typ
Inhalt
Ausführungen
Balken
MessagesProcessed nach Ausgang (Success/Failed/Transitive), gruppiert nach Bin Size, gefiltert nach Job Namen
Laufzeiten
Verlauf
Durchschnittliche, minimale und maximale Verarbeitungsdauer (ProcessingDurationMs) über alle gefilterten Jobs zusammengefasst, gruppiert nach Bin Size
ProcessItems Success per Job
Verlauf
Erfolgreich verarbeitete Nachrichten je Job (Outcome = Success), gruppiert nach Bin Size, gefiltert nach Job Namen
ProcessItems Errors per Job
Verlauf
Fehlgeschlagene (Failed) und in eine Retry-Queue umgeleitete (Transitive) Nachrichten je Job, als getrennte Linien pro Job und Ausgang, gefiltert nach Job Namen
Transitive bedeutet: die Nachricht wurde nicht endgültig verworfen, sondern in eine
Retry-Queue (TransitiveLow/TransitiveStandard/TransitiveHigh) umgeleitet, weil eine
TransitiveException aufgetreten ist — kein finaler Fehler, aber auch kein
abgeschlossener Erfolg.
Laufzeiten-Panel ist bewusst nicht nach Job aufgeschlüsselt
Das Panel „Laufzeiten" fasst Durchschnitt/Min/Max über alle durch Job Namen
ausgewählten Jobs zusammen, statt eine Linie pro Job zu zeichnen. Das hält das Panel bei
vielen aktiven Jobs lesbar. Wer die Laufzeit eines einzelnen Jobs braucht, wählt ihn über
Job Namen gezielt aus, statt „All" stehen zu lassen.
Zeile „Fehler-Überblick"
Aufklappbar, ein Panel: Heatmap — Anzahl der Ausnahmen (exceptions-Tabelle) je
Zeitfenster (Bin Size), aufgeschlüsselt nach Exception-Typ.
Keine Job-Filterung möglich
Exceptions werden ohne JobName-Property getrackt (TelemetryClient.TrackException
läuft ohne zusätzliche Properties). Die Variable Job Namen wirkt sich auf dieses
Panel nicht aus — es zeigt immer alle Exceptions im gewählten Zeitraum, unabhängig
von der Job-Auswahl oben.
Was das Dashboard nicht abdeckt
Damit klar ist, wofür weiterhin andere Werkzeuge nötig sind:
Keine Job-genaue Fehlerursache für GetChanges — nur Timer-Lauf-Ebene, siehe
Warnung oben. Für Details bleibt das Log (traces/exceptions) nötig.
Keine Fehlerquoten über requests oder dependencies — hierfür die
KQL-Abfragen verwenden.
Keine Alarmierung — das Dashboard ist eine Ansicht, kein Alerting. Dafür sind
die Alerts zuständig.
Eigene Anpassungen
Manuelle Änderungen werden überschrieben
Änderungen, die direkt im Portal am Dashboard vorgenommen werden, gehen beim nächsten
Deployment verloren — das Deployment setzt die Dashboard-Definition unbedingt neu.
Anpassungen, die dauerhaft erhalten bleiben sollen, müssen in die Deployment-Vorlage
zurückfließen. Wenden Sie sich dafür an WYSA; das Dashboard wird zentral gepflegt und
mit dem nächsten Release ausgeliefert.
Wer eine rein persönliche Ansicht braucht, legt sich im Portal ein eigenes, zusätzliches
Dashboard an — dieses bleibt vom Deployment unberührt.
6.4 - Updates & Upgrades
Wie die DataBridge aktualisiert wird und welche Breaking Changes bei Versionssprüngen zu beachten sind.
Diese Seite beschreibt das Vorgehen bei einem Update. Die vollständigen Änderungen und
Installationshinweise je Release stehen in der Versionshistorie.
Vorgehen bei einem Update
Die Konfiguration in Table Storage bleibt bei einem Update unverändert — es sei denn, ein
Breaking Change erfordert Anpassungen.
Schritte
Release Notes prüfen — Breaking Changes und Installationshinweise des Zielrelease
und aller dazwischenliegenden Versionen lesen (Versionshistorie)
Wartungsfenster einplanen — GetChanges über ein App-Setting deaktivieren:
AzureWebJobs.GetChanges.Disabled = true
Bei Bedarf lassen sich die Verarbeiter analog abschalten
(AzureWebJobs.ProcessStandardQueueItems.Disabled usw.)
Warten, bis alle Queue-Nachrichten verarbeitet wurden (Queue-Länge im Azure Portal
prüfen)
Neue Version einspielen — je nach Betriebsart:
Container: Image-Tag auf die neue Version setzen
Marketplace: Assistenten erneut durchlaufen (bei unveränderten Standardwerten
ergibt sich keine Änderung an bestehenden Einstellungen)
Bicep / Pipeline: Deployment erneut ausführen
Zip-Upload: Paket über die Pipeline oder manuell einspielen
Konfigurationsanpassungen aus den Installationshinweisen vornehmen
Ersten Lauf beobachten — z. B. über die Custom Metric ChangesDetected je Job oder
die Fehlerquoten-Abfrage unter
Performance & Laufzeiten
App-Settings lösen einen Neustart aus
Jede Änderung an den App-Settings startet die Function App neu. Das ist beim Ein- und
Ausschalten der Funktionen in Schritt 2 und 6 eingeplant.
Breaking Changes je Version
Die vollständigen Breaking Changes und Installationshinweise stehen ausschließlich in
den Release Notes der jeweiligen Version — hier nur der Überblick, ob ein Übergang
überhaupt einen Breaking Change enthält:
Beim Überspringen von Versionen sind die Release Notes aller dazwischenliegenden
Versionen zu beachten, nicht nur die des Zielrelease.
7 - Versionshistorie
Release-Dokumentation aller Versionen der dsyr.DataBridge — Änderungen, neue Funktionen und Installationshinweise.
Hier findet sich die Release-Dokumentation für alle Versionen der dsyr.DataBridge.
Jede Version beschreibt die wesentlichen Änderungen aus Anwender-Sicht sowie
Installationshinweise für Administratoren, die ein bestehendes System aktualisieren. Die
Details zu etwaigen Breaking Changes stehen jeweils im Abschnitt Installationshinweise
der verlinkten Release-Seite.
Tabellen- und Spalten-Metadaten der SQL-Connectoren (MSSQL, MySQL, Oracle, PostgreSQL) über den MCP-Server, Mapping-Abfrage per Name, schlankeres NAV-Logging, Managed Identity (System/User-assigned) für D365BC und D365CE mit neuem Verbindungsfeld authmethod; für Entwickler: lokale Podman-Testumgebung mit HTTP-Mocks, Service-Bus-Emulator und Debug-Modus
Neuer OpenAPI-Connector, eingebauter MCP-Server für KI-Assistenten, Action-Jobs, System-assigned Managed Identity für die Function App, Verbesserungen am Grafana-Dashboard
Migrationshinweise für die Übergänge 1.0 → 1.1 und 1.1 → 2.0
❗
Vor einem Update lesen
Die Abschnitte Installationshinweise der jeweiligen Version enthalten die Details zu
Breaking Changes und notwendigen Migrationsschritten. Beim Überspringen von Versionen sind
die Hinweise aller dazwischenliegenden Releases zu beachten — die Spalte oben zeigt
nur, ob ein Übergang überhaupt einen Breaking Change enthält, keine vollständige Liste.
7.1 - Release v2.3
Managed Identity (system- und benutzer-zugewiesen) für D365BC und D365CE, Tabellen- und Spalten-Metadaten der SQL-Connectoren (MSSQL, MySQL, Oracle, PostgreSQL) über den MCP-Server, genauere Datentypen, Mapping-Abfrage per Name, schlankeres NAV-Logging, wieder funktionierendes Lesen aus PostgreSQL, MySQL und Oracle, behobene Abbrüche beim Schreiben von SQL-Datums-, Ganzzahl- und Fließkommafeldern nach BC/NAV/CE/OpenAPI und eine lokale Podman-Testumgebung mit Datenbanken, HTTP-Mocks und einem Service-Bus-Emulator für BC, NAV und OpenAPI.
Was ist neu
Neue Funktionen
Metadaten-Abfrage für die SQL-Connectoren: Die MCP-Tools list_connector_tables und get_connector_table_schema funktionieren jetzt auch für MSSQL, MySQL, Oracle und PostgreSQL. Bisher war das nur für BC, NAV, CE (Dataverse) und OpenAPI möglich, bei SQL-Verbindungen brach der Aufruf mit einer Fehlermeldung ab. Geliefert werden Spaltenname, Typ, Nullable, maximale Länge, bei Dezimalspalten Precision und Scale sowie der Primary Key — direkt aus dem Datenbank-Katalog (INFORMATION_SCHEMA, bei Oracle USER_*/ALL_*-Views).
Über apiPath wird das Schema gewählt (MySQL: die Datenbank, Oracle: der Owner). Ohne Angabe gilt das Standard-Schema der Verbindung, sodass gleichnamige Tabellen in verschiedenen Schemas (z. B. dbo.Customers / archive.Customers) nicht vermischt werden. Die Metadaten werden zwischengespeichert; Schemaänderungen an der Datenbank werden erst nach einem Neustart der Function App sichtbar. Details: MCP-Server → Operationen.
Genaue .NET-Datentypen je Datenbank: Die Spaltentypen werden je Datenbank passend abgebildet — z. B. date als DateOnly, time als TimeSpan, Spalten mit Zeitzone als DateTimeOffset, Binärspalten als Byte[], MySQL BOOLEAN (tinyint(1)) als Boolean und Oracle NUMBER(p,0) je nach Stellenzahl als Int16/Int32/Int64. Die vollständige Übersicht steht unter MCP-Server → Operationen.
Managed Identity für D365CE (Dataverse): Die Verbindung kann statt über einen Connection-String mit Secret direkt über die Managed Identity der Function App aufgebaut werden. Dazu url (und optional clientid für eine benutzer-zugewiesene Identity) in der Connection angeben. Ein vorhandener connectionstring hat weiterhin Vorrang. Siehe D365CE.
Managed Identity für D365BC (Cloud): Neue Authentifizierungsart ManagedIdentity für HTTP-Konnektoren. Ohne clientId wird die system-zugewiesene, mit clientId die benutzer-zugewiesene Identity genutzt. Der Token wird automatisch erneuert, bevor er abläuft, und mit dem scope der Connection angefordert. Siehe D365BC.
Neuer Verbindungsparameter authmethod: Erlaubt es, die Authentifizierungsmethode ausdrücklich festzulegen (BasicAuthentication, OAuth2, APIKey, ManagedIdentity). Ohne Angabe bleibt das bisherige Verhalten unverändert. ManagedIdentity wird nie automatisch aus fehlenden Zugangsdaten abgeleitet, damit eine unvollständige Connection weiterhin sofort mit einem klaren Fehler abbricht. Siehe Verbindungen.
Fehlerbehebungen & Verbesserungen
Allgemein
Felder fehlten gelegentlich in der Verarbeitung: Wurden die Mappings neu geladen, während gleichzeitig Änderungen gelesen oder Nachrichten verarbeitet wurden, konnte ein Job auf ein noch unvollständiges Mapping treffen. Einzelne Felder, z. B. die Kontaktnummer einer Firma, wurden dann nicht übertragen. Die Mappings werden jetzt vollständig aufgebaut und erst danach aktiv geschaltet.
Service Bus: Skalierung ohne Managed Identity: Im schlüsselbasierten Modus (Standard, enableManagedIdentity nicht gesetzt) setzt das Bicep-Deployment jetzt TARGET_BASED_SCALING_ENABLED=0. Der Host skaliert dann direkt über den Metrics Monitor, und die bisherige Warnung zum Target-based Scaling im Log entfällt. Siehe Umgebungsvariablen.
Mapping-Abfrage über den Namen: Das MCP-Tool get_mapping und der HTTP-Endpunkt GET /mapping/{name} finden ein Mapping jetzt über seinen Namen — also den Namen, auf den ein Job verweist und unter dem list_mappings es auflistet. Bisher wurde nur der RowKey des ersten Feldeintrags verglichen, sodass ein Mapping über seinen Namen meist nicht gefunden wurde. Die bisherige Suche über den RowKey funktioniert weiterhin.
get_connector_table_schema akzeptiert jetzt auch den kombinierten Tabellennamen: Bei BC/NAV/CE/OpenAPI wird der API-Pfad in Jobs/Mappings üblicherweise zusammen mit der Tabelle geschrieben (z. B. v2.0/customers). Wurde dieser kombinierte Wert unverändert als tableName übergeben und apiPath weggelassen, schlug die Metadaten-Abfrage mit einer schwer deutbaren Exception fehl (Could not read Metadata for path). Das Tool trennt den API-Pfad jetzt selbst ab, wenn apiPath leer bleibt und tableName einen / enthält — Aufrufe mit getrennten Parametern funktionieren unverändert.
Nachvollziehbare MCP-Aufrufe im Log: Jeder MCP-Aufruf schreibt eine Logzeile mit dem Namen der Operation und — wo vorhanden — dem gelesenen Job, Mapping bzw. der Connection und Tabelle, z. B. MCP get_connector_table_schema: connection=oracle-dev, table=Account. Datensatzinhalte oder Zugangsdaten werden nicht geloggt.
Aktualisierte Abhängigkeiten (u. a. Azure.Data.Tables, Azure.Messaging.ServiceBus, Azure.Security.KeyVault.Secrets 4.11.2, Microsoft.IdentityModel.Tokens, Microsoft.OData.Core/Microsoft.OData.Edm auf 9.0.0, Microsoft.Data.SqlClient 7.1.1, MySql.Data 26.10.0, Oracle.ManagedDataAccess.Core 23.26.400, Microsoft.OpenApi 3.11.0, ModelContextProtocol 2.3.0, Durable-Functions-Extension 1.20.1 — rein intern, keine Verhaltensänderung). System.Security.Cryptography.Xml steht auf 10.0.14 und schließt damit mehrere als „hoch“ eingestufte Sicherheitslücken der Vorversion.
D365CE (Dataverse)
Fehlender oder inaktiver Alternativschlüssel wird nicht mehr als „Datensatz nicht gefunden“ gewertet: Ist der in TargetKey verwendete Schlüssel in Dataverse nicht definiert oder nicht aktiv, bricht die Verarbeitung jetzt mit einem Fehler ab. Die Nachricht wird wiederholt und landet anschließend in der Dead-Letter-Queue. Bisher wurde der Datensatz in diesem Fall als nicht vorhanden behandelt und neu angelegt, was zu Dubletten führen konnte. Siehe D365CE.
Fehler beim Nachschlagen eines Datensatzes führten still zu falschen Daten: Schlug das Lesen des bestehenden Zieldatensatzes fehl, etwa durch Throttling (Service-Protection-Limits), Timeout, Netzwerk- oder Rechtefehler, wurde das bisher wie „Datensatz existiert nicht“ behandelt. Die Folgen blieben unbemerkt: Löschungen wurden übersprungen und die Nachricht als erledigt abgeschlossen, Felder mit leerem Quellwert wurden im Ziel nicht geleert, und Lookups mit DoNotCreate konnten eine bestehende Referenz leeren. Jetzt gilt nur noch die Dataverse-Meldung „Datensatz nicht gefunden“ als solcher; jeder andere Fehler wird mit Details geloggt, die Nachricht wiederholt und notfalls in die Dead-Letter-Queue gelegt.
Nachgeschlagene Werte wurden nicht aktualisiert, wenn sie beim ersten Lesen noch fehlten: Lookups mit UseCache (z. B. die BC-Kontaktnummer der Firma auf Kontakten und Verkaufschancen) speicherten auch ein leeres Ergebnis und behielten einen einmal gelesenen Wert bis zum Neustart der Function App. War die Nummer beim ersten Lesen noch nicht aus BC zurückgeschrieben, wurde das Feld deshalb auch danach leer übertragen. Leere Ergebnisse werden jetzt nicht mehr gespeichert, und beim Lesen der Änderungen ersetzt ein frisch gelesener Wert immer den gespeicherten. Nicht mehr vorhandene Datensätze werden aus dem Zwischenspeicher entfernt.
Boolean-Felder aus Ganzzahlen befüllen: Ja/Nein-Felder akzeptieren jetzt auch die Quelltypen byte (z. B. SQL tinyint) und int32 (0 = Nein, sonst Ja). Statusfelder (statecode) akzeptieren zusätzlich byte.
BC, NAV & OpenAPI
HTTP-Konnektoren (BC, NAV, OpenAPI) konnten nach dem Start dauerhaft ausfallen: Verarbeiteten mehrere Queue-Nachrichten gleichzeitig ihren ersten Aufruf an dasselbe Zielsystem, richteten sie den gemeinsamen HTTP-Client parallel ein. Das führte zu Fehlern wie Object reference not set to an instance of an object oder This instance has already started one or more requests. Danach blieb der Client unvollständig eingerichtet (z. B. ohne Authentifizierung), und alle weiteren Nachrichten an dieses System schlugen bis zum Neustart der Function App fehl. Die Einrichtung ist jetzt gegen parallelen Zugriff geschützt, und eine fehlgeschlagene Einrichtung wird beim nächsten Aufruf wiederholt.
Update nach BC oder NAV schlug fehl, wenn ein Zielfeld dort bereits leer war: War ein Feld im bestehenden BC- oder NAV-Zieldatensatz null (z. B. ein noch nicht gesetztes Abschlussdatum) und hatte sich irgendein anderes Feld des Datensatzes geändert, brach die Aktualisierung mit einer NullReferenceException ab. Der interne Änderungsvergleich ging fälschlich davon aus, dass ein vorhandenes Feld nie leer sein kann. Behoben.
BC/NAV: Update mit TargetKey vom Typ Filter schlug bei Guid- oder Zahl-Schlüsseln fehl: Der Schlüssel aus KeyAttributeFromExisting wurde immer in Hochkommas gesetzt (z. B. customers('1111…')). Bei Schlüsselfeldern vom Typ Guid oder Zahl, etwa dem BC-Feld id, ergab das eine ungültige Anfrage. Der Schlüssel wird jetzt passend zum Feldtyp aus den Metadaten geschrieben, und Hochkommas im Wert werden maskiert. Fehlt das Feld im bestehenden Datensatz, bricht die Verarbeitung mit einer klaren Fehlermeldung ab statt mit einer NullReferenceException.
BC: Tabellen-Metadaten wurden zwischen API-Pfaden vermischt und nicht gefundene Tabellen dauerhaft zwischengespeichert: Der Metadaten-Cache unterschied Tabellen nur nach ihrem Namen, nicht nach dem API-Pfad. Gab es eine Tabelle (z. B. customers) unter einem API-Pfad nicht, unter einem anderen aber schon, konnte das Ergebnis des einen Pfads für den anderen verwendet werden. War eine Tabelle beim ersten Zugriff noch nicht in $metadata enthalten (z. B. weil eine Extension erst später veröffentlicht wurde), blieb dieser Fehlschlag bis zum Neustart der Function App bestehen. Der Cache unterscheidet jetzt nach API-Pfad und Tabelle. Nicht gefundene Tabellen werden nicht mehr gespeichert, beim nächsten Aufruf wird $metadata neu gelesen.
NAV: Metadaten nicht mehr im Log, klare Fehlermeldung: Der NAV-Konnektor hat beim Laden der Metadaten die komplette $metadata-Antwort auf Level Information geloggt. Bei echten NAV-Installationen sind das oft mehrere hundert KB bis einige MB je Neustart. Das erzeugte unnötiges Log-Volumen in Application Insights und wurde dort ohnehin abgeschnitten. Der Konnektor verhält sich jetzt wie der BC-Konnektor und loggt nur noch die Anzahl der gefundenen EntitySets. Außerdem prüft er den Statuscode. Antwortet der Server nicht mit Erfolg (z. B. 401 oder 500), erscheint Could not read Metadata from <URL> (StatusCode: …) statt eines schwer deutbaren Parse-Fehlers. Die Metadaten werden weiterhin tolerant gelesen.
NAV: Später veröffentlichte Tabellen wurden erst nach einem Neustart erkannt: Fehlte eine Tabelle beim ersten Laden der Metadaten, blieb das veraltete Modell bis zum Neustart der Function App aktiv. Jetzt werden die Metadaten beim nächsten Aufruf neu gelesen. Außerdem wird $metadata nicht mehr doppelt abgerufen, wenn sowohl die Tabellenliste als auch die Tabellen-Metadaten benötigt werden.
Aktualisieren eines bestehenden Datensatzes in einer OpenAPI-Zielressource schlug grundsätzlich fehl: Jeder Schreibvorgang, der einen Datensatz aktualisiert statt neu anzulegen (PATCH/PUT), brach mit einer NullReferenceException ab — betroffen war der reguläre Verarbeitungspfad ohne Antwort-Job, also der Normalfall. Ursache war eine fehlende Null-Prüfung beim Zusammenbauen des Request-Bodys. Neuanlagen (POST) waren nicht betroffen. Behoben.
OpenAPI: Aktualisieren und Löschen mit TargetKey vom Typ Filter gingen an eine falsche URL: Der Konnektor setzte den Suchfilter selbst als Schlüssel in die Item-URL ein. Jetzt wird zuerst der passende Datensatz gesucht und dessen Schlüssel verwendet: das Feld aus KeyAttributeFromExisting, sonst der Primärschlüssel aus der Spezifikation (id, uuid …). Findet der Konnektor beim Löschen keinen Datensatz, schreibt er eine Warnung ins Log und sendet kein DELETE. Der Fehler bestand seit v2.2.
OpenAPI: Gleichnamige Ressourcen verschiedener Connections wurden vermischt: Boten zwei OpenAPI-Verbindungen eine Ressource mit demselben Namen an (z. B. clients), verwendete die zweite das Schema der ersten. Der Fehler bestand seit v2.2. Jetzt wird das Schema je Spezifikation zwischengespeichert.
Doku OpenAPI-Konnektor korrigiert: Der Hinweis, dass der Konnektor die Spezifikation aus einer festen lokalen Datei lädt, war veraltet. Die Spezifikation wird über openApiSpecUrl geladen. Neu dokumentiert sind zwei bekannte Einschränkungen (siehe unten).
PostgreSQL, MySQL und Oracle als Quelle: Lesen schlug grundsätzlich fehl: Der Konnektor erzeugte eine ungültige Abfrage, weil zwischen der letzten Spalte und FROM das Leerzeichen fehlte (z. B. …,RevenueFROM Account). Jeder Job mit einer dieser Datenbanken als Quelle brach mit einem Datenbankfehler ab (PostgreSQL: column … does not exist, MySQL: Unknown column, Oracle: ORA-00904). Der Fehler bestand seit v2.2. MSSQL war nicht betroffen. Behoben.
MSSQL: Spaltennamen werden immer in eckige Klammern gesetzt: Alle Spalten aus dem Mapping und das WatermarkField werden jetzt in [...] eingeschlossen, nicht mehr nur Namen mit Leerzeichen. Damit funktionieren auch reservierte Wörter wie Order oder Key als Spaltenname. Für Mappings mit reinen Spaltennamen ändert sich nichts. Ausdrücke oder Aliasse als SourceField wurden schon vorher nicht unterstützt. Siehe MSSQL.
Datumsfelder aus SQL-Quellen (DATE-Spalte) nach BC, NAV, Dataverse (CE) oder OpenAPI schlugen fehl: Stammte ein Datumswert aus einer MSSQL-, PostgreSQL-, MySQL- oder Oracle-Spalte vom Typ DATE (intern als DateOnly geführt) und das Zielfeld lag bei BC, NAV, Dataverse oder einer OpenAPI-Zielressource, brach die Verarbeitung mit Source Type not yet implemented ab. Die Datums- und Datum/Zeit-Resolver kannten nur ihren eigenen internen Typnamen „Date“, nicht „DateOnly“. Betroffen waren ausschließlich Jobs mit einer SQL-Datenbank als Quelle. Behoben, indem alle Datums-Resolver jetzt beide Typnamen akzeptieren.
Ganzzahl- und Fließkommafelder aus SQL-Quellen mit TINYINT/SMALLINT/BIGINT/REAL schlugen fehl: Aus demselben Grund brach die Verarbeitung mit Source Type not yet implemented ab, wenn eine SQL-Spalte vom Typ TINYINT, SMALLINT, BIGINT oder einem kleinpräzisen FLOAT/REAL in ein Ganzzahl-, Dezimal- oder Fließkomma-Zielfeld bei BC, NAV oder Dataverse geschrieben wurde. Auch hier waren nur Jobs mit SQL als Quelle betroffen. Behoben.
MySQL: vorzeichenbehaftete TINYINT-Spalten in Ganzzahlfelder: Der MySQL-Treiber liefert diese Spalten als SByte. Beim Schreiben in ein Ganzzahlfeld bei BC, NAV, Dataverse oder OpenAPI brach die Verarbeitung mit Source Type not yet implemented ab. Behoben.
Entwickler-Features
Diese Neuerungen betreffen nur die Entwicklung der DataBridge im Repository, nicht den Betrieb einer Instanz.
Lokale Podman-Testumgebung: dev/up.sh bzw. dev/up.ps1 startet die DataBridge aus dem aktuellen Quellcode zusammen mit Azurite und wahlweise MSSQL, PostgreSQL, MySQL und Oracle (dev/up.sh mssql oracle, dev/up.sh all). In jeder Datenbank werden dieselben Beispieltabellen Account, Opportunity und OpportunityProduct mit Testdaten angelegt, die möglichst viele Datentypen abdecken. Connections, Jobs für jede Datenbank-Kombination und Mappings werden automatisch erzeugt. Details: Entwicklung → Podman-Testumgebung.
HTTP-Mocks für Business Central, NAV und OpenAPI: Die Testumgebung kann zusätzlich einen WireMock-Container starten, der BC (OAuth), NAV (Basic) und eine OpenAPI-Beispiel-API (API-Key) nachbildet. Die Mocks sind einzeln wählbar und lassen sich mit Datenbanken mischen (dev/up.sh mssql bc openapi, all für alles). WireMock startet nur, wenn mindestens ein Mock gewählt ist. Er lädt nur die Regeln der gewählten Mocks. Die Regeln decken den ganzen HTTP-Ablauf der Konnektoren ab: Verbindungstest, $metadata bzw. Spezifikation, Lesen mit Paging, Upsert mit Lookup, PATCH oder POST, sowie Löschen. Jeder Mock bildet jetzt alle drei Beispieltabellen ab (Account, Opportunity, OpportunityProduct — zuvor nur Account); Connections, Jobs und Mappings SQL ↔ Mock werden für alle drei automatisch angelegt. Was die DataBridge gesendet hat, zeigt das Anfrage-Protokoll unter localhost:8089/__admin/requests. Details: Entwicklung → Podman-Testumgebung.
MCP-Server databridge-dev: Die .mcp.json enthält einen zweiten Server, der fest auf die lokale Testumgebung zeigt. So stehen in Claude Code Cloud-Instanz (databridge) und Testumgebung (databridge-dev) nebeneinander zur Verfügung. Details: Entwicklung → MCP für die Testumgebung.
Neuer Dokumentationsbereich „Entwicklung“ mit der Beschreibung beider Werkzeuge.
Architektur im Detail: Die bisher nur intern gepflegte technische Detaildokumentation (Systemkontext, Bicep-Module, DI und host.json, HTTP- und Nachrichten-Referenz, Sequenzdiagramme, Abhängigkeiten, Fähigkeiten-Katalog) ist überarbeitet, auf den Stand 2.3 gebracht und unter Entwicklung → Architektur im Detail veröffentlicht. Die Übersicht unter Überblick → Architektur verweist darauf. Nebenbei korrigiert: „Wie es funktioniert“ nannte einen Timer-Takt von zwei Minuten (tatsächlich 15 Sekunden) und beschrieb die Transitive-Queues als automatische Wiederholungs-Queue.
Service-Bus-Emulator, schaltbare Verarbeitung, Debug-Modus: Die Testumgebung hat jetzt einen Service-Bus-Emulator (Profil servicebus), damit Jobs auch lokal von Anfang bis Ende laufen können. GetChanges (Timer) und Process*QueueItems lassen sich einzeln zuschalten (dev/up.sh mssql process), und dev/up.sh --host (bzw. dev\up.ps1 -HostMode) startet die Umgebung ohne den databridge-Container, damit sich ein lokal laufender Prozess mit dem Debugger daran hängen lässt. Details: Entwicklung → Podman-Testumgebung und Entwicklung → Debuggen.
Web-Oberfläche für den Service-Bus-Emulator: Läuft automatisch mit, sobald das Profil servicebus aktiv ist (http://localhost:8090, Port über SERVICEBUS_EXPLORER_PORT konfigurierbar) — zeigt Queues, Nachrichtenzahlen und einzelne Nachrichten grafisch an. Community-Tool Service-Bus-Emulator-Explorer, nicht von Microsoft. Der klassische Service Bus Explorer funktioniert mit dem Emulator nicht. Details: Entwicklung → Debuggen → Gegen Podman.
Fix: dev/down.sh/dev/down.ps1 ließen Service-Bus- und databridge-Container zurück. Die beiden Skripte kannten nur die Datenbank- und wiremock-Profile, nicht die seit dieser Version existierenden Profile servicebus und databridge — ein Reset (down -v) räumte deshalb servicebus, servicebus-db, servicebus-explorer und den databridge-Container nicht mit auf. Behoben, indem beide Profile in die feste Profil-Liste aufgenommen wurden.
Azurite-Connection-String direkt aus up.sh/up.ps1: Die Start-Zusammenfassung gibt jetzt den vollständigen, einsatzbereiten Connection-String für den Azure Storage Explorer aus, statt nur UseDevelopmentStorage=true. Details zum Verbinden: Entwicklung → Podman-Testumgebung → Azurite einsehen.
Fix: docker build aus einem frischen Checkout schlug fehl. Das Dockerfile kopierte Directory.Packages.props nicht vor dem dotnet restore-Schritt, wodurch das zentrale Paket-Versionsmanagement (ManagePackageVersionsCentrally) ins Leere lief (NU1015). Betraf nur den lokalen Container-Build (dev/up.sh/dev/up.ps1, src/compose.yml); die produktive Auslieferung baut nicht über dieses Dockerfile. Behoben.
Fix: dev\up.ps1/dev\down.ps1 unter Windows. Nach einem podman machine stop blieb eine Socket-Datei liegen, an der beim nächsten Start win-sshproxy scheiterte. Ohne die Docker-API-Pipe brach danach jeder podman compose-Aufruf ab. Beide Skripte räumen die Datei jetzt vor dem VM-Start weg und warten, bis Compose die VM erreicht. down.ps1 -Reset startet eine gestoppte VM selbst, down.ps1 ohne -Reset endet bei gestoppter VM ohne Fehler. Unter Windows PowerShell 5.1 brach up.ps1 außerdem ab, weil Compose seinen Fortschritt auf stderr schreibt, und zeigte Umlaute verstümmelt an. Beides behoben; die Skripte laufen unter PowerShell 7 und 5.1. Details: Entwicklung → Podman-Testumgebung → Fehlersuche.
Doku-Website auf Docsy 0.18.0: Das Theme ist mit dem Umzug des Docsy-Projekts unter github.com/docsy/docsy erreichbar; der Hugo-Modulpfad, die Mermaid-Einstellung (jetzt ein Docsy-Plugin) und Dart Sass (1.105.0) sind angepasst. Inhalt und Darstellung der Seiten bleiben gleich.
Build bricht bei NuGet-Paketen mit bekannten Sicherheitslücken ab. NuGet Audit prüft jetzt alle Projekte inklusive transitiver Pakete, und Treffer ab Schwere „moderate“ gelten als Fehler statt als Warnung („low“ bleibt eine Warnung) — lokal, im Dockerfile und in der Pipeline. Details: Entwicklung → Architektur → Abhängigkeiten.
Bekannte Einschränkungen
OpenAPI – CheckList: Der Diagnose-Endpunkt meldet für OpenAPI-Mappings fälschlich „could not find table“. GetTableNames liefert die Pfade der Spezifikation (/v1/customers) statt der Ressourcennamen (customers). Das Lesen und Schreiben ist nicht betroffen.
OpenAPI – Primärschlüssel:get_connector_table_schema weist bei OpenAPI keinen Primärschlüssel aus. Intern erkennt der Konnektor ihn weiterhin am Property-Namen.
PostgreSQL/Oracle – CheckList: Der Diagnose-Endpunkt meldet für Mappings mit PostgreSQL- oder Oracle-Tabellen fälschlich „could not find table“. Der Vergleich der Tabellennamen berücksichtigt nicht, dass PostgreSQL Namen kleingeschrieben und Oracle großgeschrieben ablegt. Das Lesen ist nicht betroffen.
BC/NAV – Zeitstempel: In den Metadaten werden Edm.DateTimeOffset-Felder wie lastModifiedDateTime intern mit demselben Typnamen geführt wie Edm.Date. Das betrifft nur die interne Typkennzeichnung des Quellwerts; die Uhrzeit geht dabei nachweislich nicht verloren, da die Datums-Resolver den tatsächlichen Wert unabhängig von dieser Kennzeichnung parsen.
Installationshinweise
Update von ZIP-Paket bzw. Container-Image (containered-connector:v2.3.0). Keine neuen Azure-Ressourcen. Das Bicep-Deployment setzt im schlüsselbasierten Modus zusätzlich das App-Setting TARGET_BASED_SCALING_ENABLED=0. Bei einem reinen ZIP- oder Image-Update ohne erneutes Deployment fehlt es nur, dann bleibt die Warnung im Log, die Funktion ist davon nicht betroffen.
Die Metadaten der SQL-Connectoren liefern gegenüber früheren Vorabständen teils andere Typnamen (z. B. DateOnly statt DateTime für date-Spalten). Das betrifft nur die Ausgabe von get_connector_table_schema; das Lesen von Daten ändert sich dadurch nicht.
Breaking Changes & Migrationsschritte
Verhaltensänderung bei CE-Jobs: Ist der in TargetKey verwendete Alternativschlüssel in Dataverse nicht definiert oder nicht aktiv, landen Nachrichten ab 2.3 in der Dead-Letter-Queue, statt dass der Datensatz neu angelegt wird.
Vor dem Update für jeden CE-Zieljob mit CustomKey prüfen, dass der Alternativschlüssel in Dataverse existiert und aktiv ist (Power Apps → Tabelle → Schlüssel, Status „Aktiv“).
Nach dem Update die Dead-Letter-Queues beobachten. Nachrichten mit einem Schlüsselfehler nach dem Aktivieren des Schlüssels erneut einreihen.
Verhaltensänderung bei CE-Zielen unter Last: Fehler beim Nachschlagen eines Zieldatensatzes (z. B. Throttling durch die Dataverse-Service-Protection-Limits) werden nicht mehr verschluckt, sondern lösen eine Wiederholung der Nachricht aus. Bei stark ausgelasteten Umgebungen können deshalb mehr Wiederholungen und, wenn die Limits länger anhalten, Einträge in der Dead-Letter-Queue auftreten — bisher wurden in diesen Fällen still falsche oder unvollständige Daten geschrieben. Diese Nachrichten nach Abklingen der Last erneut einreihen.
Managed Identity nutzen (optional)
Die Identity muss im jeweiligen Zielsystem berechtigt werden, das Bicep-Deployment erledigt das nicht:
D365CE: Identity in der Dataverse-Umgebung als Anwendungsbenutzer anlegen und eine Sicherheitsrolle zuweisen.
D365BC: Identity in Business Central unter Microsoft-Entra-Anwendungen anlegen, aktivieren und Berechtigungssätze zuweisen.
Connection anpassen: für BC "authmethod": "ManagedIdentity" setzen, für CE url statt connectionstring verwenden.
7.2 - Release v2.2
Neuer generischer REST/OpenAPI-Connector, ein eingebauter MCP-Server für KI-Assistenten, Action-Jobs, System-assigned Managed Identity für die Function App sowie tolerantere Behandlung leerer Schlüssel im D365CE-Upsert.
Was ist neu
Neue Funktionen
Neuer Connector: generische REST-API über OpenAPI-Spezifikation: Neben BC, CE, NAV und den SQL-Connectoren steht jetzt ein generischer HTTP-Connector zur Verfügung, der ein beliebiges REST-API anhand seiner OpenAPI-/Swagger-Beschreibung anbindet (neuer Verbindungstyp OPENAPI). Damit lassen sich Systeme ohne eigenen Connector über ihr veröffentlichtes API-Schema anbinden, statt eine dedizierte Implementierung zu benötigen. Details, Konfigurationsbeispiel und unterstützte Auth-Methoden siehe OpenAPI-Connector.
Neue Authentifizierungsart „API-Key“ für HTTP-Connectoren: Zusätzlich zu Basic-Auth und OAuth2 unterstützen alle HTTP-basierten Connectoren (BC, NAV, OpenAPI) jetzt die Authentifizierung über einen statischen API-Key, der als Header an jede Anfrage angehängt wird (apiKeyHeader / apiKeyValue in der Connection). Zusätzlich kann der OAuth2-Token-Endpunkt über tokenUrl frei konfiguriert werden, statt fest auf den Microsoft-Login-Endpunkt zu zeigen — relevant für Systeme mit eigenem oder abweichendem Token-Server.
Action-Jobs (InvokeAction): Jobs können jetzt statt eines CRUD-Datenabgleichs eine einzelne benannte Aktion auf dem Zielsystem auslösen (z. B. eine OpenAPI-Action/operationId oder einen D365CE-OrganizationRequest). Ein solcher Job benötigt kein Mapping in der Mapping-Tabelle — die Aktion und ihre Parameter werden direkt aus der Queue-Nachricht und dem Job selbst gebildet. Siehe Action — welche Änderungsarten gelesen werden.
Ressourcenpfad direkt am Job konfigurierbar: Jobs können nun ihre Quell- und Zielressource (Tabelle, Entität oder Pfad) direkt in den neuen Job-Feldern Source/Target tragen, statt sie zwingend über die Mapping-Tabelle zu beziehen. Bestehende, ausschließlich über die Mapping-Tabelle konfigurierte Jobs funktionieren unverändert weiter; ohne Eintrag in Source/Target greift wie bisher die Mapping-Tabelle.
Kind-Datensätze einbetten (EmbedChildren, D365CE): Eine neue Source-Operation erlaubt es, die Datensätze eines referenzierten Kind-Jobs (z. B. Angebotspositionen zu einem Angebot) direkt in die Queue-Nachricht des Eltern-Datensatzes einzubetten, sodass beide gemeinsam in einer Anfrage beim Ziel ankommen. Der Filter des Kind-Jobs kann dabei über {{...%parent.Feldname%...}} auf Werte des Eltern-Datensatzes zugreifen.
Neue Diagnose-Endpunkte GET /job und GET /mapping: Zwei neue, rein lesende HTTP-Endpunkte (/job, /job/{rowKey}, /mapping, /mapping/{rowKey}) geben die aktuell geladene Job- bzw. Mapping-Konfiguration zurück — praktisch zur Fehlersuche, ohne direkt in der Table-Storage nachsehen zu müssen.
Eingebauter MCP-Server für KI-Assistenten (z. B. Claude Code, GitHub Copilot, Microsoft 365 Copilot): Ein neuer, rein lesender Model-Context-Protocol-Endpunkt (POST /api/mcp) macht Jobs, Mappings sowie Service-Bus-Diagnosedaten (Queue-Laufzeit-Status, non-destruktives Peek von Nachrichten und Dead-Letter-Nachrichten) als KI-Tools ansprechbar — dediziert dafür gibt es keinen eigenen HTTP-Endpunkt. Zwei der zehn Tools gehen noch einen Schritt weiter: list_connector_tables und get_connector_table_schema lesen die echten Tabellen-/Feld-Metadaten (Typ, Nullable, maximale Länge, Primary Key) direkt aus dem Quell-/Zielsystem einer Connection — für BC, NAV, CE (Dataverse) und OpenAPI —, sodass sich ein Mapping gegen das tatsächliche Schema validieren lässt, statt sich auf die Mapping-Konfiguration allein zu verlassen. Für die SQL-Connectoren (MSSQL, MySQL, Oracle, PostgreSQL) ist das noch nicht implementiert.
Die beiden Peek-Tools geben bewusst niemals den Nachrichteninhalt zurück, nur dessen Größe in Bytes (BodySize) — der Body kann fachliche Kunden-/Geschäftsdaten des jeweiligen Jobs enthalten, die Kopf-/Fehlerdaten (JobName, ErrorMessage, Stacktrace, Zustellversuche, …) reichen für die Diagnose. Die Tool-Beschreibungen selbst sind auf Englisch verfasst, da sie vom aufrufenden KI-Modell gelesen werden, nicht von einem Menschen. Details, Einrichtung (inkl. GitHub Copilot/VS Code und Microsoft 365 Copilot Studio), die vollständige Tool-Liste mit Lese-Umfang je Tool sowie die Funktionsweise: MCP-Server.
System-assigned Managed Identity für die Function App: Die Azure Function App erhält beim Deployment automatisch eine system-zugewiesene Managed Identity. Ihre Objekt-ID (principalId) steht als Deployment-Output (functionPrincipalId) für nachgelagerte Rollenzuweisungen zur Verfügung. Die Identity wird immer angelegt.
Optional (Preview): Storage & Service Bus über Managed Identity: Über den neuen Schalter enableManagedIdentity (Standard: aus) lassen sich die Verbindungen zu Storage und Service Bus von Schlüsseln auf identitätsbasierten Zugriff umstellen. Ist der Schalter aktiv, weist das Bicep-Deployment der Identity die nötigen Rollen zu (Storage Table/Blob/Queue, Service Bus Sender/Receiver/Data Owner — Data Owner wird für die Queue-Status-Abfrage des MCP-Tools list_queue_statuses benötigt) und die App-Settings verwenden AzureWebJobsStorage__accountName bzw. …__fullyQualifiedNamespace statt der Schlüssel-Verbindungszeichenfolgen.
Standardmäßig bleibt alles beim Schlüssel-basierten Zugriff — ein reines ZIP-/Image-Update ändert daran nichts. Die Umstellung erfolgt nur, wenn das Bicep-Script mit aktiviertem Schalter neu deployt wird (siehe Installationshinweise).
Leere Quell-Schlüssel gezielt ignorieren (IgnoreEmptySourceKey, D365CE): Ist das Quellfeld eines Ziel-Schlüssels leer, brach die Verarbeitung der Nachricht bisher immer mit einem Fehler ab — auch dann, wenn ein weiterer Schlüssel den Datensatz noch hätte finden können. Mit dem neuen Feld IgnoreEmptySourceKey am TargetKey (Standard: aus) lässt sich das je Schlüssel abschalten: Der betroffene Schlüssel wird übersprungen und die Suche läuft mit dem nächsten Schlüssel nach KeyRank weiter.
Das ist vor allem im Multikey-Szenario relevant, wenn ein optionales Feld wie eine externe ID nicht in jedem Quelldatensatz gefüllt ist, ein nachrangiger Schlüssel den Zieldatensatz aber sicher findet.
Findet kein Schlüssel einen Datensatz und waren alle leer gebliebenen Schlüssel entsprechend markiert, wird ein neuer Datensatz angelegt statt ein Fehler gemeldet. War auch nur einer der leeren Schlüssel nicht markiert, bleibt es beim Fehler. Details siehe IgnoreEmptySourceKey.
Bestehende Mappings sind nicht betroffen — ohne gesetztes Feld bleibt das bisherige Verhalten unverändert.
Fehlerbehebungen & Verbesserungen
Allgemein
sample.local.settings.json war kein gültiges JSON: Eine überzählige schließende geschweifte Klammer am Dateiende hätte beim Kopieren als Vorlage für local.settings.json zu einem sofortigen JSON-Parse-Fehler geführt. Behoben.
Das in v2.1 eingeführte Grafana-Dashboard wurde zweimal überarbeitet, zunächst:
Direkt aus der Azure Function erreichbar: Das Dashboard ist jetzt zusätzlich direkt von der Function App aus verlinkt und nicht mehr nur über die Ressourcengruppe auffindbar.
Erfolgsraten berücksichtigen den Zeitraum: Die vier Erfolgsraten-Anzeigen (GetChanges sowie die Verarbeitung nach Priorität) werten jetzt den im Dashboard gewählten Zeitraum aus, statt einen festen Standardzeitraum zu verwenden.
Neue Auswertung „GetChanges per Jobs": Eine zusätzliche Zeitreihe zeigt die erkannten Änderungen je Job im Zeitverlauf.
und in einem zweiten Durchgang deutlich erweitert:
Zwei neue Custom Metrics: MessagesProcessed (Dimensionen JobName, Outcome mit den Werten Success/Failed/Transitive) und ProcessingDurationMs (Dimension JobName) werden jetzt beim Verarbeiten jeder Queue-Nachricht getrackt — queue-übergreifend, da alle drei Prioritäts-Queues durch denselben Verarbeitungscode laufen. Details siehe Metriken.
Service-Bus-Anbindung: Zwei neue Kopfzeilen-Kacheln (Active Messages, Deadletter) zeigen die aktuell wartenden bzw. dead-letterten Nachrichten, summiert über alle drei Export-Queues — direkt aus den Azure-Monitor-Platform-Metriken des Service-Bus-Namespace, ohne eigene KQL-Abfrage.
Kombinierte Ansicht statt drei getrennter Queue-Zeilen: Ausführungen, Laufzeiten und Job-Aufschlüsselung der Queue-Verarbeitung (ProcessLowPriorityQueueItems/ProcessStandardQueueItems/ProcessHighPriorityQueueItems) laufen jetzt in einer gemeinsamen Zeile „ProcessQueueItems" statt in getrennten, queue-spezifischen Panels — inklusive einer neuen kombinierten Erfolgsraten-Kachel in der Kopfzeile.
Erfolg und Fehler je Job für die Queue-Verarbeitung: Zwei neue Zeitreihen-Panels („ProcessItems Success per Job", „ProcessItems Errors per Job") zeigen erfolgreiche bzw. fehlgeschlagene bzw. in eine Retry-Queue umgeleitete (Transitive) Nachrichten aufgeschlüsselt nach Job.
Zwei neue Dashboard-Filter: Die Variable Bin Size (5 Minuten bis 1 Tag, Standard 10 Minuten) steuert die Gruppierung aller Zeitreihen-Panels; die Variable Job Namen (Mehrfachauswahl, live aus den vorhandenen Jobs ermittelt) schränkt alle job-bezogenen Panels auf die gewählten Jobs ein. Beide gelten nicht für die Kopfzeilen-Kacheln und die Exceptions-Heatmap (siehe Grafana-Dashboard für die genaue Wirkung je Panel).
Fehler-Überblick als Heatmap: Das Exceptions-Panel wurde von einem Balkendiagramm auf eine Heatmap umgestellt.
Vollständig neu dokumentiert, inklusive der bekannten Grenzen (z. B. keine job-genaue
Erfolgsquote für GetChanges, keine Job-Filterung auf Exceptions): siehe
Grafana-Dashboard.
Das aktualisierte Dashboard wird beim nächsten Bicep-Deployment automatisch übernommen — es sind keine manuellen Schritte nötig. Neu ist dafür ein zusätzlicher Bicep-Parameter, der den Namen des Service-Bus-Namespace an das Dashboard-Modul durchreicht (serviceBusNamespaceName in modules/dashboard.bicep) — bei Deployment über die vorhandene main.bicep ist das bereits verdrahtet und erfordert keine Anpassung durch Administratoren.
D365CE (Dataverse)
Ausweichen auf den nächsten Schlüssel funktioniert bei leeren Schlüsseln: War bei mehreren Ziel-Schlüsseln der erste in der Quelle leer, lief die anschliessende Suche im Zielsystem auf einen unbehandelten Fehler — die nachrangigen Schlüssel kamen gar nicht mehr zum Zug, obwohl sie den Datensatz gefunden hätten. Die Schlüsselsuche behandelt diesen Fall jetzt sauber und arbeitet die Schlüssel wie vorgesehen der Reihe nach ab.
Oracle- und MySQL-Konnektor: Paging funktionierte nicht: Beide Konnektoren erzeugten für jede Seite ab der zweiten eine ungültige SQL-Abfrage und brachen mit einem Datenbankfehler ab. Betroffen waren ausschließlich Tabellen, die mehr Datensätze als die konfigurierte maxPageSize je Lauf lieferten. Beide Konnektoren erzeugen jetzt dialektkorrektes Paging (Oracle: OFFSET…FETCH NEXT, MySQL: LIMIT…OFFSET).
PostgreSQL-Konnektor: Job-Filter (und damit die Watermark) wurde beim Lesen ignoriert: Der Konnektor las unabhängig vom im Job hinterlegten Filter bei jedem Lauf die komplette Tabelle neu, statt nur die seit der letzten Watermark geänderten Datensätze. Der Filter wird jetzt wie bei den übrigen SQL-Konnektoren als WHERE-Klausel übernommen.
Abbruch bei Watermark-Spalten, die kein Datum sind: War die als WatermarkField konfigurierte Spalte kein DateTime-Typ (z. B. eine fortlaufende ID oder ein rowversion-Wert), brach der Lesevorgang beim ersten Datensatz ab. Der Wert wird jetzt auch bei anderen Spaltentypen sicher verarbeitet; als Watermark-Spalte empfohlen bleibt weiterhin ein echtes Datum, da davon auch die Sortierung der Änderungen abhängt.
Installationshinweise
Dieser Abschnitt richtet sich an Administratoren, die ein bestehendes System aktualisieren.
Ein reines ZIP-/Image-Update genügt — es sind keine manuellen Konfigurationsschritte erforderlich. Die Managed Identity wird beim nächsten Bicep-Deployment automatisch angelegt.
Der neue OpenAPI-Connector, Action-Jobs, die job-eigenen Source/Target-Felder sowie EmbedChildren sind rein additiv: Bestehende Connections, Jobs und Mappings sind nicht betroffen und laufen ohne Anpassung unverändert weiter. Es sind keine neuen App-Settings und keine Bicep-Änderungen erforderlich, um die neuen Funktionen bereitzustellen — sie werden erst durch entsprechende Einträge in den Konfigurationstabellen (connections, jobs, mappings) aktiv genutzt.
Das neue Mapping-Feld IgnoreEmptySourceKey ist optional: Ohne Anpassung der Mappings bleibt das Verhalten wie bisher. Soll es genutzt werden, wird es im TargetKey-JSON der betroffenen Mapping-Zeile ergänzt ("IgnoreEmptySourceKey": true) — ein Neustart der Function App ist dafür nicht nötig, die Konfiguration wird aus dem Table Storage gelesen.
Neue Azure-Ressourcen (Bicep)
System-assigned Managed Identity (Microsoft.Web/sites → identity): Wird beim Deployment der Function App aktiviert (identity.type = 'SystemAssigned'). Ihre Objekt-ID wird als Deployment-Output functionPrincipalId (aus dem Modul-Output principalId) ausgegeben und dient als Grundlage für nachgelagerte Rollenzuweisungen. Es entstehen keine zusätzlichen Kosten.
Managed Identity für Storage & Service Bus aktivieren (Preview)
Optional. Nur relevant, wenn Storage und Service Bus ohne Schlüssel betrieben werden sollen.
Schalter enableManagedIdentity (im Marketplace-Assistenten unter Product Settings → Preview, bzw. Bicep-Parameter) auf Ja/true setzen und das Bicep-Script neu deployen.
Owner oder User Access Administrator auf der Ressourcengruppe ist dafür erforderlich, da das Deployment Rollenzuweisungen anlegt.
Beim Deployment mit aktiviertem Schalter muss die Function-Version zur Bicep-Version passen (die neue Function-Version unterstützt beide Zugriffsarten; ältere Versionen erwarten die Schlüssel-Verbindungszeichenfolgen).
Der WEBSITE_CONTENTAZUREFILECONNECTIONSTRING-Content-Share bleibt weiterhin schlüsselbasiert (Azure Files unterstützt hier keine Identität).
Kurz nach der Aktivierung können durch die RBAC-Propagation vereinzelt transiente Authentifizierungsfehler auftreten; diese fangen sich beim nächsten GetChanges-Lauf automatisch.
Container-Image
Falls die DataBridge containerisiert betrieben wird, ist das Image auf den neuen Tag zu aktualisieren:
Die .NET-Basis bleibt unverändert (.NET 10, Isolated Worker) — es handelt sich lediglich um einen neuen Versions-Tag, kein Wechsel des Basis-Images.
7.3 - Release v2.1
Statische Schlüsselwerte, mehrere Ziel-Schlüssel, Sampling von Abhängigkeiten und ein mitgeliefertes Grafana-Dashboard.
Was ist neu
Neue Funktionen
Statische Schlüsselwerte für Lookups: Ein Lookup kann jetzt gegen einen fest hinterlegten Wert aufgelöst werden, ohne dass dafür ein Quellfeld existieren muss. Dazu wird im Schlüssel (Keyvalue) statt eines attributeName ein StaticValue angegeben. Nützlich, wenn ein Lookup immer auf denselben Zieldatensatz zeigen soll (z.B. eine feste Kategorie oder ein Standard-Datensatz).
Mehrere Ziel-Schlüssel je Mapping mit Rangfolge: Ein Table-Mapping bzw. ein Lookup kann nun mehrere Ziel-Schlüssel (TargetKeys) besitzen. Die Schlüssel werden anhand des neuen Felds KeyRank in aufsteigender Reihenfolge geprüft; sobald ein Schlüssel im Zielsystem einen Datensatz findet, wird dieser verwendet und die weiteren Schlüssel werden übersprungen. Damit lassen sich unterschiedliche Schlüssel gegen das CRM zulassen (z.B. zuerst eine externe ID, danach ersatzweise eine Nummer). Bestehende Mappings mit einem einzelnen TargetKey funktionieren unverändert weiter.
Automatische Anlage bei Lookups abschaltbar: Über die neue Option DoNotCreate am Lookup lässt sich steuern, dass ein nicht gefundener Ziel-Datensatz nicht automatisch angelegt wird. Ist die Option gesetzt, wird der Lookup nur aufgelöst, wenn der Datensatz bereits existiert — andernfalls bleibt das Feld leer, statt einen neuen Datensatz zu erzeugen.
String-zu-Decimal-Konvertierung: Der Decimal-Resolver akzeptiert jetzt auch Quellwerte vom Typ string und wandelt sie in einen Dezimalwert um (Interpretation im Format en-US, d.h. Punkt als Dezimaltrennzeichen). Leere Strings werden zu null, nicht konvertierbare Werte werfen wie bisher einen Fehler.
Vorab-Zwischenspeicherung von Lookups (Pre-Caching): Beim Verarbeiten eines Batches werden benötigte Lookup-Werte vorab gebündelt aufgelöst und zwischengespeichert. Dadurch werden wiederholte Einzelabfragen gegen das Zielsystem vermieden, was die Verarbeitung großer Änderungsmengen beschleunigt.
Sampling von Abhängigkeiten (Dependencies): Ausgehende Aufrufe an Quell- und Zielsysteme (D365 OData, SQL, Table Storage, Service Bus) werden von Application Insights automatisch als Abhängigkeiten erfasst und verursachten bisher den Großteil des Datenvolumens — bei minutengenauem Polling ein Vielfaches aller Log-Einträge zusammen. Diese Aufrufe werden nun gefiltert: Fehlgeschlagene sowie langsame Aufrufe werden immer vollständig gesendet, erfolgreiche und schnelle nur zu einem konfigurierbaren Anteil (Standard: 10 %). Das reduziert das tägliche Datenvolumen erheblich; Exceptions, Requests und alle Log-Einträge eines Fehler-Laufs bleiben unverändert vollständig erhalten. Steuerbar über die neuen Einstellungen TELEMETRY_DEPENDENCY_SAMPLE_RATE und TELEMETRY_DEPENDENCY_SLOW_MS; Details unter Betrieb → Logging.
Zu beachten
Die Entscheidung fällt pro Aufruf in dem Moment, in dem der Aufruf endet — nicht pro Funktionsausführung wie beim Logging. Ein fehlgeschlagener Lauf enthält daher zwar garantiert den fehlgeschlagenen Aufruf, nicht aber zwangsläufig die erfolgreichen Aufrufe davor. Wird dieser Verlauf für eine Analyse benötigt, ist vorübergehend TELEMETRY_CONTROL=TRACE_ALL zu setzen.
Grafana-Dashboard für Application Insights: Jede Installation legt jetzt automatisch ein vorkonfiguriertes Dashboard unter „Dashboards with Grafana" im Application-Insights-Blade an — mit Erfolgsraten je Funktion (GetChanges, Verarbeitung nach Priorität), Ausführungszahlen, Laufzeiten je Job sowie einer Übersicht der Exceptions nach Zeit und Typ. Das Dashboard wird ohne separate Aktivierung mit ausgeliefert.
Weitere Einstellungen bereits beim Deployment konfigurierbar: Der Cron-Ausdruck des GetChanges-Timers sowie alle vier Telemetrie-Sampling-Einstellungen (TELEMETRY_DEPENDENCY_SAMPLE_RATE, TELEMETRY_DEPENDENCY_SLOW_MS, TELEMETRY_INFO_SAMPLE_RATE, TELEMETRY_CONTROL) lassen sich jetzt direkt als Bicep-Parameter bzw. im Marketplace-Installationsassistenten setzen, statt sie nachträglich manuell in den App-Settings der Function App zu pflegen. Im Marketplace-Assistenten sind sie unter Product Settings in die Bereiche Function Settings, Telemetry, Alert und Preview gruppiert.
Fehlerbehebungen & Verbesserungen
Allgemein
Watermark wurde bei abweichend geschriebenem WatermarkType gelöscht: Der Typvergleich war zeichengenau. Ein in der Tabelle jobs von Hand eingetragenes DateTime statt datetime (oder ein versehentliches Leerzeichen) führte dazu, dass die gespeicherte Watermark des Jobs geleert wurde. Da die DataBridge bei leerer Watermark den Filter-Block vollständig entfernt, las der betroffene Job anschließend das komplette Quellsystem — und zwar bei jedem Lauf erneut, ohne Fehlermeldung oder Warnung. Der Typ wird nun ohne Beachtung von Groß-/Kleinschreibung und ohne umgebende Leerzeichen erkannt; ein tatsächlich unbekannter Typ lässt die gespeicherte Watermark unangetastet und erzeugt eine Warnung im Log. Siehe Installationshinweise — betroffene Jobs sollten nach dem Update geprüft werden.
Deutlich weniger Zugriffe auf die Watermark-Tabelle: Die Prüfung, welche Jobs laut Zeitplan fällig sind, holte für jeden aktiven Job eine eigene Abfrage aus der Tabelle watermark, obwohl dafür nur ein Zeitstempel benötigt wird. Diese Einzelabfragen sind durch eine gebündelte Abfrage ersetzt. Bei rund 220 aktiven Jobs sinkt die Zahl der Lesezugriffe von ~7.400 auf ~810 pro Stunde. Die Anzahl der Schreibzugriffe bleibt unverändert. Das entlastet Azure Table Storage und reduziert zusätzlich das Datenvolumen in Application Insights.
Watermark-Vergleich robuster: Drei Detailprobleme in der Watermark-Auswertung wurden behoben. Zeitstempel werden nun zeitzonenunabhängig verglichen — bisher wurde die Zeitangabe in die lokale Zeit des Servers umgerechnet, was beim Typ date über eine Tagesgrenze springen und das Vergleichsergebnis je nach Betriebsstandort verändern konnte. Fehlt ein Änderungsmarker, bleibt die Watermark unverändert stehen statt einen Abbruch auszulösen. Und eine fehlende Watermark-Spalte in der Tabelle führt nicht mehr zu einem leeren Rückschreibewert.
Validate-Funktion auf async umgestellt: Die Diagnose-Funktion Validate verwendete synchrone I/O (WriteString) sowie ein blockierendes .Wait()/.Result beim Warten auf die Initialisierung — beides ist mit dem ASP.NET Core-Modus nicht kompatibel. Sie ist jetzt vollständig auf async/await umgestellt.
Aussagekräftigeres Logging bei ExecuteHttpRequest: Bei ad-hoc HTTP-Anfragen werden jetzt der HTTP-Statuscode und der Antwortinhalt getrennt protokolliert, was die Fehlersuche bei fehlgeschlagenen Requests erleichtert.
Erweiterte Auswertungs-Abfragen für Abhängigkeiten und Kosten: Die Dokumentation enthält neue KQL-Abfragen für die langsamsten Abhängigkeiten, fehlgeschlagene Aufrufe nach Zielsystem sowie eine Volumenanalyse pro Tabelle zur Ursachensuche bei erreichter Daten-Obergrenze (Daily Cap). Siehe Betrieb → Logging.
BC & NAV
Statische Schlüsselwerte im BcConnector-Filter: Die Schlüssel- und Filtererzeugung des Business-Central-Connectors berücksichtigt nun ebenfalls statische Schlüsselwerte (StaticValue), sodass die neuen Lookup-Funktionen auch gegen D365 BC funktionieren. Zusätzlich wurde ein Fehler behoben, durch den Schlüsselwerte vom Typ string (z.B. Nummernfelder) ohne umschließende Anführungszeichen in den OData-Filter geschrieben wurden — ein mehrteiliger Schlüssel mit einem String-Anteil führte dadurch zu einer ungültigen Filterabfrage gegen BC. Der Filter wird nun für string-Werte korrekt in Anführungszeichen gesetzt.
Korrekte Fehlermeldung im NavConnector: Eine Fehlermeldung im NAV-Connector verwies fälschlich auf „BC-Communication" — sie lautet jetzt korrekt „NAV-Communication".
Installationshinweise
Ein Update auf v2.1 erfordert keine zwingenden Konfigurationsänderungen. Die neuen Mapping-Funktionen (statische Schlüsselwerte, mehrere Ziel-Schlüssel, DoNotCreate) werden ausschließlich über die Mapping-Konfiguration in Azure Table Storage aktiviert und sind für bestehende Mappings optional — ohne Konfigurationsänderung bleibt das bisherige Verhalten erhalten.
Empfohlen wird jedoch eine einmalige Sichtprüfung der Tabelle jobs (siehe unten) — sie deckt eine Fehlkonfiguration auf, die bisher unbemerkt zu Vollabzügen geführt haben kann.
Neue / geänderte App-Settings (Azure Function)
Beide Einstellungen sind optional. Ohne Konfiguration gelten die angegebenen Standardwerte, das Sampling von Abhängigkeiten ist also ab dem Update automatisch aktiv.
Einstellung
Typ
Standard
Beschreibung
Pflicht
TELEMETRY_DEPENDENCY_SAMPLE_RATE
Integer (0–100)
10
Prozentualer Anteil der erfolgreichen und schnellen Abhängigkeits-Aufrufe, die an App Insights gesendet werden. Fehlgeschlagene und langsame Aufrufe sind davon nicht betroffen.
Nein
TELEMETRY_DEPENDENCY_SLOW_MS
Integer (ms)
2000
Schwellwert, ab dem ein Aufruf als „langsam" gilt und immer gesendet wird — auch bei Erfolg.
Nein
Die bestehende Einstellung TELEMETRY_CONTROL wirkt nun zusätzlich auf Abhängigkeiten: TRACE_ALL deaktiviert auch deren Sampling, TRACE_NONE unterdrückt sie vollständig.
Diese beiden sowie die bereits bestehenden Einstellungen TELEMETRY_INFO_SAMPLE_RATE, TELEMETRY_CONTROL und GetChangesTimerExpression lassen sich ab dieser Version zusätzlich direkt beim Deployment setzen — als Bicep-Parameter (Beispielwerte in bicep/params/databridge.sample.bicepparam) oder im Marketplace-Assistenten unter Product Settings. Bei einem Update per Marketplace-Assistent führt ein erneuter Durchlauf zu keiner Änderung, solange die Standardwerte übernommen werden.
Neue Azure-Ressourcen (Bicep)
Grafana-Dashboard (Microsoft.Dashboard/dashboards + dashboardDefinitions): Vorkonfiguriertes Dashboard in Application Insights („Dashboards with Grafana"). Wird bei jedem Deployment fest mit angelegt, ohne Opt-out-Möglichkeit. Verursacht keine zusätzlichen Kosten; Abfragen laufen gegen die bestehende Application-Insights-Instanz.
Zu prüfen nach dem Update: WatermarkType in der Tabelle jobs
Die Tabelle jobs ist einmalig daraufhin durchzusehen, ob im Feld WatermarkType ein abweichend geschriebener Wert steht — erwartet werden datetime oder string. Abweichungen wie DateTime, Datetime oder ein führendes Leerzeichen haben bis einschließlich der Vorversion dazu geführt, dass der betroffene Job seine Watermark verlor und bei jedem Lauf das komplette Quellsystem las.
Nach dem Update ist der Fall auch ohne Prüfung erkennbar: Ein nicht erkannter Typ erzeugt eine Warnung mit Jobnamen und dem hinterlegten Rohwert im Log.
Was bei einem betroffenen Job zu erwarten ist: Ist die Watermark bereits geleert, führt der erste Lauf nach dem Update noch einmal einen Vollabzug durch. Danach wird die Watermark korrekt fortgeschrieben und der Job arbeitet wieder inkrementell. Es ist also kein manueller Eingriff nötig — lediglich einmalig mit erhöhter Last für diesen Job zu rechnen.
Hinweis zu bestehenden Auswertungen
Verworfene Abhängigkeiten werden vollständig entfernt und nicht über einen Hochrechnungsfaktor (itemCount) kompensiert. Bestehende Dashboards, Alerts oder KQL-Abfragen, die auf absoluten Zählungen oder Durchschnittslaufzeiten der Tabelle dependencies / AppDependencies basieren, liefern nach dem Update zu niedrige Werte und sind zu prüfen.
Besonders zu beachten sind Fehlerquoten über die Tabelle dependencies: Da fehlgeschlagene Aufrufe vollständig erhalten bleiben, erfolgreiche aber gesampelt werden, ist ein Ausdruck der Form countif(success == false) / count() nach dem Update deutlich überhöht. Solche Abfragen und darauf basierende Alerts sind zu entfernen oder auf die requests-Tabelle umzustellen, die keinem Sampling unterliegt.
Nicht betroffen sind:
Fehleranzahlen und Fehlerursachen — fehlgeschlagene Aufrufe werden nie verworfen
Auswertungen langsamer Aufrufe — diese werden ab dem Schwellwert immer gesendet
Requests, Exceptions, Traces und Custom Metrics — unverändert
Für belastbare Mengenangaben sind die vorab aggregierten Custom Metrics zu verwenden, die keinem Sampling unterliegen.
Container-Image
Falls die DataBridge containerisiert betrieben wird, ist das Image auf den neuen Tag zu aktualisieren:
Die .NET-Basis bleibt unverändert (.NET 10, Isolated Worker) — es handelt sich lediglich um einen neuen Versions-Tag, kein Wechsel des Basis-Images.
7.4 - Release v2.0
Umstellung auf .NET 10, Containerisierung mit Docker Compose, gepuffertes Logging und Custom Metrics.
Was ist neu
Neue Funktionen
Containerisierung mit Docker Compose: Die DataBridge kann nun direkt über docker compose (bzw. Podman) lokal gestartet werden. Eine neue compose.yml sowie eine Beispiel-Umgebungsdatei (.podman/podman.env.sample) sind enthalten. Das Start-Skript start-local.sh / start-local.ps1 baut den Container, startet ihn und gibt alle HTTP-Trigger-URLs inkl. Authentication-Key direkt aus.
Robustere Initialisierung in GetChanges: Die Timer-Funktion GetChanges initialisiert den CoreService jetzt threadsicher (Mutex-Pattern). Schlägt die Initialisierung fehl, wird sie beim nächsten Timer-Durchlauf automatisch erneut versucht (Self-Repair) — analog zu ProcessQueueItems.
ASP.NET Core HTTP-Integration: Die Azure Functions App nutzt nun das ASP.NET Core-Integrationsmodell (ConfigureFunctionsWebApplication). Dies ist die empfohlene Methode ab .NET 8+ und ermöglicht vollständigere HTTP-Features.
Custom Metrics: Die DataBridge sendet eigene, pre-aggregierte Metriken an Application Insights (Namespace DataBridge). Erste Metrik: ChangesDetected mit Dimension JobName — Anzahl erkannter Änderungen pro Job und GetChanges-Lauf, inkl. Null-Werten. Sichtbar im Metrics Explorer und in der Tabelle customMetrics; Details unter Betrieb → Logging.
Gepuffertes Logging mit selektiver App-Insights-Weiterleitung: Alle Log-Einträge einer Funktionsausführung werden zunächst im Arbeitsspeicher gepuffert und erst am Ende der Ausführung — abhängig vom Ergebnis — selektiv an Azure Application Insights gesendet. Im Fehlerfall stehen damit auch alle Debug-Einträge rückwirkend zur Verfügung, ohne dass sie bei erfolgreichen Läufen Kosten verursachen. Das Verhalten lässt sich über die Umgebungsvariablen TELEMETRY_CONTROL und TELEMETRY_INFO_SAMPLE_RATE steuern. Eine vollständige Beschreibung befindet sich unter Betrieb → Logging.
Trace-Level für Live-Diagnose: Log-Einträge auf Level Trace (LogTrace) werden nie an Application Insights gesendet — auch nicht bei Fehler-Läufen. Sie sind ausschließlich live sichtbar: lokal in der Konsole bzw. im Container-Log, in Azure im Log Stream der Function App. Details unter Betrieb → Logging.
Fehlerbehebungen & Verbesserungen
Allgemein
Korrekte Zeitstempel und Request-Zuordnung für gepufferte Traces: Gepufferte Log-Einträge tragen in Application Insights jetzt den Zeitpunkt des ursprünglichen Log-Aufrufs statt des Sendens am Invocation-Ende. Zusätzlich wird operation_ParentId gesetzt, sodass Traces in der End-to-End-Transaktionsansicht korrekt unter dem Request der Invocation eingeordnet werden statt als verwaiste Einträge zu erscheinen.
CheckList erkennt _-Felder korrekt: Die Diagnose-Funktion CheckList hat _-präfixierte Source-Felder (z.B. _wysa_address1_countryid) fälschlich als fehlende Attribute gemeldet. Diese Felder werden zur Laufzeit über SourceOperations aufgelöst und sind keine direkten Connector-Attribute — sie werden nun korrekt übersprungen.
HTTP-Funktionen auf async umgestellt: GetInfo, CheckList und ExecuteHttpRequest verwendeten synchrone I/O-Operationen (WriteString, .Wait()), die mit dem ASP.NET Core-Modus nicht kompatibel sind. Alle drei Funktionen sind jetzt vollständig auf async/await umgestellt.
Blockierendes Initialisierungsproblem in GetChanges behoben: Die bisherige Initialisierung blockierte den Thread (.Wait()). Dies wurde auf async/await umgestellt, womit Deadlocks unter Last verhindert werden.
Versionsverwaltung in der Pipeline zentralisiert: Major- und Minor-Version (2.0) werden nun zentral in der Pipeline-Datei gepflegt statt verteilt in den Build-Templates.
Automatischer Pipeline-Trigger: Die Build-Pipeline startet jetzt automatisch bei Push auf main und preview (vorher: nur manuell auslösbar).
Global-Artifact-Veröffentlichung nur von main: Das NuGet-Paket dsyr-databridge wird nur noch beim Build aus dem main-Branch veröffentlicht, nicht mehr aus preview.
NuGet-Pakete aktualisiert: Alle Abhängigkeiten wurden auf aktuelle Versionen angehoben (u.a. Azure.Identity 1.21, Microsoft.Data.SqlClient 7.0, MySql.Data 9.7, Npgsql 10.0.2, Oracle.ManagedDataAccess.Core 23.26.200).
Veraltete ARM-Templates entfernt: Legacy-ARM-Deployment-Profile und veraltete AppInsights-ARM-Dateien wurden aus dem Repository entfernt.
Docker-Build-Kontext bereinigt: Das .dockerignore wurde erweitert, sodass nur noch der tatsächlich benötigte Anwendungscode ins Image gelangt (.git/, docfx/, bicep/, cicd/, bruno/ und lokale Start-Scripts werden nun explizit ausgeschlossen).
BC
Duplikate bei HTTP-Fehlern verhindert: Beim Nachschlagen von Datensätzen (RetrieveRecordByKey, RetrieveRecordByFilter) wurde bei unerwarteten HTTP-Statuscodes bisher stillschweigend null zurückgegeben — das System legte daraufhin fälschlich einen neuen Datensatz an und erzeugte Duplikate. Beide Methoden werfen jetzt eine Exception mit dem konkreten Statuscode, wenn der Server weder Erfolg noch 404 zurückliefert.
Installationshinweise
Neue / geänderte App-Settings (Azure Function)
Folgende neue App-Settings stehen zur Verfügung. Beide sind optional — ohne Konfiguration gelten die dokumentierten Standardwerte.
Setting
Typ
Standard
Beschreibung
TELEMETRY_CONTROL
String
(leer)
TRACE_ALL sendet alle Log-Einträge unabhängig vom Ergebnis; TRACE_NONE unterdrückt alle Einträge; TRACE_SAMPLE entspricht dem Standardverhalten (selektives Sampling, wie leer)
TELEMETRY_INFO_SAMPLE_RATE
Integer (0–100)
20
Prozentsatz der Information-Einträge, die bei erfolgreichen Läufen an App Insights gesendet werden
Neue Azure-Ressourcen (Bicep)
Es wurden keine neuen Azure-Ressourcen hinzugefügt.
Breaking Changes & Migrationsschritte
Laufzeitversion auf .NET 10 aktualisieren
Die Azure Function App muss auf .NET 10 (Isolated Worker) aktualisiert werden.
Im Azure Portal: Function App → Konfiguration → Allgemeine Einstellungen → .NET-Version → 10 (LTS, Isolated)
Im Bicep-Script wird netFrameworkVersion automatisch auf 10.0 gesetzt — ein Redeployment über die Pipeline genügt.
Container-Image aktualisieren
Falls die DataBridge containerisiert betrieben wird: Das neue Image basiert auf .NET 10.
Tag: acrwysatest.azurecr.io/containered-connector:v2.0.0
Bestehende Images auf .NET 8 Basis sind nicht kompatibel und müssen ersetzt werden.
Build-Agent in eigenen Pipelines prüfen
Die offizielle Pipeline nutzt jetzt windows-2025 als Build-Agent. Eigene abgeleitete Pipelines sollten entsprechend angepasst werden.
7.5 - Ältere Releases
Migrationshinweise für die Übergänge 1.0 → 1.1 und 1.1 → 2.0.
Für die Versionen vor 2.0 existiert keine vollständige Release-Dokumentation. Überliefert
sind die Breaking Changes der jeweiligen Übergänge — sie sind hier unverändert festgehalten,
damit die Migrationshistorie nicht verloren geht.
Vor der Migration lesen
Wer von einer Version vor 2.0 aktualisiert, muss die Schritte aller dazwischenliegenden
Übergänge nacheinander durchführen — zusätzlich zu den Installationshinweisen aus
v2.0 und v2.1.
1.0 → 1.1
Breaking Changes:
Einführung von vier neuen Service-Bus-Warteschlangen:
sbqignored, sbqtransitivestandart, sbqtransitivelow, sbqtransitivehigh
Einführung der neuen Anwendungseinstellung SkipOutdatedMessages in der Azure Function;
beim Upgrade von 1.0 auf false zu setzen
Schreibweise der Queue-Namen
Der Name sbqtransitivestandart ist im Produkt genau so geschrieben (mit t am Ende)
und darf beim Anlegen der Warteschlange nicht „korrigiert" werden — sonst findet die
DataBridge die Queue nicht.